AI som körs på dina egna servrar.

Öppna modeller som Llama, Mistral och Qwen, serverade med vLLM eller Ollama på din hårdvara eller i ditt privata moln. Prompter, dokument och svar lämnar aldrig ditt nätverk, så dataskyddslagen i ditt land blir enkel att följa. Vi dimensionerar hårdvaran, bygger RAG över din interna data, finjusterar där det lönar sig och lämnar över ett system som ditt IT-team driver själva.

prompter eller dokument lämnar ditt nätverk
0 B
till en fungerande assistent på din egen data
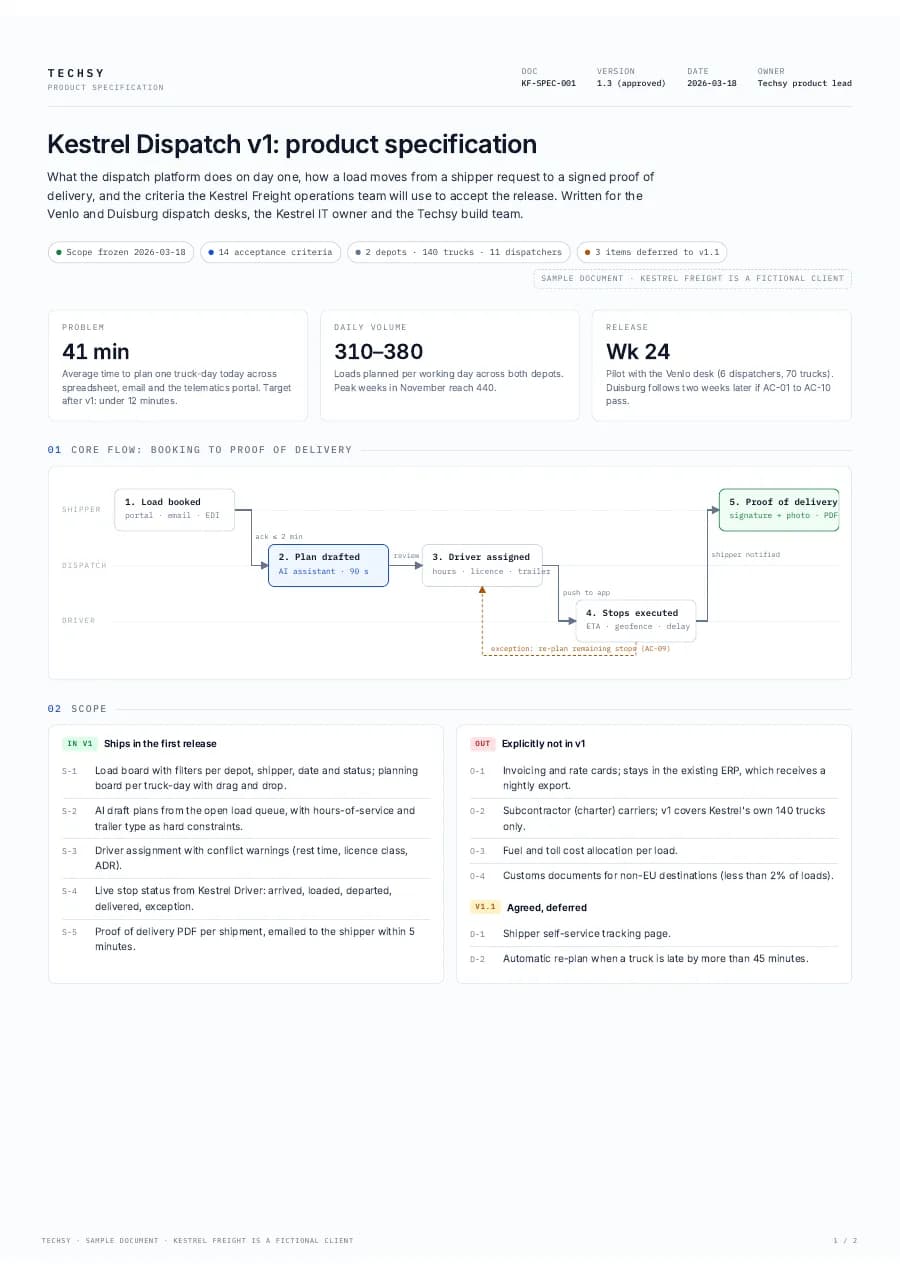
2–4 veckor
av modeller, vikter och kod på din hårdvara
100 %

Privat inferens

Körs på din hårdvara, utan internet

Llama 3.3 70B · vLLMgpu-01 · ditt datacenter

Fråga från Ekonomi

Sammanfatta leverantörsavtalet med Acme och lista uppsägningsklausulerna.

Hämtat ur interna dokument

  • contracts/acme-supply-2025.pdf · sidorna 3, 11
  • legal/termination-policy.docx · avsnitt 4

Svar

Svarstid 1,4 s

  • Treårigt leveransavtal från mars 2025, 60 000 enheter per kvartal till fast styckpris.
  • Båda parter kan säga upp avtalet med sex månaders uppsägningstid efter första året [1].
  • Omedelbar uppsägning tillåts vid väsentligt avtalsbrott som inte åtgärdats inom 30 dagar [1][2].

Data som lämnat nätverket0 B

Loggat i din auditlogg

CIO:er, CTO:er och dataansvariga kör lokal AI med oss.

Samma ingenjörer, samma process. Vilket användningsfall som går först beror på vem som frågar och vad policyn tillåter.

CIO / IT-chef

Före
Juridik sa nej till AI i molnet. Vår kunddata får inte lämna huset, så mina team använder antingen inget alls eller gör det i smyg.
Efter
En modell på dina egna servrar bakom din SSO, där varje prompt loggas. Dina team får assistenten de redan ville ha, och datakartan i dokumentationen svarar revisorn.

0 Bdata lämnar ditt nätverk
CTO / Utvecklingschef

Före
Vi betalar per token för ett API, fakturan växer varje månad, och vi får ändå inte skicka kunduppgifter dit.
Efter
En dimensioneringstabell med din verkliga kostnad per token på egna GPU:er, sedan en inferensstack som ersätter API:et bakom en gateway. Samma anrop från din kod, ingen faktura per token, och kunduppgifter är tillåtna.

2–4 veckortill första användningsfallet live

Datachef / Driftchef

Före
Våra dokument är på tyska och turkiska och fulla av våra egna termer. Generiska modeller svarar dåligt på dem.
Efter
RAG över dina dokument på deras egna språk, en finjustering på dina exempel när utvärderingarna visar en vinst, och svar med källsidan bifogad. Mätt på dina riktiga frågor före lanseringen.

100 %av vikterna och koden är dina

Vi bygger, testar och lämnar över lokal AI på din hårdvara.

  • 01

    Inferensstacken

    vLLM eller Ollama som serverar en öppen modell, en gateway med samma API-format som din kod redan anropar, GPU-schemaläggning, cache och övervakning. På en server, ett kluster eller i ditt privata moln.

  • 02

    RAG över din interna data

    Kopplingar till dina filservrar, wikis, databaser och ärendesystem. Embeddings och index stannar lokalt, sökningen följer dina åtkomstregler, och varje svar hänvisar till dokument och sida.

  • 03

    Finjustering där det lönar sig

    En LoRA-finjustering på dina egna exempel när utvärderingarna visar en vinst: ditt format, ditt ordförråd, dina språk. Tränad på din hårdvara; vikterna är dina.

  • 04

    Hårdvarudimensionering och driftmanualen

    En dimensioneringstabell med kostnad per token, GPU-planen, failover och backup, och en driftmanual ditt IT-team använder för att uppdatera modeller, rulla tillbaka och läsa övervakningen.

Ingår utan kostnad

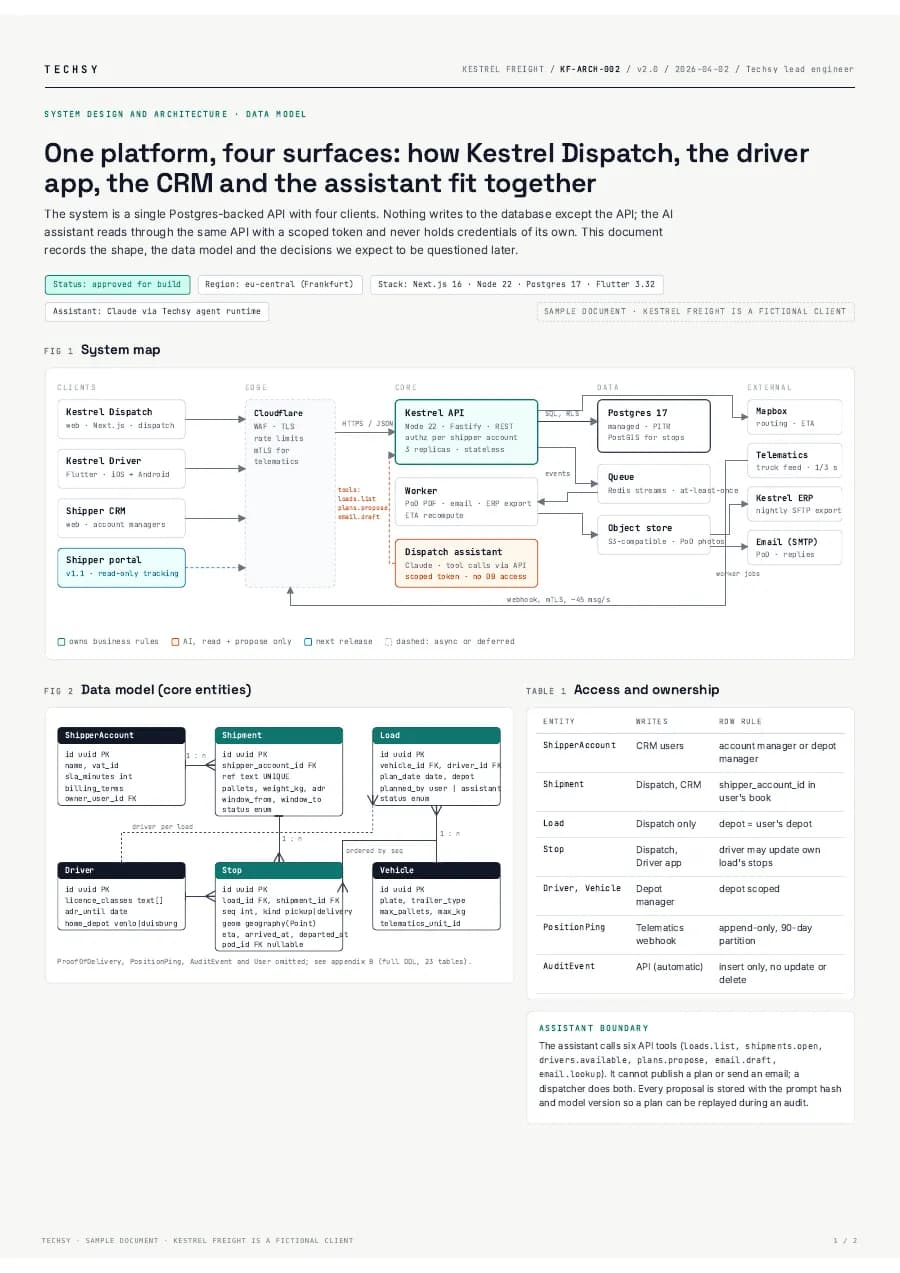
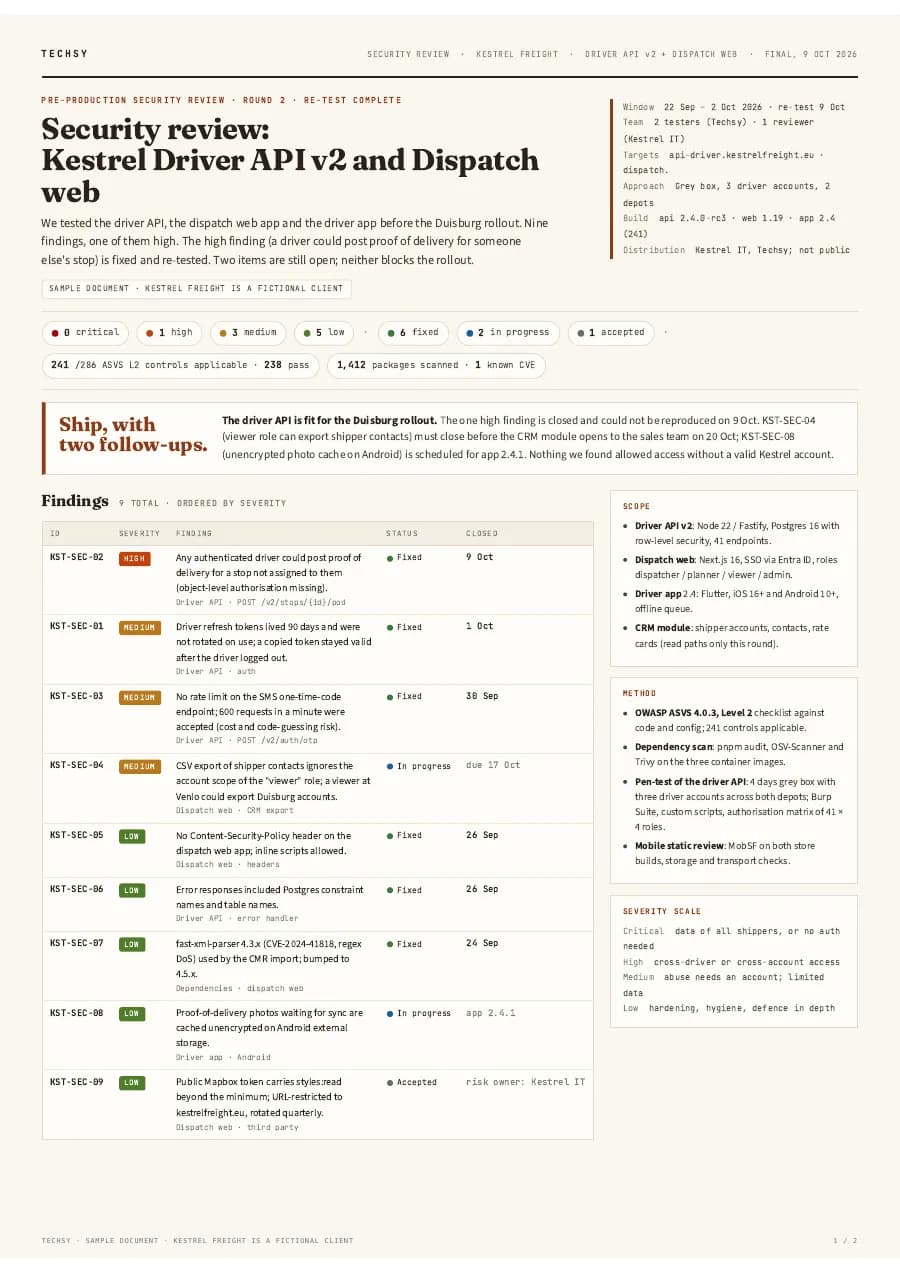
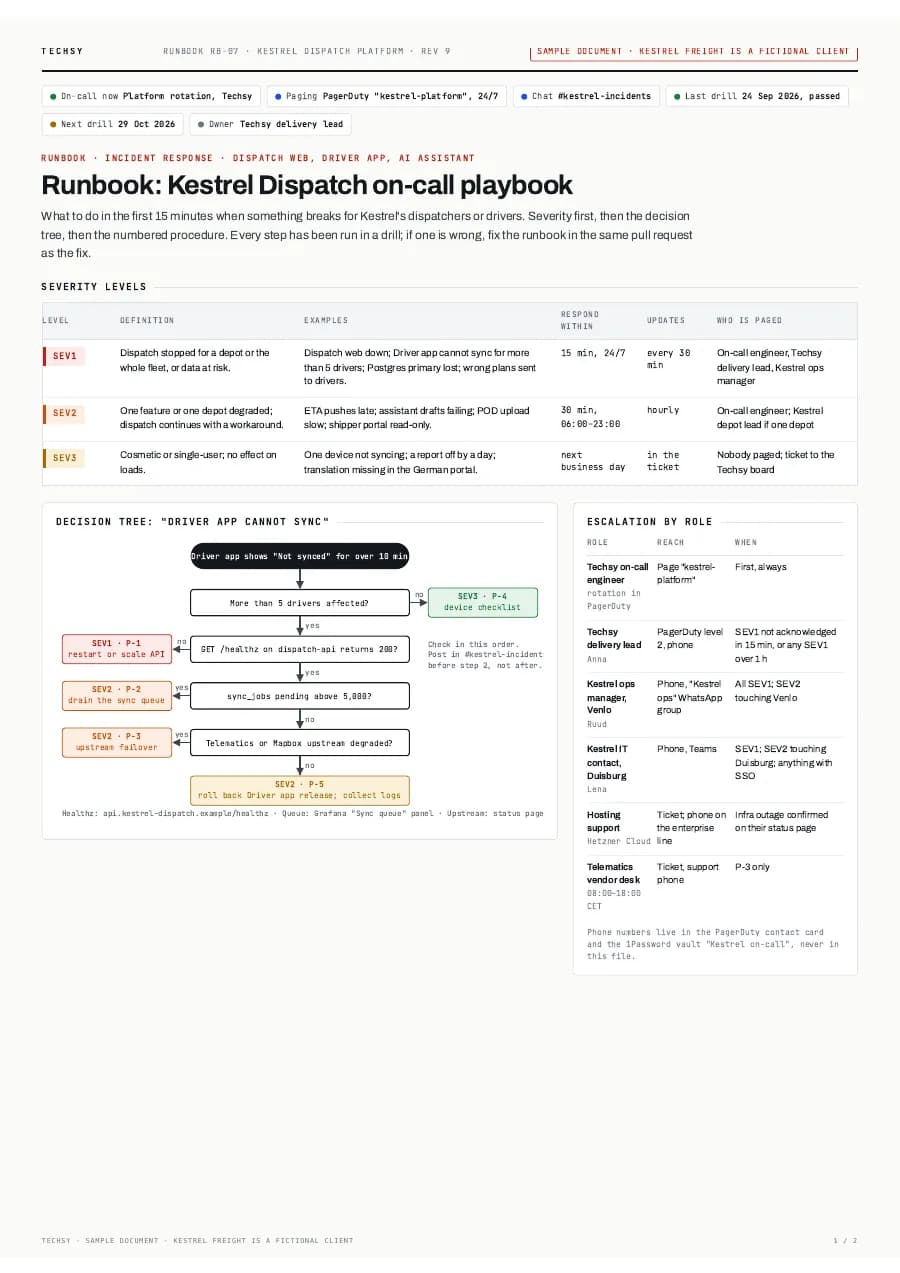
5 dokument ingår i startpaketet.

Samma mapp som du ser på prissidan. Öppna vilket som helst för att läsa en exempelsida först.

Alla dessa dokument ingår utan kostnad i paketet; inget av dem blir en extra rad i planen.

  • Behöver du något mer?Säg till. Vi lägger till det i ditt paket, utan kostnad.

Ditt första användningsfall med lokal AI körs inom två till fyra veckor.

Du tar med användningsfallet, dokumenten och en timme i veckan. Vi dimensionerar, bygger, mäter och lämnar över, och ditt IT-team är med i varje steg från första servern.

  1. 01

    Vecka 1

    Första mötet och dimensionering

    Vi
    Håller ett kostnadsfritt första möte om användningsfallen och datan. Skriver sedan en researchrapport: datakarta, kortlista på modeller, hårdvarudimensionering med kostnad per token och ett fast pris.
    Du
    Godkänner planen och betalar 50 %. Beställer hårdvaran, eller pekar oss mot det privata moln du redan har.
  2. 02

    Vecka 2–3

    Pilot på ett användningsfall

    Vi
    Serverar modellen på din första nod, kopplar en dokumentkälla, bygger RAG med källhänvisningar och skriver utvärderingarna utifrån dina riktiga frågor.
    Du
    Ger oss 50 till 100 riktiga frågor med de svar du förväntar dig.
  3. 03

    Vecka 3–6

    Härda och utöka

    Vi
    SSO och åtkomstregler, loggen över prompter och svar, övervakning, failover och backuper. Finjusterar om utvärderingarna visar en vinst. Lägger till nästa användningsfall.
    Du
    Går igenom utvärderingsresultaten med oss och godkänner trösklarna.
  4. 04

    Lansering

    Överlämning till din IT

    Vi
    Driftmanual, utbildning för ditt IT-team, och resterande 50 % vid leverans. Större plattformar tar upp till tre månader på samma villkor.
    Du
    Driver det själv, eller behåller oss på en månadsplan för modelluppdateringar och nya utvärderingar.

Börja med en privat assistent. Väx till en privat AI-plattform.

Tre paket, vart och ett till ett fast pris som ni ser innan ni bestämmer er. Varje paket bygger på det förra, så inget slängs.

  1. 01

    Första mötet

    30 minuter, kostnadsfritt

    Du beskriver användningsfallet och var datan finns. Vi säger vilken modell och hårdvara som passar, vad startpaketet kostar och vad API-fakturan skulle bli i stället.

  2. 02

    Privat AI-assistent

    Live på 2 till 3 veckor

    En öppen modell på er egen server. Inget lämnar ert nätverk.

  3. 03

    Privat kunskapsbas

    Live på 3 till 5 veckor

    Era dokument sökbara med AI, helt inom ert nätverk.

  4. 04

    Privat AI för företaget

    Live på 6 till 10 veckor

    Flera avdelningar på en privat AI-plattform.

Lokal AI körs på dina servrar, med inloggning via din SSO.

Vi bygger på den hårdvara och de konton du redan äger, loggar in användarna via din SSO och skickar mätvärden till den övervakning du redan följer.

Allt annat med ett API: vi skriver kopplingen och lämnar över koden till dig.

Privat moln

  • AWS
  • Google Cloud
  • Azure
  • Cloudflare

Identitet och åtkomst

  • Okta
  • Microsoft Entra ID
  • Auth0

Datakällor

  • PostgreSQL
  • Supabase
  • Notion
  • SAP
  • Dynamics 365
  • Odoo

Övervakning

  • Grafana
  • Datadog
  • Sentry
  • Elastic

Använd med vilket AI-verktyg som helst.

Agenterna, skills och koden vi lämnar över fungerar i verktygen ert team redan använder.

  • Codex
  • Claude
  • Cursor
  • Grok
  • Z.ai
  • Hermes
  • OpenClaw
  • Eve
  • Mistral
  • OpenCode
  • VS Code
  • Antigravity
  • Windsurf
  • JetBrains
  • Zed
  • GitHub Copilot
  • Cline
  • Qwen
  • Amp
  • Goose
  • Lovable
  • Replit
  • v0

Ditt paket för lokal AI har ett fast pris.

  • Lägsta pris

    Privat AI-assistent

    En öppen modell på er egen server. Inget lämnar ert nätverk.

    4 500 US$

    3 000 US$

    Från-pris · engångsbetalning

    • 5 dokument, gratis
    • En öppen modell, som Llama eller Qwen, på er server
    • Teamchatt med inloggning
    • Er data skickas aldrig till en extern AI-leverantör
    • Dimensionering av hårdvara och installationsguide
    • En säkerhetsgranskning av installationen
  • Mest populär

    Mellanklass

    Privat kunskapsbas

    Era dokument sökbara med AI, helt inom ert nätverk.

    12 000 US$

    8 000 US$

    Från-pris · engångsbetalning

    Allt i Privat AI-assistent, plus:

    • Era dokument kopplade, med behörigheter
    • Svar med sina källor
    • Single sign-on med era företagskonton
    • Kvalitetstester på era egna frågor
    • Övervakning och en uppdateringsplan
  • Toppklass

    Privat AI för företaget

    Flera avdelningar på en privat AI-plattform.

    30 000 US$

    20 000 US$

    Från-pris · engångsbetalning

    Allt i Privat kunskapsbas, plus:

    • Flera avdelningar, var och en med egen data och egna regler
    • GPU-dimensionering för er last
    • Ett API för era andra system
    • Granskningsloggar och åtkomstrapporter
    • Kvalitetstester vid varje modelluppdatering

Ditt första möte med Techsy är kostnadsfritt.

Efteråt vet du vad du behöver.

  • Första mötet kostar ingenting.
  • Researchrapporten är också kostnadsfri.
  • 25 % tillbaka om du avbryter inom 28 dagar.
Så går ett projekt med Techsy till, steg för steg
  1. Kostnadsfritt första möte: Trettio minuter med någon som bygger.
  2. Planering: Omfattning, faser och datum, skriftligt.
  3. Research och dokument: En gratis researchrapport och specarna.
  4. Lösning och nytta: Vad vi bygger och vad ni sparar.
  5. Utveckling: Byggt i korta, synliga cykler.
  6. Lansering: Live, övervakat och överlämnat.

Det här frågar team innan de kör AI på egna servrar.

Kostnad, modeller, hårdvara, integritet och vem som håller det igång. Frågorna vi hör på varje första möte.

  • Tre paket. Privat AI-assistent för 3 000 US$ sätter en öppen modell med teamchatt på er egen server. Privat kunskapsbas för 8 000 US$ lägger till era dokument med behörigheter, källor och single sign-on. Privat AI för företaget för 20 000 US$ betjänar flera avdelningar, med GPU-dimensionering, API och granskningsloggar. Ni betalar 50 % när ni godkänner planen och resten vid leverans. Hårdvaran köps i ert namn; vi dimensionerar den och anger kostnaden per token innan ni beställer.

  • Modeller med öppna vikter: Llama, Mistral, Qwen, Gemma, DeepSeek och mindre specialmodeller för embeddings, reranking och klassificering. Vi väljer per användningsfall utifrån utvärderingsresultat, svarstid och den hårdvara du har. En modell på 7B till 14B på en GPU klarar de flesta dokument- och supportuppgifter; en 70B-modell kräver en nod med flera GPU:er. Varje modellanrop går genom en gateway, så att byta modell senare är en konfigurationsändring, inte en ombyggnad.

  • Det beror på modellen och hur många som använder den samtidigt. En enda server med en eller två datacenter-GPU:er serverar en 14B-modell till några hundra användare. En 70B-modell vill ha fyra till åtta GPU:er. Har du redan GPU-kapacitet, i ett privat moln eller på en arbetsstation, börjar vi där. Researchrapporten innehåller en dimensioneringstabell med kostnad per token, så att du kan jämföra med API-fakturan du betalar i dag.

  • Det tar bort den svåraste delen: inga personuppgifter lämnar din infrastruktur, så det finns inget tredjepartsbiträde, ingen överföring utanför ditt land och ingen leverantör som tränar på dina prompter. Vi lägger till det revisorerna frågar efter: åtkomstregler knutna till din SSO, en logg över varje prompt och svar, gallringsregler och en datakarta i dokumentationen. Din juridikavdelning äger fortfarande policyn; vi ser till att det tekniska svaret på varje fråga blir ja.

  • På allmän kunskap ligger frontier-API:erna före. På dina dokument, dina termer och ditt språk matchar eller slår en lokal modell med bra retrieval och en liten finjustering dem oftast, eftersom svaret kommer ur din data och inte ur modellens minne. Vi ber dig inte lita på det: före lanseringen kör vi utvärderingar på ett urval av dina riktiga frågor och visar resultaten sida vid sida.

  • Börja med RAG. Det lägger rätt dokument framför modellen, ger dig källhänvisningar och täcker de flesta användningsfall på egen hand. Finjustering lönar sig när modellen måste lära sig en stil, ett format eller ett fackspråk, som tyskt avtalsspråk eller turkiska redovisningstermer. Vi föreslår det bara när utvärderingarna visar en tydlig vinst, och vi kör det på din hårdvara med dina exempel.

  • Ditt IT-team kan göra det, med driftmanualen vi lämnar över: hur man uppdaterar en modell, rullar tillbaka, lägger till en GPU, läser övervakningen och återställer från backup. Många kunder behåller oss i stället på en månadsplan: vi håller modeller, drivrutiner och inferensstacken aktuella, kör om utvärderingarna när din data ändras och bevakar GPU-användning och svarstider. Oavsett vilket är systemet ditt och körs utan oss.

  • Det första mötet är kostnadsfritt. Inom en vecka har du en researchrapport med användningsfallen, datakartan, hårdvarudimensioneringen och ett fast pris. Du godkänner planen och betalar 50 %. Ett första användningsfall är live på din hårdvara på två till fyra veckor; en komplett plattform med flera användningsfall, SSO och finjustering tar upp till tre månader. Resterande 50 % betalas vid leverans, när utvärderingarna har klarat de trösklar vi kommit överens om.

Hittade du inte ditt svar?

Fråga en människa

Bygg systemet som hela din verksamhet vilar på.

Boka ett scoping-samtal, så kartlägger vi bygget, kostnaden och tidsplanen. De flesta team går ut ur det första samtalet med en fast plan.

Tre snabba frågor, sedan ser du prisspann och tidsplan. Inget samtal behövs.