Grok 4.7 vs Grok 4.6: Samme $2/$6, og tavlen splitter etter jobb
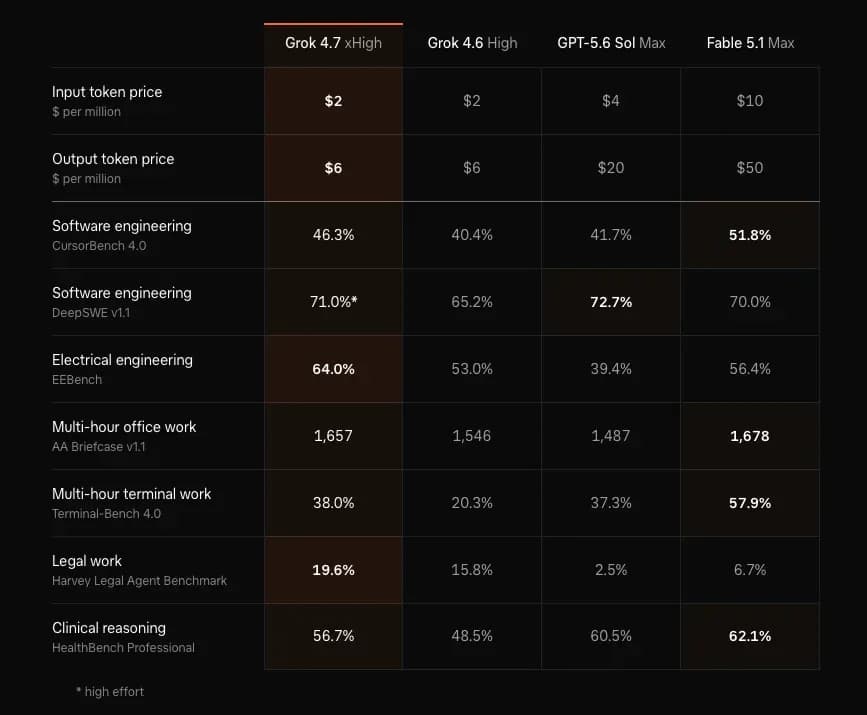
Grok 4.7 ble lansert 21. september 2026 til $2 per million input-tokens og $6 per million output, samme prisliste som Grok 4.6. På SpaceXAIs egen tavle vinner 4.7 hver rad mot 4.6, men taper fire av de sju radene til Fable 5.1 Max. Vi lagret begge diagrammene fra lanseringssiden og sendte 12 graderte kall gjennom OpenRouter 22. september, 14:51 til 14:53 UTC.
Hvor Grok 4.7 faktisk slår Grok 4.6
Rut elektrisk arbeid, juridisk agentarbeid og terminalarbeid til Grok 4.7, og la kliniske oppgaver ligge på Fable 5.1 eller GPT-5.6 Sol.
Hvert tall i lederkolonnen er hentet fra lanseringsinnlegget 21. september, hentet 22. september 2026. Siste rad er vår.
| Jobb | Leder på raden | Grok 4.7 | Ruting |
|---|---|---|---|
| EEBench | Grok 4.7 xHigh | 64,0 % | Grok 4.7 |
| Harvey, juridisk agent | Grok 4.7 xHigh | 19,6 % | Grok 4.7, og si til brukeren at 80,4 % fortsatt bommer |
| Terminal-Bench 4.0 | Fable 5.1 Max, 57,9 % | 38,0 % | 4.7 når du forlater 4.6; Fable når scoren er produktet |
| CursorBench 4.0 | Fable 5.1 Max, 51,8 % | 46,3 % | Fable, med mindre output til $6 slår et gap på 5,5 poeng |
| DeepSWE v1.1 | GPT-5.6 Sol Max, 72,7 % | 71,0 % på high, ikke xHigh | Sol, eller 4.7 hvis 1,7 poeng ikke er verdt output til $20 |
| AA Briefcase v1.1 | Fable 5.1 Max, 1 678 | 1 657 | Fable med 21 Elo, eller 4.7 når output-regningen dominerer |
| HealthBench Professional | Fable 5.1 Max, 62,1 % | 56,7 % | Fable eller Sol (60,5 %), ikke 4.7 |
| Fire korte kall, våre | Uavgjort | 4/4 | Behold klienten du har |
Grok 4.6 High ligger under 4.7 på alle de sju publiserte radene. Det er hele grunnen til å forlate modellen du allerede kjører. Det er ikke en grunn til å forlate Fable på editoroppgaver, kontorarbeid, terminalarbeid eller kliniske oppgaver.
Hva SpaceXAIs to diagrammer måler
Den oransje søylen er xHigh, API-standard er high, og 71,0 % på DeepSWE er merket high.
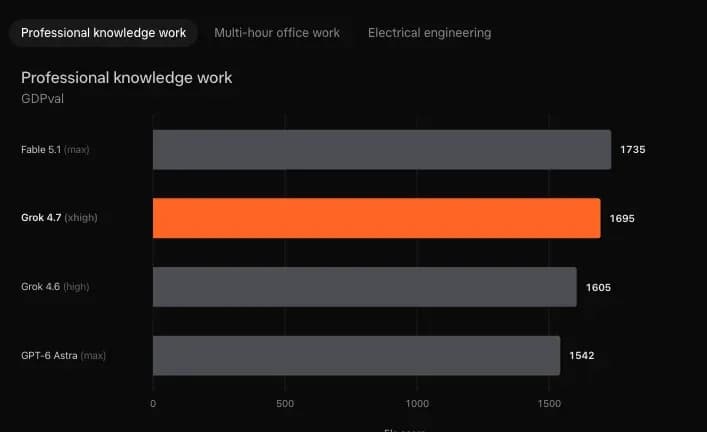
GDPval setter Fable 5.1 max på 1 735 Elo, Grok 4.7 xhigh på 1 695, Grok 4.6 high på 1 605 og GPT-6 Astra max på 1 542. Det er +90 Elo mot 4.6, 40 Elo bak Fable og 153 Elo foran Astra. OpenAI-navnet på dette diagrammet er Astra. OpenAI-navnet på resultattavlen er GPT-5.6 Sol Max. De er ulike modeller, og lanseringssiden bruker begge.
- Les den oransje søylen som xHigh. docs.x.ai setter standard-effort til high.
- Les 71,0 % som effort-nivået high. Asterisken sitter på den DeepSWE-cellen og på ingen annen Grok 4.7-celle.
- Behold Astras 1 542 på Elo-diagrammet. Ikke lim tallet inn i kolonnen til Sol.
Artificial Analysis deler gevinsten på kontorarbeid i to. På AA-Briefcase gikk analytisk kvalitet fra 1 690 Elo på Grok 4.6 high til 1 994 på Grok 4.7. Presentasjonskvalitet gikk fra 1 519 til 1 499. Dokumentene ble skarpere i analysen og litt dårligere som dokumenter.
CursorBench er suiten til Cursor. SpaceX ble enige om å kjøpe Cursor-skaperen Anysphere for $60B i aksjer 16. juni 2026.
Grok 4.7 ligger på API-et som grok-4.7, i Cursor og som standardmodell i Grok Build. Innlegget 12. august om Grok 4.6 vs Grok 4.5 sa at 4.7 ikke var lansert ennå. Den setningen var sann 12. august. Den sluttet å være sann 21. september.
Hva $2 og $6 utelater fra prislisten
En prompt på 250 000 tokens faktureres til $4 og $12, på hvert token i forespørselen.
Diagrammet viser $2 og $6. Modellsiden viser to rader. Under 200 000 prompt-tokens er satsene $2 input, $0.50 cachet input og $6 output. Ved 200 000 eller over settes hele forespørselen til $4, $1 og $12.
prompt, output = 250_000, 2_000
chart_rate = prompt / 1e6 * 2 + output / 1e6 * 6     # $0.512
cliff_rate = prompt / 1e6 * 4 + output / 1e6 * 12    # $1.024
Krysser du streken, dobles en regning som diagrammet aldri viser. $0.512 blir $1.024. Tokenene under 200 000 beholder ikke den billige satsen.
Input til $2 er halvparten av $4 hos GPT-5.6 Sol og en femtedel av $10 hos Fable 5.1. Output til $6 er 3,3× billigere enn $20 hos Sol og 8,3× billigere enn $50 hos Fable. Per output-dollar blir det 166 667 tokens på Grok, 50 000 på Sol og 20 000 på Fable. «Halv pris» treffer input-raden mot Sol. Den treffer ingen av output-radene.
Cachet input holder seg på $0.50 per million under 200 000 tokens, samme tall som Grok 4.6, deretter $1 ved knekkpunktet. Hvordan den cache-linjen treffer en ekte faktura er temaet i guiden om inferenskostnad.
Grok 4.7 Fast er en egen bryter: dobbel output-hastighet til dobbel tokenpris, inne i Cursor og Grok Build. Det er ikke knekkpunktet ved 200 000 tokens, og det offentlige API-et selger det ikke.
Artificial Analysis målte lange prompter til omtrent 188 tokens per sekund og omtrent 7,1 minutter per Intelligence Index-oppgave. Medianen på våre korte kall var 5,02 sekunder for Grok 4.7 high, mot 8,12 sekunder for Grok 4.6 high. Ingen av tallene er en påstand om 2× hastighet mot Fable eller Sol.
Hva 12 Grok 4.7-kall returnerte 22. september
Tolv kall scoret 12/12, og xhigh ga tilbake de samme fire svarene som high.
Samme fire prompter, temperatur 0, max_tokens 4000, ett forsøk hver, ingen verktøy. Grok 4.6 på high, Grok 4.7 på high, Grok 4.7 på xhigh. Gatewayen var OpenRouter, samme oppsett som i sammenligningen av LLM-gatewayer. Rå usage-objekter ligger i benchmark-raw.json ved siden av dette innlegget. OpenRouters usage.cost for de tolv kallene summerte til $0.029279.
{
  "model": "x-ai/grok-4.7",
  "temperature": 0,
  "max_tokens": 4000,
  "reasoning": {"effort": "xhigh"},
  "messages": [{"role": "user", "content": "..."}]
}| Oppgave | Forventet | 4.6 high | 4.7 high | 4.7 xhigh |
|---|---|---|---|---|
| Median av 3, 1, 4, 1, 5, 9 | 3,5 | 3,5; 6,17 s; 348 tok | 3,5; 5,42 s; 359 tok | 3,5; 4,67 s; 300 tok |
| 2,2 kΩ ved 5 mA | 11 V | 11; 8,06 s; 511 tok | 11; 4,62 s; 273 tok | 11; 5,31 s; 348 tok |
| Prøv på nytt ved 429 og 503, aldri 500 | 429,503 | 429,503; 78,30 s; 451 tok | 429,503; 3,37 s; 216 tok | 429,503; 2,07 s; 87 tok |
count_passed([59, 60, 100, 0]) med løkken som starter på indeks 1 | 2 | 2; 8,18 s; 466 tok | 2; 6,10 s; 409 tok | 2; 5,16 s; 368 tok |
Completion-tokens falt fra 1 776 på Grok 4.6 high til 1 257 på Grok 4.7 high og 1 103 på xhigh. Reasoning-tokens, som inngår i de completion-tallene, var 1 543, deretter 1 052, deretter 944. OpenRouter-fakturaen fulgte med: $0.012258, deretter $0.008877, deretter $0.008144. Det er 29,2 % færre completion-tokens på high og 27,6 % mindre på regningen. Begge modellene fullførte testen 4/4.
prompt_tokens på Grok 4.7 kom tilbake nøyaktig 1 036 over det tilsvarende kallet til Grok 4.6 på high: 1 311 mot 275, 1 288 mot 252, 1 295 mot 259 og 1 339 mot 303. xhigh la på én ekstra på hvert kall. Til $2 per million er 1 036 tokens $0.002072. Medianoppgaven ble fakturert med $0.002446 på 4.6 og $0.002438 på 4.7 high, så gapet havnet ikke på fakturaen. De fire regningene til Grok 4.6 matcher $2 og $6 på de returnerte tallene. Det finnes ingen linje for de ekstra tusen.
Forsøket på 78,30 sekunder er én prompt og ett forsøk. Grok 4.7 high svarte på den samme retry-prompten på 3,37 sekunder, xhigh på 2,07 sekunder. Alle tre svarte 429,503. Medianlatensen over de fire promptene var 8,12 s, 5,02 s og 4,92 s. Ikke gjør det ene trege forsøket om til et hastighetsforhold.
På langt arbeid snur tokenbildet. Artificial Analysis rapporterte omtrent 81 000 output-tokens per Intelligence Index-oppgave for Grok 4.7 på xhigh, mot omtrent 36 000 for Grok 4.6 på high. Medianen vår på 316 tokens beskriver fire korte svar. Den beskriver ikke en Briefcase-jobb på flere timer.
Hvor terminalscoren på 38 % kommer fra
Tre publiserte Terminal-Bench 4.0-tall spriker: 38,0 %, 33 % og en økning på 4,5 poeng.
- xAIs lanseringstabell, skjermbildet over: Grok 4.7 xHigh 38,0 %, Grok 4.6 High 20,3 %, GPT-5.6 Sol Max 37,3 %, Fable 5.1 Max 57,9 %. Mot 4.6 er det 1,87×, eller +17,7 poeng. Mot Sol er det +0,7 poeng. Fable leder med 19,9 poeng.
- Artificial Analysis, med Grok Build som agent, 21. september 2026: Terminal-Bench 4.0 fra 18 % til 33 %, og DeepSWE v1.1 fra 65 % til 73 %. Coding Agent Index deres gikk fra 47 til 56 og landet på fjerdeplass, bak Fable 5.1, GPT-6 Astra og Claude Opus 5.
- Intelligence Index fra samme lab, med én felles runner for hver modell: Terminal-Bench 4.0 opp 4,5 poeng, og indeksen opp 2 poeng til 46. AA-LCR falt 3,7 poeng. AutomationBench-AA falt 1,1 poeng.
xAI navngir ikke agenten bak 38,0 %. Budsjetter ut fra tallet som matcher klienten din. Fable 5.1-anmeldelsen noterer 55,8 % for Fable på Terminal-Bench 4.0, mot 57,9 % på denne tavlen. Kodeindeksen til Astra hører hjemme i innlegget om GPT-6 Astra. Denne siden trenger bare søylen på 1 542 Elo.
Hvilket arbeid som bør forlate Grok 4.6
Korte strukturerte kall kan bli stående, mens terminal-, elektro- og juridisk agentarbeid bør flyttes.
Fable leder fortsatt CursorBench 4.0 med 5,5 poeng, 51,8 % mot 46,3 %. HealthBench Professional har fortsatt Fable på 62,1 % og Sol på 60,5 %, med Grok 4.7 på 56,7 %. De to radene er grunnen til at «bytt alt» er feil rekkefølge.
| Hvis jobben ser slik ut | Behold | Flytt til Grok 4.7 når |
|---|---|---|
| En kort gradert transformasjon, som de fire promptene over | Modellen som allerede er koblet til | Regningen for completion-tokens er den eneste klagen. Vår regning falt 29,2 % på high |
| Shell-arbeid av typen Terminal-Bench 4.0 | Fable 5.1, hvis 57,9 % er kravet | Du forlater 20,3 % på Grok 4.6 og kan leve med 38,0 % |
| Krets- og enhetsarbeid av typen EEBench | Ingen på denne tavlen slår 64,0 % | Alltid, på denne tabellen |
| En juridisk agentløkke av typen Harvey | Ingen på denne tavlen slår 19,6 % | Alltid på denne tabellen, med bomraten på 80,4 % i kontrakten |
| Dokumenter over flere timer, AA Briefcase | Fable, 21 Elo foran på 1 678 | Output-prisen dominerer: $6 mot $50 hos Fable |
| Editoroppgaver, CursorBench 4.0 | Fable på 51,8 % | Et gap på 5,5 poeng er billigere enn en output-sats på 8,3× |
| Kliniske oppgaver, HealthBench Professional | Fable eller Sol | Ikke flytt for scoren. 56,7 % ligger bak begge |
Output-satsen til Fable på $50 er 8,3× Groks $6. Betal det multiplumet når raden er produktet. Samme valg, skrevet som router-konfig, ligger i guiden om modellruting. Harveys 19,6 % leder denne tavlen og bommer likevel på 80,4 % av settet.
Hva denne målingen ikke kan fortelle deg
Fire prompter, ett forsøk hver, sier ingenting om CursorBench 4.0 eller en kontoroppgave på 7 minutter.
- Temperaturen var 0,
max_tokensvar 4000, verktøy var slått av, og ingenting ble kjørt på nytt. Et nytt forsøk på kallet på 78,30 sekunder kunne ha vært helt vanlig. - Fable 5.1, GPT-5.6 Sol og GPT-6 Astra ble ikke kalt. Cellene deres er sitert fra xAI og fra Artificial Analysis.
- Prompt-gapet på 1 036 tokens er et regnskapsfaktum. Ingenting i svaret navngir de tokenene, og fakturaen la ikke til listeprisverdien på $0.002072.
- Artificial Analysis registrerte tilbakegang, ikke bare gevinst: AA-LCR ned 3,7 poeng, AutomationBench-AA ned 1,1 poeng, og presentasjonskvalitet på AA-Briefcase ned fra 1 519 Elo til 1 499.
- Nøyaktigheten på AA-Omniscience var 47 % for Grok 4.7 mot 48 % for Grok 4.6 high. Hallusinasjonsraten på det settet falt fra 34 % til 29 %.
Sett 4.7 i drift der raden flyttet seg og den absolutte scoren tåler å stå ved siden av navnet til en kunde. La kliniske oppgaver bli på Fable eller Sol. La xhigh være av til en gradert oppgave endrer svaret. Disse fire gjorde det ikke.
Ofte stilte spørsmål
Hva er kunnskapsgrensen for Grok 4.7?
docs.x.ai oppgir grensen som mai 2026. Lanseringen 21. september ligger ikke i vektene. Nettsøk og X-søk er egne verktøy på samme side. En forespørsel uten dem svarer ut fra mai 2026. Legg kilden inn i prompten når faktumet er nyere enn det.
Endrer det amerikanske endepunktet tokenprisen?
Den regionale base-URL-en for USA er https://us.api.x.ai/v1. docs.x.ai priser den med et påslag på 10 %, slik at inferensen holdes i USA. En output-token til $6 blir $6.60 der, og en input-token til $2 blir $2.20. Modell-id-en er fortsatt grok-4.7. Knekkpunktet ved 200 000 tokens og satsen for cachet input gjelder fortsatt oppå det påslaget.
Kan API-et ta imot et bilde?
Ja. Modellsiden lister tekst og bilde som input, med kun tekst som output, et kontekstvindu på 500 000 tokens og ingen tak på tekst-output. Godkjente bilder er jpg eller png, opptil 20 MiB hver, uten oppgitt tak på antall. Svaret er tekst. Bildegenerering ligger på Imagine-modellene og deres egen prisliste.
Hvor kjører Grok 4.7 Fast egentlig?
Fast er de samme vektene på raskere maskiner, til dobbel tokenpris: $4 input og $12 output, utenfor standardprislisten. docs.x.ai selger det i Cursor og Grok Build, og holder det utenfor gratisnivået i Grok Build. Det offentlige API-et lister det ikke. API-trafikk blir på $2 og $6, knekkpunktet inkludert.
Hvilken modellstreng skal SDK-en sende?
På xAI-API-et er strengen grok-4.7. På OpenRouter kalte vi x-ai/grok-4.7 den 22. september 2026. Sett reasoning.effort til low, medium, high eller xhigh. High er dokumentert standard. Den oransje søylen er xhigh, så en klient som utelater feltet er ikke den søylen.