AI som kjører på dine egne servere.

Åpne modeller som Llama, Mistral og Qwen, servert med vLLM eller Ollama på din maskinvare eller i din private sky. Prompter, dokumenter og svar forlater aldri nettverket ditt, så personvernloven i landet ditt blir enkel å følge. Vi dimensjonerer maskinvaren, bygger søk over de interne dataene dine, finjusterer der det lønner seg og overleverer et system IT-teamet ditt drifter selv.

av promptene eller dokumentene forlater nettverket ditt
0 B
til en fungerende assistent på dine egne data
2–4 uker
av modellene, vektene og koden på din maskinvare
100 %

Privat inferens

Kjører på din maskinvare, uten internett

Llama 3.3 70B · vLLMgpu-01 · ditt datasenter

Spørsmål fra økonomi

Oppsummer leverandøravtalen med Acme og list opp oppsigelsesklausulene.

Hentet fra interne dokumenter

  • contracts/acme-supply-2025.pdf · side 3, 11
  • legal/termination-policy.docx · punkt 4

Svar

Responstid 1,4 s

  • Treårig leveranseavtale fra mars 2025, 60 000 enheter per kvartal til fast enhetspris.
  • Begge parter kan si opp med seks måneders varsel etter det første året [1].
  • Umiddelbar oppsigelse er tillatt ved vesentlig mislighold som ikke rettes innen 30 dager [1][2].

Data ut av nettverket0 B

Logget i revisjonsloggen din

CIO-er, CTO-er og dataledere kjører lokal AI med oss.

Samme ingeniører, samme prosess. Hvilket bruksområde som kommer først, avhenger av hvem som spør og hva policyen deres tillater.

CIO / IT-sjef

Før
Juridisk avdeling sa nei til AI i skyen. Kundedataene våre kan ikke forlate huset, så teamene mine bruker ingenting, eller bruker det i smug.
Etter
En modell på dine egne servere bak SSO-en din, med hver prompt logget. Teamene dine får assistenten de allerede ville ha, og datakartet i dokumentasjonen svarer revisoren.

0 Bav dataene forlater nettverket ditt
CTO / utviklingssjef

Før
Vi betaler per token for et API, regningen vokser hver måned, og vi kan fortsatt ikke sende det kundedata.
Etter
En dimensjoneringstabell med din reelle kostnad per token på dine egne GPU-er, deretter en serveringsstack som erstatter API-et bak én gateway. Samme kall fra koden din, ingen token-regning, og kundedata er tillatt.

2–4 ukertil det første bruksområdet er live

Data- / driftssjef

Før
Dokumentene våre er på tysk og tyrkisk og fulle av våre egne begreper. Generelle modeller svarer dårlig på dem.
Etter
Søk over dokumentene dine på deres egne språk, en finjustering på dine eksempler når evalueringene viser gevinst, og svar med kildesiden vedlagt. Målt på dine ekte spørsmål før lansering.

100 %av vektene og koden er dine

Vi bygger, tester og overleverer lokal AI på din maskinvare.

  • 01

    Inferensstacken

    vLLM eller Ollama som serverer en åpen modell, en gateway med samme API-form som koden din allerede kaller, GPU-planlegging, caching og overvåking. På én server, en klynge eller din private sky.

  • 02

    Søk over de interne dataene dine

    Koblinger til filområder, wikier, databaser og saksbehandlingssystemer. Embeddings og indeksen forblir lokale, søket respekterer tilgangsreglene dine, og hvert svar henviser til dokument og side.

  • 03

    Finjustering der det lønner seg

    En LoRA-finjustering på dine egne eksempler når evalueringene viser gevinst: ditt format, ditt vokabular, dine språk. Trent på din maskinvare; vektene er dine.

  • 04

    Dimensjonering av maskinvare og driftshåndboken

    En dimensjoneringstabell med kostnad per token, GPU-planen, failover og backup, og en driftshåndbok IT-teamet ditt bruker til å oppdatere modeller, rulle tilbake og lese overvåkingen.

Inkludert gratis

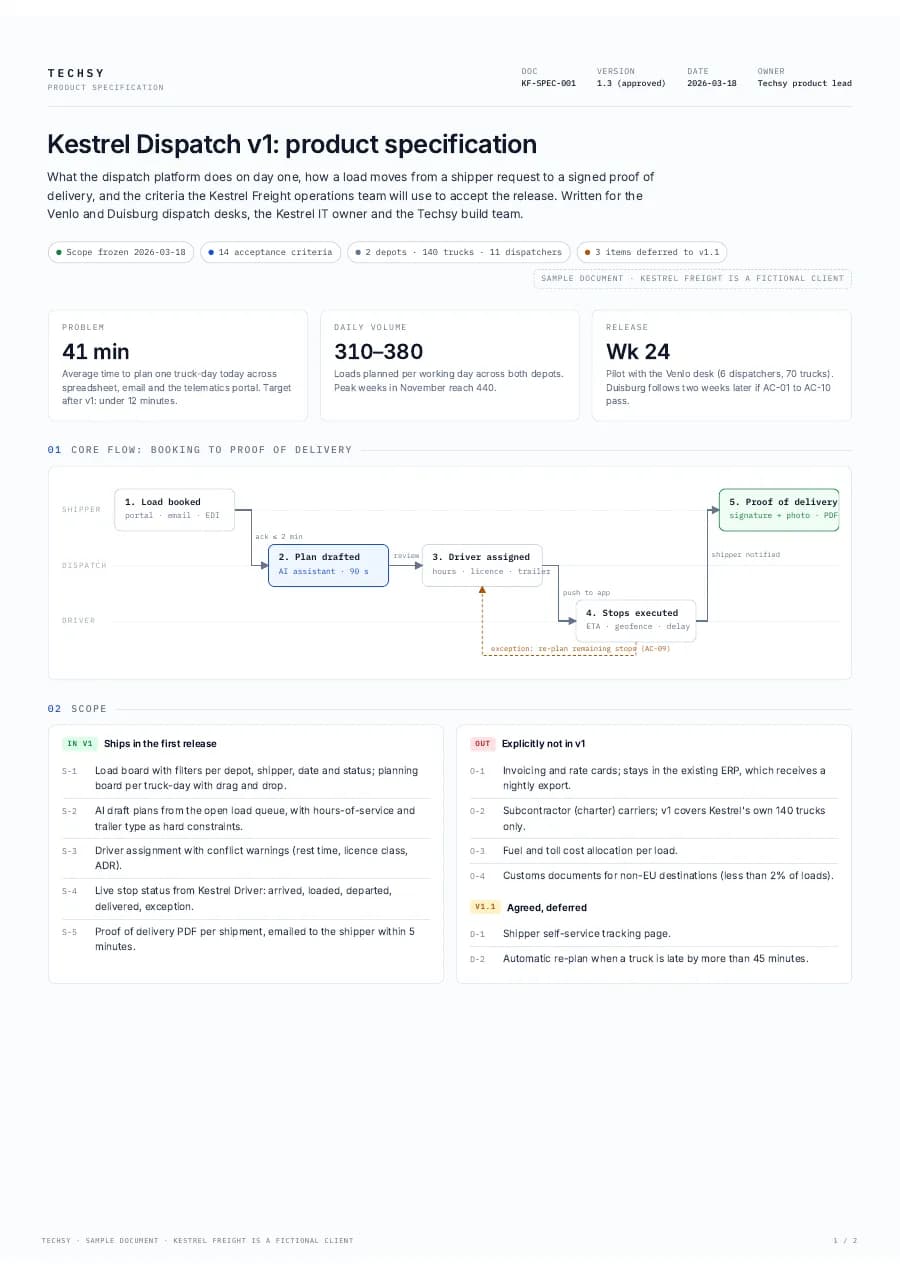
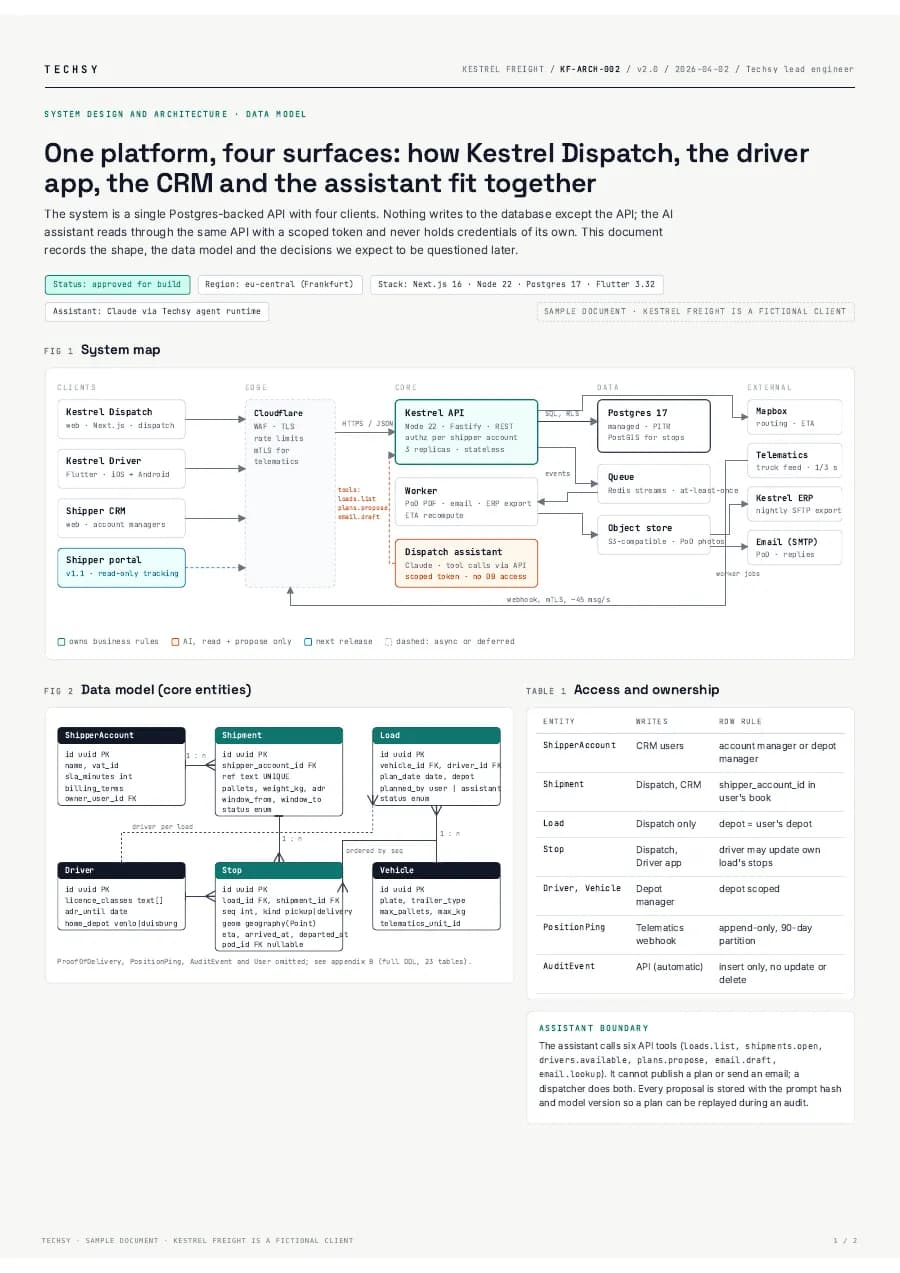
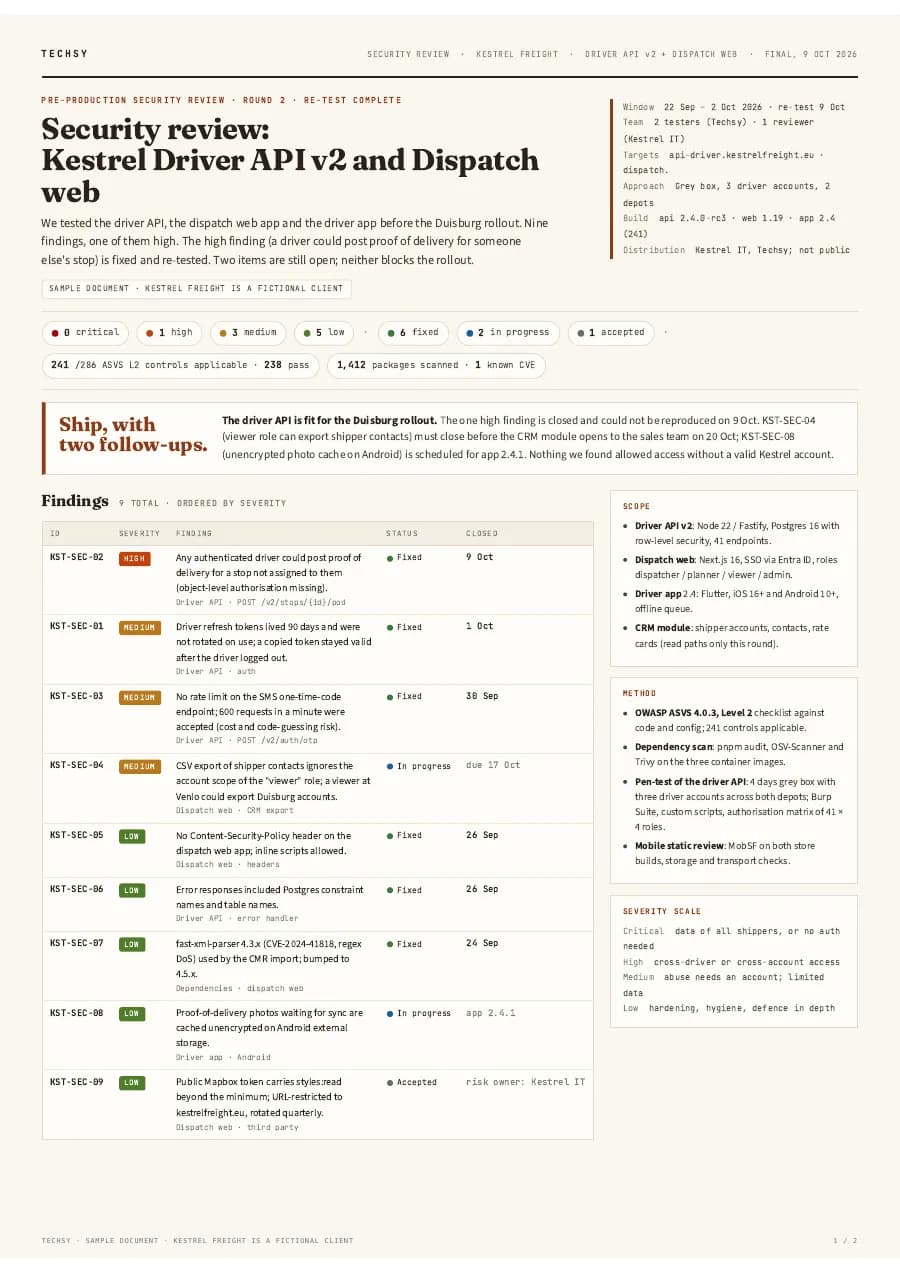
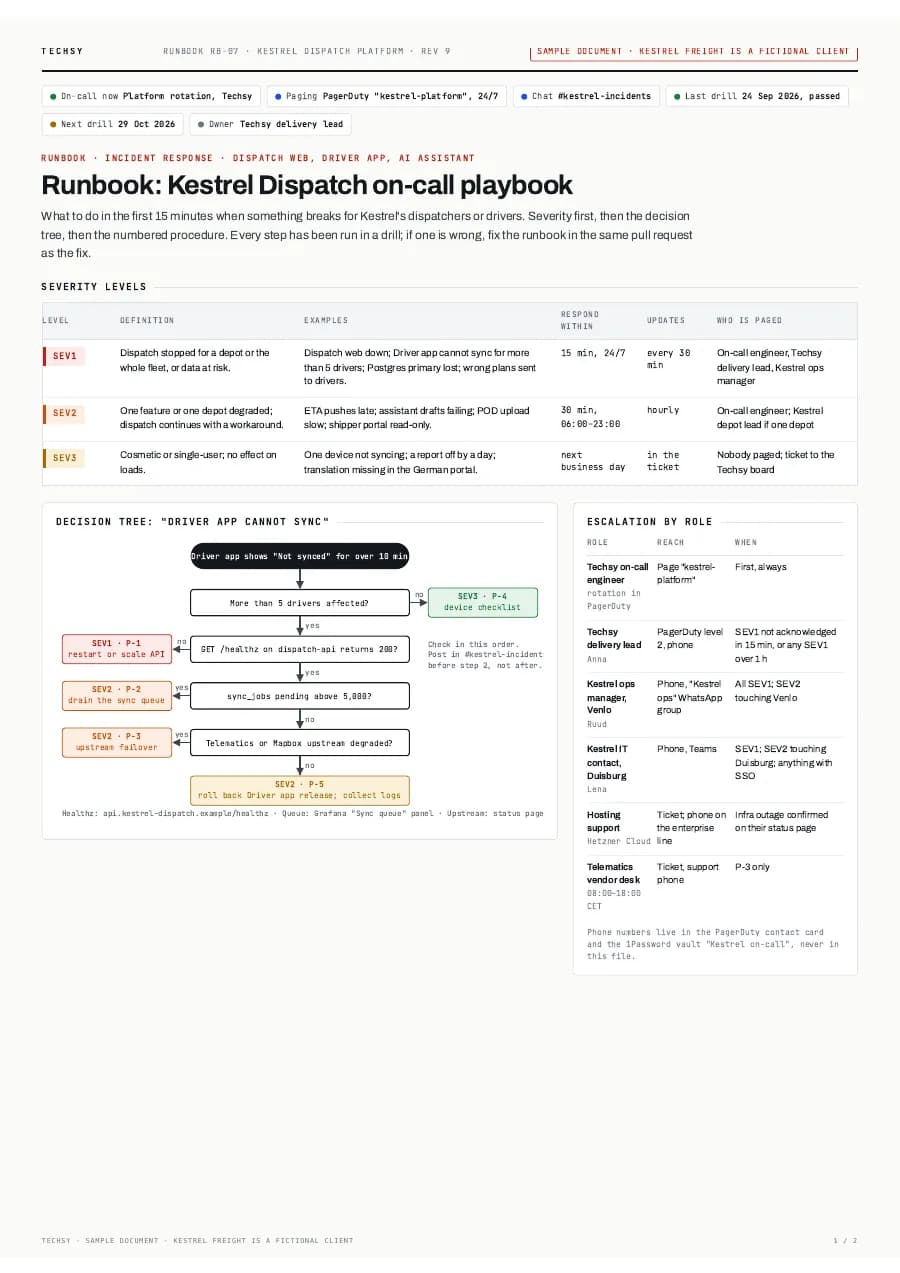
5 dokumenter følger med startpakken.

Den samme mappen du ser på prissiden. Åpne hvilket som helst for å lese en eksempelside.

Alle disse dokumentene er inkludert gratis i pakken; ingen av dem blir en ekstra linje i planen.

  • Trenger du noe mer?Si fra. Vi legger det til i pakken din, gratis.

Det første bruksområdet for lokal AI kjører på to til fire uker.

Du stiller med bruksområdet, dokumentene og én time i uka. Vi dimensjonerer, bygger, måler og overleverer, og IT-teamet ditt er med i hvert steg fra den første serveren.

  1. 01

    Uke 1

    Første møte og dimensjonering

    Vi
    Et gratis første møte om bruksområdene og dataene. Deretter en researchrapport: datakart, modellkandidater, dimensjonering av maskinvare med kostnad per token, og en fast pris.
    Du
    Godkjenner planen og betaler 50 %. Bestiller maskinvaren, eller peker oss til den private skyen du allerede har.
  2. 02

    Uke 2–3

    Pilot på ett bruksområde

    Vi
    Serverer modellen på din første node, kobler til én dokumentkilde, bygger søk med kildehenvisninger og skriver evalueringene ut fra dine ekte spørsmål.
    Du
    Gir oss 50 til 100 ekte spørsmål med svarene du forventer.
  3. 03

    Uke 3–6

    Herd og utvid

    Vi
    SSO og tilgangsregler, prompt- og svarloggen, overvåking, failover og backup. Finjusterer hvis evalueringene viser gevinst. Legger til neste bruksområde.
    Du
    Går gjennom evalueringsscorene med oss og godkjenner tersklene.
  4. 04

    Lansering

    Overlevering til IT

    Vi
    Driftshåndbok, opplæring av IT-teamet ditt, og de resterende 50 % ved levering. Større plattformer tar inntil tre måneder på samme vilkår.
    Du
    Drifter det selv, eller beholder oss på en månedlig avtale for modelloppdateringer og nye evalueringer.

Start med en privat assistent. Voks til en privat AI-plattform.

Tre pakker, hver til en fast pris dere ser før dere bestemmer dere. Hver pakke bygger på den forrige, så ingenting kastes.

  1. 01

    Første møte

    30 minutter, gratis

    Du beskriver bruksområdet og hvor dataene ligger. Vi forteller hvilken modell og maskinvare som passer, hva startpakken koster og hva API-regningen ville blitt i stedet.

  2. 02

    Privat AI-assistent

    Live på 2 til 3 uker

    En åpen modell på deres egen server. Ingenting forlater nettverket.

  3. 03

    Privat kunnskapsbase

    Live på 3 til 5 uker

    Dokumentene deres søkbare med AI, helt innenfor nettverket.

  4. 04

    Privat AI for bedriften

    Live på 6 til 10 uker

    Flere avdelinger på én privat AI-plattform.

Lokal AI kjører på serverne dine og logger inn via SSO-en din.

Vi bygger på maskinvaren og kontoene du allerede eier, logger brukerne inn gjennom SSO-en din og sender målinger til overvåkingen du allerede følger med på.

Alt annet med et API: vi skriver koblingen og gir deg koden.

Privat sky

  • AWS
  • Google Cloud
  • Azure
  • Cloudflare

Identitet og tilgang

  • Okta
  • Microsoft Entra ID
  • Auth0

Datakilder

  • PostgreSQL
  • Supabase
  • Notion
  • SAP
  • Dynamics 365
  • Odoo

Overvåking

  • Grafana
  • Datadog
  • Sentry
  • Elastic

Bruk med hvilket som helst AI-verktøy.

Agentene, skills og koden vi leverer fungerer i verktøyene teamet deres allerede bruker.

  • Codex
  • Claude
  • Cursor
  • Grok
  • Z.ai
  • Hermes
  • OpenClaw
  • Eve
  • Mistral
  • OpenCode
  • VS Code
  • Antigravity
  • Windsurf
  • JetBrains
  • Zed
  • GitHub Copilot
  • Cline
  • Qwen
  • Amp
  • Goose
  • Lovable
  • Replit
  • v0

Pakken din for lokal AI har én fast pris.

  • Lavest pris

    Privat AI-assistent

    En åpen modell på deres egen server. Ingenting forlater nettverket.

    4 500 USD

    3 000 USD

    Fra-pris · engangsbetaling

    • 5 dokumenter, gratis
    • En åpen modell, som Llama eller Qwen, på serveren deres
    • Teamchat med innlogging
    • Dataene deres sendes aldri til en ekstern AI-leverandør
    • Dimensjonering av maskinvare og installasjonsveiledning
    • En sikkerhetsgjennomgang av oppsettet
  • Mest populær

    Mellomklasse

    Privat kunnskapsbase

    Dokumentene deres søkbare med AI, helt innenfor nettverket.

    12 000 USD

    8 000 USD

    Fra-pris · engangsbetaling

    Alt i Privat AI-assistent, pluss:

    • Dokumentene koblet til, med tilganger
    • Svar med kildene sine
    • Single sign-on med bedriftskontoene deres
    • Kvalitetstester på deres egne spørsmål
    • Overvåking og en oppdateringsplan
  • Toppklasse

    Privat AI for bedriften

    Flere avdelinger på én privat AI-plattform.

    30 000 USD

    20 000 USD

    Fra-pris · engangsbetaling

    Alt i Privat kunnskapsbase, pluss:

    • Flere avdelinger, hver med egne data og regler
    • GPU-dimensjonering for lasten deres
    • Et API for de andre systemene deres
    • Revisjonslogger og tilgangsrapporter
    • Kvalitetstester ved hver modelloppdatering

Ditt første møte med Techsy er gratis.

Etterpå vet du hva du trenger.

  • Det første møtet koster ingenting.
  • Researchrapporten er også gratis.
  • 25 % tilbake hvis du avbestiller innen 28 dager.
Slik går et prosjekt med Techsy, steg for steg
  1. Gratis første møte: Tretti minutter med en som bygger.
  2. Planlegging: Omfang, faser og datoer, skriftlig avtalt.
  3. Research og dokumenter: En gratis researchrapport og spesifikasjonene.
  4. Løsning og gevinst: Hva vi bygger og hva dere sparer.
  5. Utvikling: Bygget i korte, synlige sykluser.
  6. Lansering: Live, overvåket og overlevert.

Dette spør team om før de kjører AI på egne servere.

Kostnad, modeller, maskinvare, personvern og hvem som holder det i gang. Spørsmålene vi hører i hvert første møte.

  • Tre pakker. Privat AI-assistent for 3 000 USD setter en åpen modell med teamchat på deres egen server. Privat kunnskapsbase for 8 000 USD legger til dokumentene med tilganger, kilder og single sign-on. Privat AI for bedriften for 20 000 USD betjener flere avdelinger, med GPU-dimensjonering, API og revisjonslogger. Dere betaler 50 % når dere godkjenner planen og resten ved levering. Maskinvaren kjøpes i deres navn; vi dimensjonerer den og oppgir kostnaden per token før dere bestiller.

  • Modeller med åpne vekter: Llama, Mistral, Qwen, Gemma, DeepSeek og mindre oppgavemodeller for embeddings, reranking og klassifisering. Vi velger per bruksområde ut fra evalueringsscore, responstid og maskinvaren du har. En modell på 7B til 14B på én GPU dekker de fleste dokument- og supportoppgaver; en 70B-modell trenger en node med flere GPU-er. Alle modellkall går gjennom én gateway, så å bytte modell senere er en konfigurasjonsendring, ikke en ombygging.

  • Det avhenger av modellen og hvor mange som bruker den samtidig. Én server med en eller to datasenter-GPU-er serverer en 14B-modell til noen hundre brukere. En 70B-modell vil ha fire til åtte GPU-er. Har du allerede GPU-kapasitet, i en privat sky eller på en arbeidsstasjon, starter vi der. Researchrapporten inneholder en dimensjoneringstabell med kostnad per token, så du kan sammenligne med API-regningen du betaler i dag.

  • Det fjerner den vanskeligste delen: ingen personopplysninger forlater infrastrukturen din, så det er ingen tredjeparts databehandler, ingen overføring ut av landet ditt og ingen leverandør som trener på promptene dine. Vi legger til det revisorene spør etter: tilgangsregler knyttet til SSO-en din, en logg over hver prompt og hvert svar, lagringsregler og et datakart i dokumentasjonen. Juridisk avdeling eier fortsatt policyen; vi sørger for at det tekniske svaret på hvert spørsmål er ja.

  • På allmennkunnskap ligger frontier-API-ene foran. På dine dokumenter, dine begreper og ditt språk matcher eller slår en lokal modell med godt søk og en liten finjustering dem som regel, fordi svaret kommer fra dine data, ikke fra modellens hukommelse. Vi ber deg ikke ta det på tro: før lansering kjører vi evalueringer på et sett av dine ekte spørsmål og viser deg scorene side om side.

  • Start med søk. RAG legger de riktige dokumentene foran modellen og gir deg kildehenvisninger, og det dekker de fleste bruksområder alene. Finjustering lønner seg når modellen må lære en stil, et format eller et fagvokabular, som tysk kontraktsspråk eller tyrkiske regnskapsbegreper. Vi foreslår det bare når evalueringene viser en tydelig gevinst, og vi kjører det på din maskinvare med dine eksempler.

  • IT-teamet ditt kan, med driftshåndboken vi overleverer: hvordan oppdatere en modell, rulle tilbake, legge til en GPU, lese overvåkingen og gjenopprette fra backup. Mange kunder beholder oss på en månedlig avtale i stedet: vi holder modeller, drivere og serveringsstacken oppdatert, kjører evalueringene på nytt når dataene dine endrer seg og følger med på GPU-bruk og responstid. Uansett er systemet ditt og kjører uten oss.

  • Det første møtet er gratis. Innen en uke har du en researchrapport med bruksområdene, datakartet, dimensjoneringen av maskinvare og en fast pris. Du godkjenner planen og betaler 50 %. Et første bruksområde er live på din maskinvare på to til fire uker; en full plattform med flere bruksområder, SSO og finjustering tar inntil tre måneder. De resterende 50 % forfaller ved levering, etter at evalueringene har passert tersklene vi ble enige om.

Fant du ikke svaret?

Spør et menneske

Bygg systemet bedriften din kjører på.

Book en scoping-samtale, så kartlegger vi løsningen, kostnaden og tidslinjen. De fleste team går fra den første samtalen med en fast plan.

Tre raske spørsmål, så ser du prisintervall og tidsplan. Ingen samtale nødvendig.