Grok 4.7 vs Grok 4.6: Samma $2/$6, och vinnaren beror på jobbet
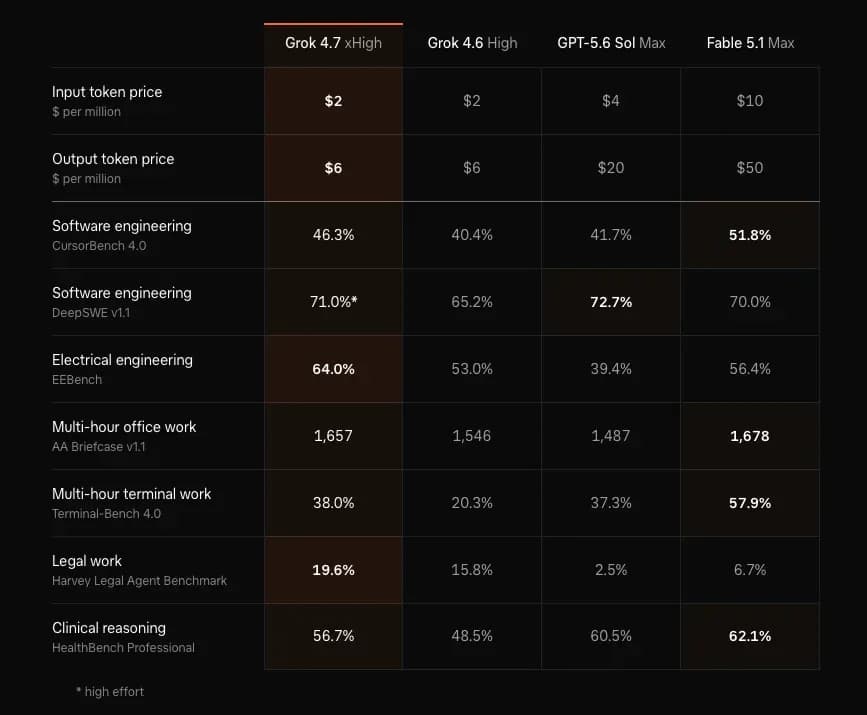
Grok 4.7 släpptes den 21 september 2026 till $2 per miljon indata-tokens och $6 per miljon utdata, samma priskort som Grok 4.6. SpaceXAI:s egen poängtavla ger 4.7 vinst på varje rad mot 4.6, och förlorar sedan fyra av de sju raderna till Fable 5.1 Max. Vi sparade båda diagrammen från lanseringssidan och skickade 12 graderade anrop genom OpenRouter den 22 september, 14.51 till 14.53 UTC.
Där Grok 4.7 faktiskt slår Grok 4.6
Skicka eljobb, juridiska agentjobb och terminaljobb till Grok 4.7. Kliniska uppgifter stannar på Fable 5.1 eller GPT-5.6 Sol.
Varje siffra i ledarkolumnen kommer från lanseringsinlägget den 21 september, hämtat 22 september 2026. Sista raden är vår.
| Jobb | Ledare på raden | Grok 4.7 | Dirigera |
|---|---|---|---|
| EEBench | Grok 4.7 xHigh | 64,0 % | Grok 4.7 |
| Harveys juridiska agent | Grok 4.7 xHigh | 19,6 % | Grok 4.7, och säg till användaren att 80,4 % fortfarande missar |
| Terminal-Bench 4.0 | Fable 5.1 Max, 57,9 % | 38,0 % | 4.7 när du lämnar 4.6; Fable när poängen är produkten |
| CursorBench 4.0 | Fable 5.1 Max, 51,8 % | 46,3 % | Fable, om inte $6 i utdata slår ett gap på 5,5 poäng |
| DeepSWE v1.1 | GPT-5.6 Sol Max, 72,7 % | 71,0 % vid high, inte xHigh | Sol, eller 4.7 om 1,7 poäng inte är värt $20 i utdata |
| AA Briefcase v1.1 | Fable 5.1 Max, 1 678 | 1 657 | Fable, 21 Elo före, eller 4.7 när utdataräkningen dominerar |
| HealthBench Professional | Fable 5.1 Max, 62,1 % | 56,7 % | Fable eller Sol (60,5 %), inte 4.7 |
| Fyra korta anrop, våra | Oavgjort | 4/4 | Behåll modellen du redan kör |
Grok 4.6 High ligger under 4.7 på alla sju publicerade rader. Det är hela argumentet för att uppgradera från modellen du redan kör. Det är inte ett argument för att uppgradera från Fable på redigeringsuppgifter, kontorsarbete, terminalarbete eller kliniska uppgifter.
Vad SpaceXAI:s två diagram räknar
Den orange kolumnen är xHigh, förvalet i API:et är high, och DeepSWE:s 71,0 % är markerad som high.
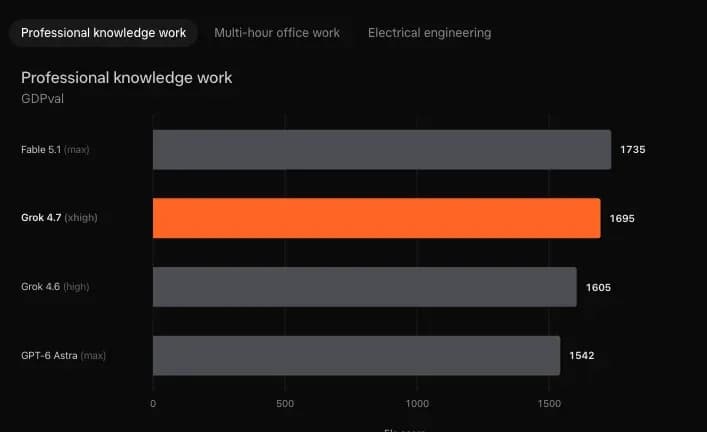
GDPval sätter Fable 5.1 max på 1 735 Elo, Grok 4.7 xhigh på 1 695, Grok 4.6 high på 1 605 och GPT-6 Astra max på 1 542. Det är +90 Elo mot 4.6, 40 Elo bakom Fable och 153 Elo före Astra. OpenAI-namnet i det här diagrammet är Astra. OpenAI-namnet på poängtavlan är GPT-5.6 Sol Max. Det är olika modeller, och lanseringssidan använder båda.
- Läs den orange kolumnen som xHigh. docs.x.ai sätter förvald ansträngning till high.
- Läs 71,0 % som ansträngningen high. Asterisken sitter på den DeepSWE-cellen och på ingen annan cell för Grok 4.7.
- Låt Astras 1 542 stå kvar i Elo-diagrammet. Klistra inte in den i Sols kolumn.
Artificial Analysis delar upp vinsten på kontorsarbete. På AA-Briefcase gick den analytiska kvaliteten från 1 690 Elo på Grok 4.6 high till 1 994 på Grok 4.7. Presentationskvaliteten gick från 1 519 till 1 499. Dokumenten blev skarpare i analysen och något sämre som dokument.
CursorBench är Cursors svit. SpaceX gick med på att köpa Cursors tillverkare, Anysphere, för $60B i aktier den 16 juni 2026.
Grok 4.7 ligger i API:et som grok-4.7, i Cursor och som förvald modell i Grok Build. Texten från 12 augusti om Grok 4.6 vs Grok 4.5 sa att 4.7 inte hade släppts än. Den meningen stämde den 12 augusti. Den slutade stämma den 21 september.
Vad $2 och $6 lämnar utanför priskortet
En prompt på 250 000 tokens kostar $4 och $12, på varje token i requesten.
I diagrammet står $2 och $6. Modellsidan har två rader. Under 200 000 prompt-tokens är priserna $2 indata, $0.50 cachad indata och $6 utdata. Vid 200 000 eller mer får hela requesten nytt pris: $4, $1 och $12.
prompt, output = 250_000, 2_000
chart_rate = prompt / 1e6 * 2 + output / 1e6 * 6     # $0.512
cliff_rate = prompt / 1e6 * 4 + output / 1e6 * 12    # $1.024
När du korsar linjen dubblas räkningen, och diagrammet visar det aldrig. $0.512 blir $1.024. Tokens under 200 000 behåller inte det billiga priset.
Indata på $2 är hälften av GPT-5.6 Sols $4 och en femtedel av Fable 5.1:s $10. Utdata på $6 är 3,3× billigare än Sols $20 och 8,3× billigare än Fables $50. Per utdata-dollar blir det 166 667 tokens på Grok, 50 000 på Sol och 20 000 på Fable. ”Halva priset” stämmer på indata mot Sol. Det stämmer inte på någon av utdataraderna.
Cachad indata ligger kvar på $0.50 per miljon under 200 000 tokens, samma siffra som för Grok 4.6, och sedan $1 vid brytpunkten. Hur den cacheraden slår i en riktig faktura tar guiden om inferenskostnad upp.
Grok 4.7 Fast är en separat brytare: dubbel utdatahastighet till dubbla tokenpriset, inne i Cursor och Grok Build. Det är inte brytpunkten vid 200 000 tokens, och det publika API:et säljer den inte.
Artificial Analysis mätte långa prompter till ungefär 188 tokens per sekund och ungefär 7,1 minuter per uppgift i Intelligence Index. Medianen på våra korta anrop var 5,02 sekunder för Grok 4.7 high mot 8,12 sekunder för Grok 4.6 high. Ingen av siffrorna är ett påstående om 2× hastighet mot Fable eller Sol.
Vad 12 anrop till Grok 4.7 gav den 22 september
Tolv anrop klarade 12/12, och xhigh gav samma fyra svar som high.
Samma fyra prompter, temperature 0, max_tokens 4000, ett försök vardera, inga verktyg. Grok 4.6 på high, Grok 4.7 på high, Grok 4.7 på xhigh. Gatewayen var OpenRouter, samma upplägg som i vår jämförelse av LLM-gatewayer. Råa usage-objekt ligger i benchmark-raw.json bredvid det här inlägget. OpenRouters usage.cost för de tolv anropen summerade till $0.029279.
{
  "model": "x-ai/grok-4.7",
  "temperature": 0,
  "max_tokens": 4000,
  "reasoning": {"effort": "xhigh"},
  "messages": [{"role": "user", "content": "..."}]
}| Uppgift | Förväntat | 4.6 high | 4.7 high | 4.7 xhigh |
|---|---|---|---|---|
| Median av 3, 1, 4, 1, 5, 9 | 3,5 | 3,5; 6,17 s; 348 tok | 3,5; 5,42 s; 359 tok | 3,5; 4,67 s; 300 tok |
| 2,2 kΩ vid 5 mA | 11 V | 11; 8,06 s; 511 tok | 11; 4,62 s; 273 tok | 11; 5,31 s; 348 tok |
| Försök igen på 429 och 503, aldrig 500 | 429,503 | 429,503; 78,30 s; 451 tok | 429,503; 3,37 s; 216 tok | 429,503; 2,07 s; 87 tok |
count_passed([59, 60, 100, 0]) med loopen som startar på index 1 | 2 | 2; 8,18 s; 466 tok | 2; 6,10 s; 409 tok | 2; 5,16 s; 368 tok |
Completion-tokens föll från 1 776 på Grok 4.6 high till 1 257 på Grok 4.7 high och 1 103 på xhigh. Reasoning-tokens, som ingår i de completion-siffrorna, var 1 543, sedan 1 052, sedan 944. OpenRouter-fakturan följde med: $0.012258, sedan $0.008877, sedan $0.008144. Det är 29,2 % färre completion-tokens på high och en 27,6 % mindre räkning, på ett test som båda modellerna klarade 4/4.
prompt_tokens på Grok 4.7 kom tillbaka exakt 1 036 över det matchade anropet till Grok 4.6 på high: 1 311 mot 275, 1 288 mot 252, 1 295 mot 259, 1 339 mot 303. xhigh lade till en token till på varje anrop. Vid $2 per miljon är 1 036 tokens $0.002072. Medianposten fakturerades till $0.002446 på 4.6 och $0.002438 på 4.7 high, så gapet slog inte igenom på fakturan. Grok 4.6:s fyra räkningar matchar däremot $2 och $6 på de returnerade antalen. Det finns ingen rad för det extra tusentalet.
Försöket på 78,30 sekunder är en prompt och ett enda försök. Grok 4.7 high svarade på samma retry-prompt på 3,37 sekunder, xhigh på 2,07 sekunder, alla tre med 429,503. Medianlatensen över de fyra prompterna var 8,12 s, 5,02 s och 4,92 s. Gör inte det enstaka långsamma försöket till en hastighetskvot.
På långa jobb vänder tokenbilden. Artificial Analysis rapporterade ungefär 81 000 utdata-tokens per uppgift i Intelligence Index för Grok 4.7 på xhigh, mot ungefär 36 000 för Grok 4.6 på high. Vår median på 316 tokens beskriver fyra korta svar. Den beskriver inte ett Briefcase-jobb på flera timmar.
Var terminalpoängen på 38,0 % kommer ifrån
Tre publicerade siffror för Terminal-Bench 4.0 går isär: 38,0 %, 33 % och en ökning på 4,5 poäng.
- xAI:s lanseringstabell, skärmdumpen ovan: Grok 4.7 xHigh 38,0 %, Grok 4.6 High 20,3 %, GPT-5.6 Sol Max 37,3 %, Fable 5.1 Max 57,9 %. Mot 4.6 är det 1,87×, eller +17,7 poäng. Mot Sol är det +0,7 poäng. Fable leder med 19,9 poäng.
- Artificial Analysis, med Grok Build som agent, 21 september 2026: Terminal-Bench 4.0 från 18 % till 33 %, och DeepSWE v1.1 från 65 % till 73 %. Deras Coding Agent Index gick från 47 till 56 och landade på plats 4, bakom Fable 5.1, GPT-6 Astra och Claude Opus 5.
- Samma labb, Intelligence Index, ett gemensamt testupplägg för varje modell: Terminal-Bench 4.0 upp 4,5 poäng, och indexet upp 2 poäng till 46. AA-LCR föll 3,7 poäng. AutomationBench-AA föll 1,1 poäng.
xAI namnger inte agenten bakom 38,0 %. Budgetera den siffra som matchar din klient. Recensionen av Fable 5.1 redovisar 55,8 % för Fable på Terminal-Bench 4.0, mot 57,9 % på den här tavlan. Astras kodindex hör hemma i texten om GPT-6 Astra. Den här sidan behöver bara Elo-stapeln på 1 542.
Vilket jobb ska lämna Grok 4.6
Korta strukturerade anrop kan stanna. Terminaljobb, eljobb och juridiska agentjobb ska flytta.
Fable leder fortfarande CursorBench 4.0 med 5,5 poäng, 51,8 % mot 46,3 %. HealthBench Professional har fortfarande Fable på 62,1 % och Sol på 60,5 %, med Grok 4.7 på 56,7 %. De två raderna är skälet till att ”byt allt” är fel ordning.
| Om jobbet ser ut så här | Behåll | Byt till Grok 4.7 när |
|---|---|---|
| En kort graderad omvandling, som de fyra prompterna ovan | Modellen som redan är inkopplad | Räkningen för completion-tokens är det enda klagomålet. Den föll 29,2 % på high |
| Skalarbete i samma form som Terminal-Bench 4.0 | Fable 5.1, om 57,9 % är kravet | Du lämnar Grok 4.6:s 20,3 % och kan leva med 38,0 % |
| Krets- och enhetsarbete i samma form som EEBench | Ingen på den här tavlan slår 64,0 % | Alltid, på den här tabellen |
| En juridisk agentloop i samma form som Harvey | Ingen på den här tavlan slår 19,6 % | Alltid på den här tabellen, med missgraden 80,4 % i kontraktet |
| Dokument på flera timmar, AA Briefcase | Fable, 21 Elo före på 1 678 | Utdatapriset dominerar: $6 mot Fables $50 |
| Redigeringsuppgifter, CursorBench 4.0 | Fable på 51,8 % | Ett gap på 5,5 poäng är billigare än utdatakvoten 8,3× |
| Kliniska uppgifter, HealthBench Professional | Fable eller Sol | Byt inte för poängens skull. 56,7 % ligger efter båda |
Fables utdatapris på $50 är 8,3× Groks $6. Betala den multipeln när raden är produkten. Samma val, skrivet som routerkonfiguration, finns i guiden om modellrouting. Harveys 19,6 % leder den här tavlan och missar ändå 80,4 % av testmängden.
Vad den här mätningen inte kan säga dig
Fyra prompter, ett försök vardera, säger inget om CursorBench 4.0 eller en kontorsuppgift på 7 minuter.
- Temperature var 0,
max_tokensvar 4000, verktygen var avstängda och inget kördes om. Ett andra försök på anropet som tog 78,30 sekunder kunde ha varit vanligt. - Vi anropade inte Fable 5.1, GPT-5.6 Sol eller GPT-6 Astra. Deras celler är citerade från xAI och från Artificial Analysis.
- Promptgapet på 1 036 tokens är ett bokföringsfaktum. Ingenting i svaret namnger de tokenarna, och fakturan lade inte till listpriset på $0.002072.
- Artificial Analysis noterade regressioner, inte enbart vinster: AA-LCR ner 3,7 poäng, AutomationBench-AA ner 1,1 poäng, presentationskvalitet på AA-Briefcase ner från 1 519 Elo till 1 499.
- Träffsäkerheten på AA-Omniscience var 47 % för Grok 4.7 mot 48 % för Grok 4.6 high. Hallucinationsgraden där föll från 34 % till 29 %.
Deploya 4.7 där raden rörde sig och den absoluta siffran kan stå bredvid en kunds namn. Låt kliniska uppgifter ligga kvar på Fable eller Sol. Låt xhigh vara av tills en graderad uppgift ändrar sitt svar. De här fyra gjorde det inte.
Vanliga frågor
När är knowledge cutoff för Grok 4.7?
docs.x.ai daterar cutoff till maj 2026. Releasen den 21 september finns inte i vikterna. Webbsök och X-sök är separata verktyg på samma sida. En request utan dem svarar utifrån maj 2026. Skicka med källan i prompten när faktumet är nyare än så.
Ändrar USA-endpointen tokenpriset?
Den regionala bas-URL:en för USA är https://us.api.x.ai/v1. docs.x.ai sätter ett påslag på 10 % så att inferensen stannar i USA. En utdata-token på $6 blir $6.60 där, och en indata-token på $2 blir $2.20. Modell-id:t är fortfarande grok-4.7. Brytpunkten vid 200 000 tokens och priset för cachad indata gäller fortfarande ovanpå det påslaget.
Kan API:et ta emot en bild?
Ja. Modellsidan listar text och bild som indata, med enbart text som utdata, en kontext på 500 000 tokens och inget tak för textutdata. Godkända bilder är jpg eller png, upp till 20 MiB styck, utan angivet tak för antalet. Svaret är text. Bildgenerering ligger kvar på Imagine-modellerna och deras egen prislista.
Var kör Grok 4.7 Fast egentligen?
Fast är samma vikter på snabbare maskiner, till dubbla tokenpriserna: $4 indata och $12 utdata, utanför det vanliga priskortet. docs.x.ai säljer den i Cursor och Grok Build, och lämnar den utanför gratisnivån i Grok Build. Det publika API:et listar den inte. API-trafiken stannar på $2 och $6, med brytpunkten inräknad.
Vilken modellsträng ska SDK:et skicka?
På xAI-API:et är strängen grok-4.7. På OpenRouter anropade vi x-ai/grok-4.7 den 22 september 2026. Sätt reasoning.effort till low, medium, high eller xhigh. High är det dokumenterade förvalet. Den orange kolumnen är xhigh, så en klient som utelämnar fältet är inte den kolumnen.