GPT-6 Astra vs Claude Opus 5.5 vs Grok 4.7: faktura, GDPval och sex anrop
GPT-6 Astra, Claude Opus 5.5 och Grok 4.7 gick alla att anropa på OpenRouter kl. 22:34 UTC den 22 sep 2026. Sex bedömda anrop, två uppgifter, ett försök per modell och uppgift. Alla godkända. Fakturan hos gatewayen blev $0.01626.
Lanseringsdiagrammen går inte att lägga på varandra.
Anthropics tavla har Astra och ingen Grok. xAI:s tavla har Fable 5.1 och Sol, plus Astra på ett Elo-diagram. Den här sidan behåller de gemensamma ankarna och slutar där linjalerna skiljer sig.
Prissänkningen Opus 5.5 mot Opus 5 ligger kvar i Opus 5.5-inlägget. Uppgraderingen 4.7 mot 4.6 ligger kvar i Grok 4.7-inlägget. Astra mot Fable ligger kvar i GPT-6 Astra-inlägget.
Tre kort, och promptstorleken som sätter om priset
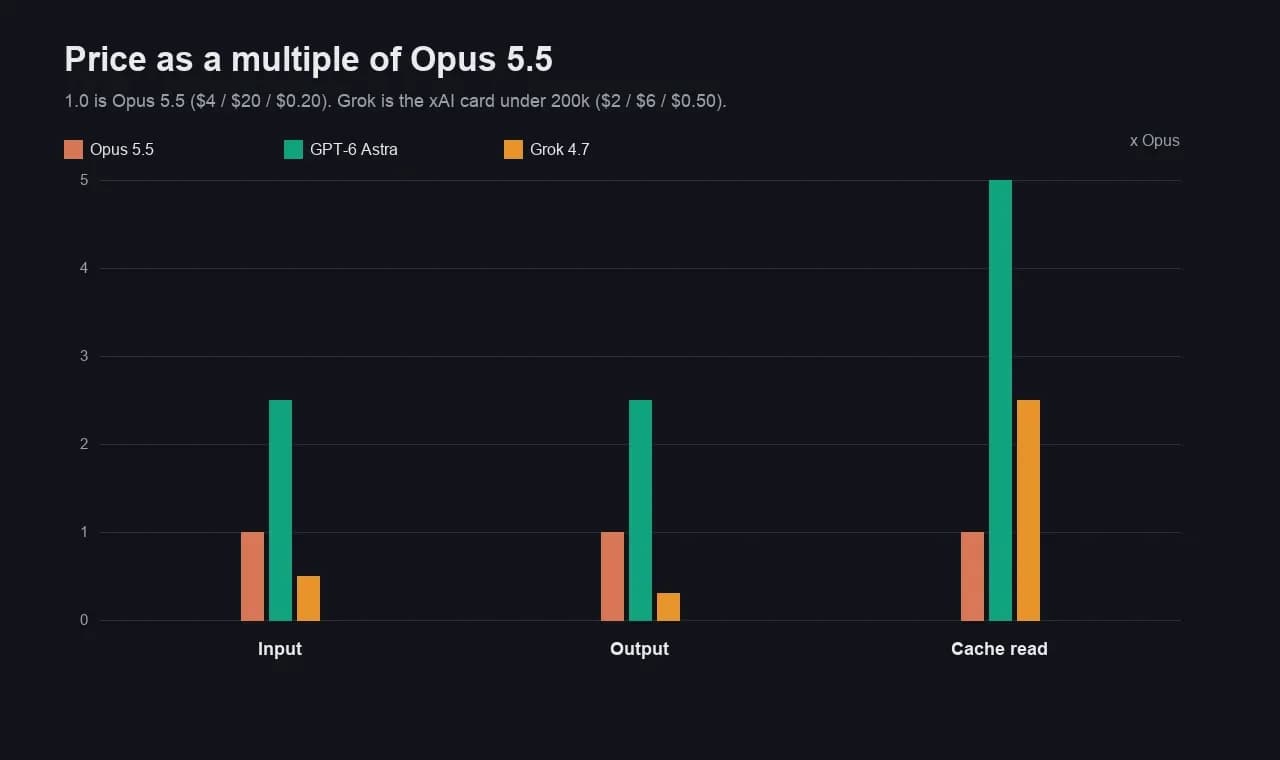
Astras token kostar 2,5× Opus 5.5 på indata och utdata, och 5× på cache-läsning. Groks xAI-kort är hälften på indata och 0,3× på utdata, tills prompten passerar 200 000 tokens.
Räkna Opus 5.5 som 1,0: $4, $20 och $0.20 per miljon.
Astras modellkort är $10, $50 och $1.00. Groks kort från 21 sep är $2, $6 och $0.50 under 200 000 prompt-tokens.
| Rad, per 1 miljon tokens, under tröskeln | Opus 5.5 | GPT-6 Astra | Grok 4.7, xAI-kort |
|---|---|---|---|
| Indata | $4 | $10 | $2 |
| Utdata | $20 | $50 | $6 |
| Cache-läsning | $0.20 | $1.00 | $0.50 |
| Kontext | 1 000 000 | 1 050 000 | 500 000 |
| Tröskel | ingen på det här kortet | 272 000 prompt-tokens: indata och cache 2×, utdata 1,5× | 200 000 prompt-tokens: hela requesten går till $4 / $12 / $1 |
OpenRouters priser kl. 22:34 UTC stämde med Opus och Astra. Inte med Grok.
Listningen låg på $1.60, $4.80 och $0.40, sedan $3.20, $9.60 och $0.80 vid 200 000 prompt-tokens. Det är 0,8× xAI-kortet. Siffrorna i usage.cost kommer från den katalogen. Grok 4.7-inlägget prissätter fortfarande xAI:s eget kort till $2 och $6.
En omläsning på 500 000 cache-tokens, bara räkning: Opus $0.10, Astra $0.25, Groks cache-rad hos xAI $0.25. Astra är dyr på cachen, inte på utdata. På utdata är Groks $6 mot Astras $50 ett gap på 8,3×, och mot Opus $20 ett gap på 3,3×.
Sex bedömda anrop, och fakturan varje modell faktiskt skickade
Alla sex gick igenom. Groks två anrop kostade $0.0038784, Opus 5.5 kostade $0.005292 och Astra kostade $0.00709.
Fakturasvaret skulle vara 1.96. merge_intervals skulle klara dolda tester, även intervall som tar i varandra.
Cachade tokens var 0 på Opus och Astra. Grok rapporterade 1 152 cachade tokens på båda anropen, inräknade i promptantalen 1 310 och 1 336. 295 av Groks 298 fakturatokens var resonemang.
# 22 Sep 2026, 22:34 UTC, OpenRouter, one trial, max_tokens 1800
MODELS = [
    "anthropic/claude-opus-5.5",
    "openai/gpt-6-astra",
    "x-ai/grok-4.7",
]| Uppgift | Opus 5.5 | GPT-6 Astra | Grok 4.7 |
|---|---|---|---|
| Faktura, ska vara 1.96 | godkänd, $0.001336, 46 ut, 4,277s | godkänd, $0.00263, 38 ut, 2,116s | godkänd, $0.002144, 298 ut, 5,292s |
| merge_intervals | godkänd, $0.003956, 168 ut, 3,307s | godkänd, $0.00446, 69 ut, 2,588s | godkänd, $0.0017344, 204 ut, 4,217s |
| Summa, två uppgifter | $0.005292 | $0.00709 | $0.0038784 |
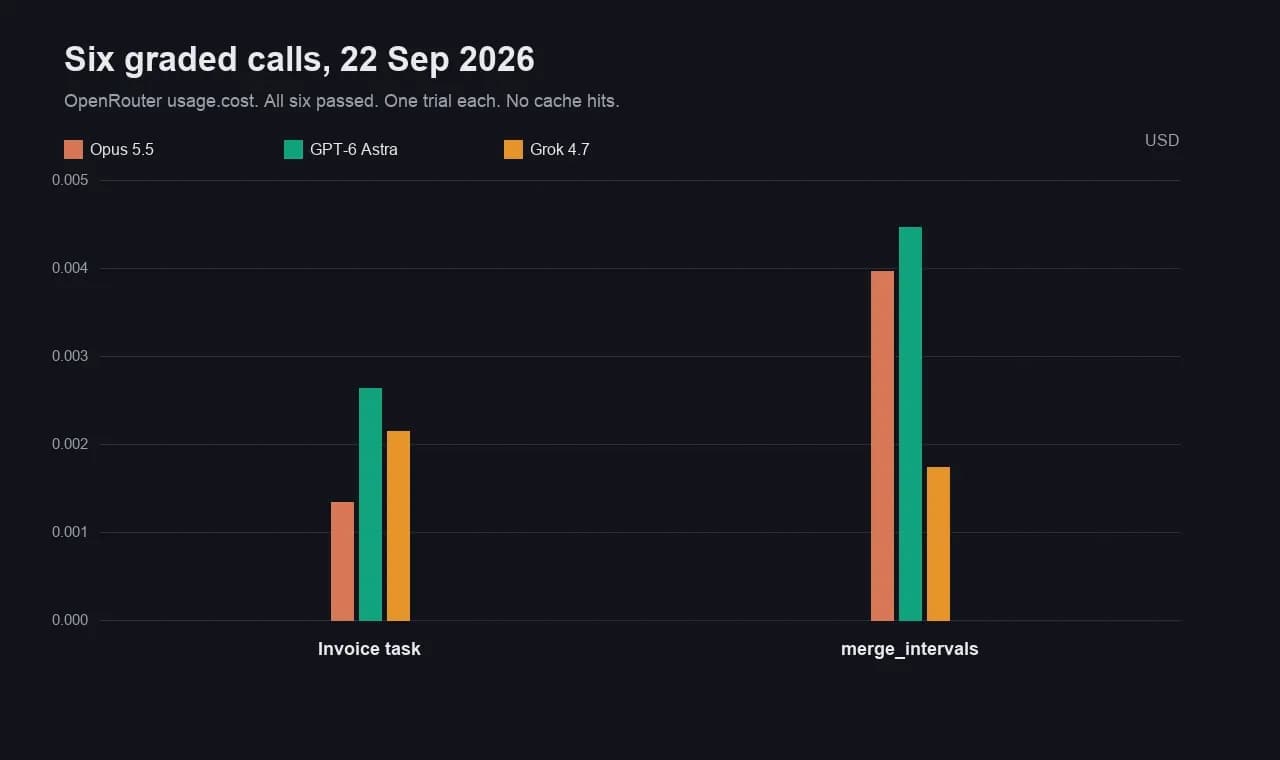
Astra skrev färst tokens och skickade störst faktura.
38 och 69 svarstokens, mot Opus på 46 och 168. Kortet på $10/$50 åt upp besparingen. De två siffrorna i usage.cost stämmer exakt med $10 och $50. Opus stämmer med $4 och $20.
Grok vann inte fakturaraden, men vann funktionsraden. 204 tokens till $4.80 landade på $0.0017344.
Astra var snabbast båda gångerna, 2,116s och 2,588s. Ett försök räcker inte för att ranka hastighet.
Astra-texten från 4 sep sa att openai/gpt-6-astra returnerade HTTP 400. Det stämde kl. 14:40 UTC den dagen. Det stämmer inte för den här körningen. Id:t gick att slå upp, anropet returnerade 1.96 och testerna gick igenom.
GDPval är raden båda labben faktiskt delar
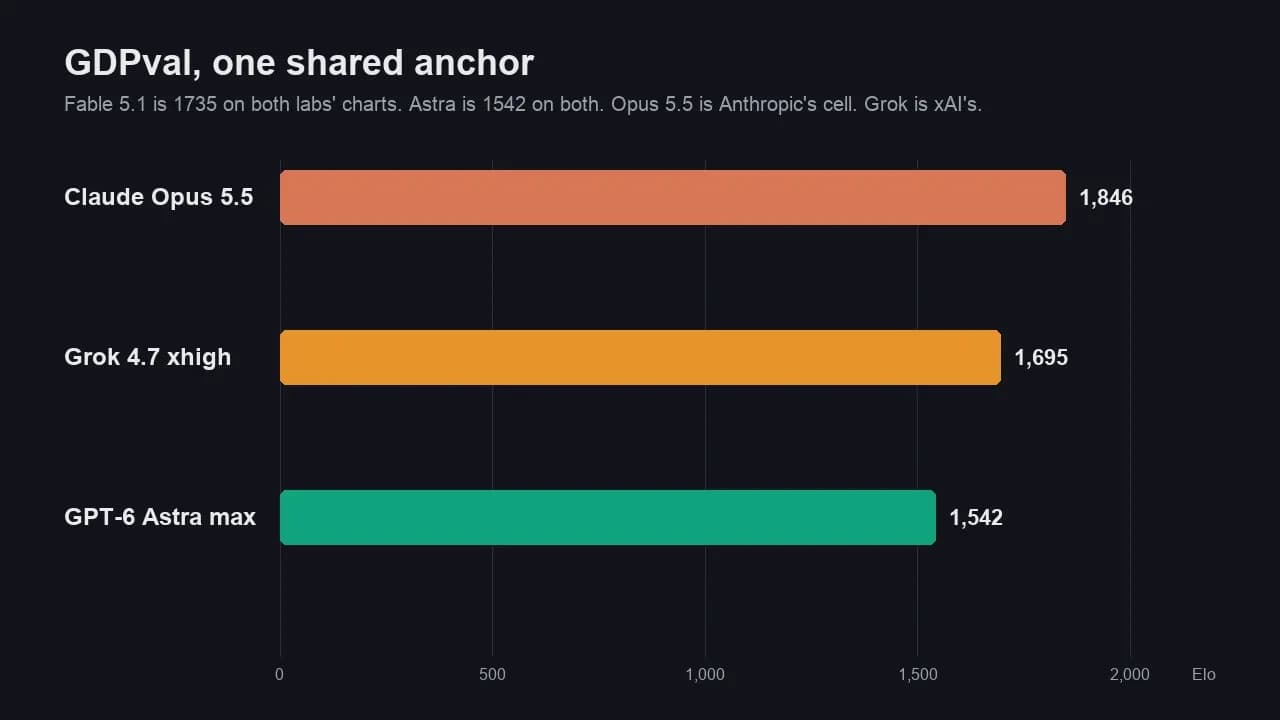
Opus 5.5 leder den delade raden på 1 846. Grok 4.7 xhigh ligger på 1 695. Astra max ligger på 1 542.
Fable 5.1 på 1 735 är ankaret, inte ett fjärde val.
Anthropic skriver ut 1 735, Astra på 1 542 och Opus 5.5 på 1 846. xAI skriver ut samma 1 735 och 1 542, och Grok 4.7 xhigh på 1 695. Två kopierade tal är skälet till att staplarna delar samma axel.
| Cell | Poäng | Vem som publicerade den |
|---|---|---|
| Claude Opus 5.5 | 1 846 | Anthropic, 22 sep 2026, GDPval-AA v2.1 |
| Grok 4.7 xhigh | 1 695 | xAI:s lanseringsdiagram, 21 sep 2026, GDPval |
| GPT-6 Astra max | 1 542 | Båda diagrammen |
| Fable 5.1 max, bara ankare | 1 735 | Båda diagrammen |
Opus ligger 151 Elo över Grok och 304 över Astra. Grok ligger 153 över Astra och 40 bakom Fable-ankaret. Inget av det är vår mätning. Våra sex anrop var en faktura med två decimaler och en merge-funktion. De poängsätter inte kontorsarbete.
Artificial Analysis satte Opus 5.5 på 58 i sitt Intelligence Index vid max effort, och skrev att kostnaden per uppgift låg kvar i nivå med Opus 5 eftersom output-tokens steg ungefär 1,6×. Deras not om Grok 4.7 satte den modellen på 46 i samma index. Annan linjal, samma riktning: Opus före Grok, och inget skäl att strunta i tokenfakturan.
Terminal-Bench och CursorBench är inte samma linjal
Ta inte medelvärdet av Anthropics 66,4 % och xAI:s 38,0 %. Det är inte samma Terminal-Bench-cell.
- Anthropic, Opus 5.5 på xhigh, Astra på high så som OpenAI rapporterade den: Terminal-Bench 4.0 är 66,4 % för Opus 5.5 och 57,9 % för Astra. Fable 5.1 är 55,8 % på den sidan. CursorBench 4.0 är 57,8 % för Opus 5.5 och 51,8 % för Fable. Astras CursorBench-cell är tom.
- xAI:s poängtavla: Terminal-Bench 4.0 är 38,0 % för Grok 4.7 xhigh och 57,9 % för Fable 5.1 Max. CursorBench är 46,3 % för Grok och 51,8 % för Fable. Astra finns inte på den tavlan. Fables CursorBench-cell, 51,8 %, matchar Anthropic. Fables Terminal-Bench-cell gör det inte: 57,9 % där, 55,8 % på Anthropics sida.
- Artificial Analysis, ett tredje upplägg: Opus 5.5 på 59,6 % i Terminal-Bench 4.0, i nivå med Astra på xhigh. Groks förflyttning i det labbets agentkörning gick från 18 % till 33 %, inte 38,0 %.
CursorBench går att ställa mot sig själv, eftersom 51,8 % står där två gånger. Opus 5.5 på 57,8 % leder Fable med 6,0 poäng på Anthropics siffra med högre ansträngning. Grok på 46,3 % ligger 5,5 poäng efter den Fable-cellen. Astra saknar cell. Skriv labbet intill procenten, annars är rangordningen ett kollage.
EEBench, Harvey och HealthBench är xAI-rader. Opus 5.5 och Astra saknas. De ligger kvar i Grok-inlägget. AutomationBench och Terminal-Bench-Science är rader hos Anthropic och OpenAI. Grok saknas. De ligger kvar i Opus-inlägget och Astra-inlägget.
Vad varje befintligt inlägg fortfarande äger
Den här sidan ersätter inte de tre inläggen den länkar till. Den rangordnar bara de tre modellerna mot varandra.
- Opus 5.5-inlägget behåller sänkningen till $4/$20, mätaren på $0.02719, femtimmarsgränsen och cyber-fallback till Opus 4.8. Omslaget är fortfarande Anthropics diagram. Astra-kolumnerna läser du här.
- Grok 4.7-inlägget behåller 4.7 mot 4.6: tolv anrop, 12/12 och tröskeln $2/$6. Stapeln på 1 695 är deras. Opus 5.5 är det inte.
- Astra-inlägget behåller Astra mot Fable 5.1, inklusive HTTP 400 den 4 sep och klyftan 99,9 % mot 62,7 %. Anropsbarheten ändrades den 22 sep. Beslutet om Fable gjorde det inte.
Vilken av de tre du ska fästa
Fäst Grok 4.7 när utdatafakturan är det du betalar för och jobbet ryms i 500 000 tokens. Fäst Opus 5.5 när den delade GDPval-raden är det du betalar för. Fäst Astra när du redan har mätt ett computer use-jobb eller ett matematikjobb av den sorten som de andra två inläggen tar upp, och du kan betala $10/$50.
- Korta anrop utan cache, som de här sex: Grok var billigast totalt, $0.0038784 mot $0.005292 och $0.00709, och den var den dyra på fakturan eftersom resonemanget gick till 295 tokens. Om dina korta anrop liknar
merge_intervalsär det funktionsraden du ska kopiera. Om de liknar ett tal på en rad skrev Opus 46 tokens och vann den raden. - Cache-tunga agenter under 200 000 prompt-tokens: Opus på $0.20 per miljon cachade tokens slår båda. Astra på $1.00 är 5× den raden. Groks cache-rad hos xAI är $0.50, alltså 2,5× Opus.
- Prompter som passerar 200 000 tokens: Grok sätter nytt pris på hela requesten. En prompt på 250 000 tokens på xAI-kortet kostar $4 och $12, inte $2 och $6. Astras tröskel börjar senare, vid 272 000, och den sätter inte nytt pris på tokens under linjen så som Groks dokument beskriver.
- Kontorsarbete du vill låta GDPval avgöra: Opus 1 846, sedan Grok 1 695, sedan Astra 1 542, med Fables 1 735 mellan Opus och Grok. Den ordningen kommer från labben. Den är inte en poäng från de sex anropen.
- Terminalarbete: håll det utanför den här rangordningen. Välj det labb vars runner du faktiskt kör, och använd sedan det labbets siffra. Blandar du 66,4 % med 38,0 % får du inte veta vilken binär du ska anropa.
Vanliga frågor
Kan du anropa GPT-6 Astra på OpenRouter nu?
Ja, från kl. 22:34 UTC den 22 sep 2026. Id:t openai/gpt-6-astra returnerade 1.96 på fakturan och en merge_intervals som klarade de dolda testerna. Den 4 sep returnerade samma id HTTP 400. Det tidigare inlägget dokumenterar den 400:en. Det här dokumenterar anropet som fungerade. Kontexten i listningen var 1 050 000 tokens.
Sänkte xAI priset på Grok 4.7 från $2 och $6?
Inte på det lanseringskort den här sidan citerar. xAI:s tabell är fortfarande $2 och $6 under 200 000 prompt-tokens, sedan $4 och $12. OpenRouters katalog under den här körningen var $1.60 och $4.80, sedan $3.20 och $9.60, alltså 0,8× de raderna. Fakturan för de sex anropen använder OpenRouter-siffran. En faktura du betalar direkt till xAI följer fortfarande xAI:s kort tills de ändrar det.
Varför saknas Grok i Anthropics benchmarkdiagram?
Anthropics diagram från 22 sep jämför Opus 5.5 med Fable 5.1, Opus 5, GPT-6 Astra och GPT-5.6 Sol. Grok är inte en kolumn. xAI:s diagram jämför Grok 4.7 med Grok 4.6, Sol och Fable. Opus 5.5 är inte en kolumn. GDPval är överlappet, eftersom båda sidorna anger Fable till 1 735 och Astra till 1 542.
Säger mätaren med sex anrop att Opus 5.5 är smartare?
Nej. Alla tre klarade båda uppgifterna. Mätaren är en faktura och ett tokenantal. GDPval är labbpoängen, och den sätter Opus 5.5 först av de här tre, på 1 846 mot 1 695 och 1 542. En godkänd merge-funktion bekräftar inte 1 846, och 1 846 förutspår inte fakturan på $0.005292.
Vilken modell har det kortaste kontextfönstret?
Grok 4.7, på 500 000 tokens i OpenRouter-listningen. Opus 5.5 ligger på 1 000 000. Astra ligger på 1 050 000. Grok sätter också nytt pris vid 200 000 prompt-tokens, så det billiga fönstret som går att använda är mindre än 500 000. Astras högre pris börjar vid 272 000 och gäller tokens över den linjen, plus en utdatamultiplikator på 1,5×.