Claude Opus 5.5: pris $4/$20, gränserna och vad vi mätte
Claude Opus 5.5 släpptes 22 sep 2026 till $4 per miljon input-tokens och $20 per miljon output-tokens. Cache-läsningar kostar $0.20. Det är 20 % under Claude Opus 5 på input och output, och 60 % under Opus 5 på cache-läsningar ($0.50). Id på plattformen: claude-opus-5-5. OpenRouter hade redan listat anthropic/claude-opus-5.5 kl. 18:57 UTC, samma tre priser, kontext på 1 000 000 tokens.
Vi skickade nio bedömda anrop mellan kl. 18:57 och 18:58 UTC. Vi matchade åtta av dem mot Opus 5 vid effort=low. Alla åtta gick igenom. Opus 5.5 debiterade $0.010564. Opus 5 debiterade $0.01269.
Ett nionde anrop, Opus 5.5 vid effort=high, gick också igenom och debiterade $0.003936. Summan för experimentet: $0.02719. Omslaget är Anthropics diagram från lanseringssidan, sparat oförändrat.
Claude Opus 5.5: API-pris mot Opus 5
Cache-tung trafik är där det nya kortet märks. Anrop utan cache sjönk bara ungefär 20 % på vår mätare.
Anthropics lanseringstabell, återgiven nedan och i prisskärmdumpen, är standardkortet. Fable 5.1 ligger kvar på $10/$50. Cache-läsningen är $0.25, så Opus 5.5 underbjuder Fable med $0.05 per miljon på den raden, inte med hälften. Gapet på 2,5× gäller input och output: $10/$4 och $50/$20.
| Rad, per 1 miljon tokens | Opus 5.5 | Opus 5 | Fable 5.1 |
|---|---|---|---|
| Indata | $4 | $5 | $10 |
| Utdata | $20 | $25 | $50 |
| Cache-läsning | $0.20 | $0.50 | $0.25 |
| Cache-skrivning, 5 min | $5 | $6.25 | $12.50 |
| Cache-skrivning, 1 timme | $8 | $10 | $20 |
| OpenRouter-batch, input / output | $2 / $10 | $2.50 / $12.50 | $5 / $25 |
| Snabbläge, input / output | $8 / $40 | inte på kortet | inte på kortet |
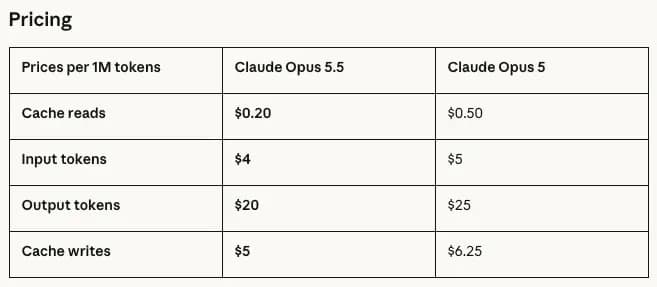
Cache-skrivningen på 5 minuter ($5 mot $6.25) står på Anthropics sida och i noten från Artificial Analysis.
Skrivningen på 1 timme ($8) och batch-rutten ($2/$10, cache-läsning $0.10) kommer från OpenRouters payload för /api/v1/models kl. 18:57 UTC. Lanseringstabellen skriver inte ut de raderna.
Snabbläge (fast mode) finns på lanseringssidan: upp till 2,5× hastighet, på $8 och $40. Det är 2× standardpriset för Opus 5.5, och det ligger över Opus 5:s $5/$25.
Nio bedömda anrop, och fakturan de gav
Alla 8 matchade anrop gick igenom. Opus 5.5 kostade $0.010564 mot Opus 5 på $0.01269, en sänkning på 16,8 %.
OpenRouters chat completions. Ingen temperature angavs. reasoning.effort var low, plus ett kodanrop på high.
Två uppgifter, två försök. Vi bedömde med exakt träff och körda tester. Cachade tokens: 0. Fakturaprompter: 104 tokens.
# 22 Sep 2026, 18:57 UTC, OpenRouter
MODELS = ["anthropic/claude-opus-5.5", "anthropic/claude-opus-5"]
# invoice answer must be 1.96
# 800_000 * 0.20/1e6 + 200_000 * 4/1e6 + 50_000 * 20/1e6
# coding: merge_intervals, hidden tests, function only| Serie | Opus 5.5 | Opus 5 |
|---|---|---|
| Faktura, 2 försök | 2/2, $0.002652, 45 och 46 ut, 3,089s och 5,100s | 2/2, $0.00332, 46 och 46 ut, 6,765s och 3,997s |
| merge_intervals, 2 försök | 2/2, $0.007912, 168 och 168 ut, 3,597s och 3,239s | 2/2, $0.00937, 161 och 155 ut, 3,435s och 3,582s |
| Matchad total | $0.010564, 8/8 | $0.01269, 8/8 |
| effort=high, 1 kodanrop | godkänd, $0.003936, 167 ut, 0 resonemangstokens | kördes inte |
Fakturaparet är det rena fallet på 20 %: 20,1 % billigare, nästan samma antal svarstokens. Funktionsparet är missen: Opus 5.5 skrev 336 svarstokens mot 316, och fakturan sjönk bara 15,6 %. Listpriset sjönk 20 %. Tokenantalet steg. Nettobesparingen krympte. effort=high förlängde inte den funktionen: 167 svarstokens, 0 resonemangstokens, $0.003936, och testerna gick igenom. Artificial Analysis såg det andra läget, ungefär 119 000 output-tokens per uppgift i Intelligence Index på max mot ungefär 73 000 för Opus 5, medan kostnaden per uppgift låg kvar på samma nivå. Räkna inte hem en rabatt på 40 % i det läget. Våra 9 anrop kom aldrig in dit.
Latensen är oavgjord i det här urvalet. Medeltid för kodning, Opus 5.5 och Opus 5: 3,42s och 3,51s. Medeltid för fakturan: 4,09s och 5,38s. Intervallen överlappar, 5,100s mot 3,997s.
Anthropic säger att output är mer än 30 % snabbare än hos Opus 5. De här 9 anropen visar det inte.
Var Anthropics diagram leder, och var det inte leder
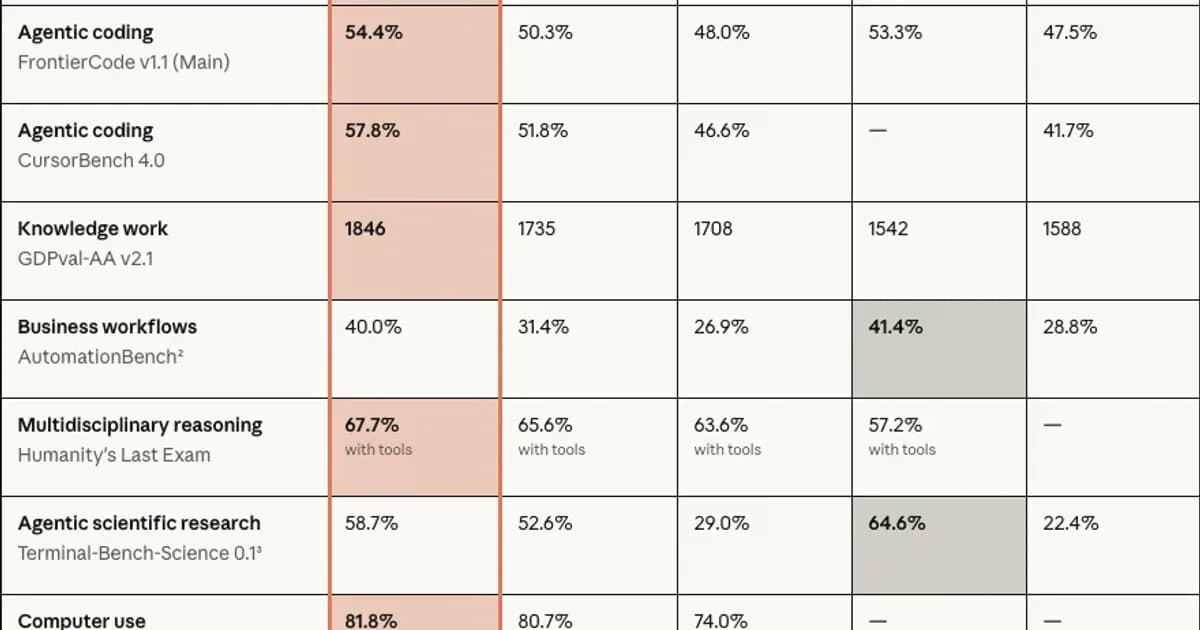
Astra leder två numrerade rader: AutomationBench på 41,4 % och Terminal-Bench-Science på 64,6 %.
I varje annan numrerad cell i diagrammet från 22 sep leder Opus 5.5. Omslagsbilden är det diagrammet. Cellerna nedan är kopierade därifrån.
Anthropic säger att de här siffrorna för Opus 5.5 använder adaptivt tänkande på max effort, med ett förbehåll: Terminal-Bench 4.0 är Opus 5.5 på xhigh och GPT-6 Astra på high, och Astras siffra är den OpenAI rapporterade.
| Benchmark | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 66,4 % | 55,8 % | 52,3 % | 57,9 % | 37,3 % |
| FrontierCode v1.1 (Main) | 54,4 % | 50,3 % | 48,0 % | 53,3 % | 47,5 % |
| CursorBench 4.0 | 57,8 % | 51,8 % | 46,6 % | n/a | 41,7 % |
| GDPval-AA v2.1 | 1846 | 1735 | 1708 | 1542 | 1588 |
| AutomationBench | 40,0 % | 31,4 % | 26,9 % | 41,4 % | 28,8 % |
| Humanity's Last Exam, med verktyg | 67,7 % | 65,6 % | 63,6 % | 57,2 % | n/a |
| Terminal-Bench-Science 0.1 | 58,7 % | 52,6 % | 29,0 % | 64,6 % | 22,4 % |
| OSWorld 2.0, partiell | 81,8 % | 80,7 % | 74,0 % | n/a | n/a |
| Chartography, med verktyg | 89,0 % | 88,4 % | 83,4 % | n/a | n/a |
Läs fotnoterna innan du styr trafik på ett gap på en poäng.
- Skydden var på. Cyber-fallback var Opus 4.8. Biologi och frontier-LLM-fallback var Opus 5. Anthropic säger att det troligen sänker poängen.
- Zapier körde AutomationBench utan fallback, så en intervention räknades som en miss. 40,0 % kommer från tidig åtkomst. Astras 41,4 % är den publika tavlan.
- Felmarginalen på Terminal-Bench 4.0 är ±2,6 poäng. 66,4 mot 57,9 klarar den. FrontierCode 54,4 mot 53,3 gör det inte.
- Anthropic säger att gapet i daglig användning mot Fable 5.1 är smalare än i det här diagrammet.
- Artificial Analysis, samma dag, annan setup: Terminal-Bench 4.0 på 59,6 %, i nivå med Astra på xhigh, och Humanity's Last Exam på 61,4 % mot 59,1 % för Fable 5.1. Ta inte medelvärdet av 66,4 och 59,6.
Standard-effort är en annan rad. FrontierCode på medium är 54,6 %. CursorBench på medium är 52,5 %, inte 57,8 % ovan. Anthropic säger att det medium-resultatet på FrontierCode slår Astras bästa för ungefär en femtedel av kostnaden per uppgift.
Gränser som priset på $4 inte tar bort
Cyberuppgifter styrs om till Opus 4.8, och tänkande är påslaget för varje API-konto.
Det billigare kortet tog inte bort begränsningarna som gjorde de två senaste Claude-lanseringarna krångliga i drift. Vad som ändrades 22 sep, och vad som inte gjorde det:
- Femtimmarsgränserna höjs på Pro, Max, Team och Enterprise per plats, plus en återställning du kan spara. Inget nytt antal meddelanden. Veckotaket beskrivs inte som borta. Äldre regler för fönstret finns i förklaringen av användningsgränserna.
- Skydden för cyber, biologi och destillation matchar Fable-klassen. Vanlig buggfixning blir kvar. De flesta cyberuppgifter styrs om till Opus 4.8. Biologi kräver Life Sciences Verification Program. Det bredare cyberprogrammet var inte öppet på lanseringsdagen.
- Tänkande går inte att stänga av. Lanseringssidan pekar på modelldokumentationen för den begränsningen. Bevarat tänkande (preserved thinking), anti-destillationskontrollen från Fable 5.1, hindrar API-användare från att redigera tidigare resonemang. Det gäller Opus 5.5 på API-konton som skapades 31 aug 2026 eller senare.
- Modellen är vattenmärkt för EU:s AI-förordning. Noll datalagring (zero data retention) erbjuds fortfarande, samma som för tidigare Opus-modeller.
- Försök att ta sig över inneslutningsgränsen föll ungefär 85 % jämfört med Opus 5 och Mythos 5.1, säger Anthropic, och det som blev kvar hade låg allvarlighet och rapporterades av modellen själv. Modellen anar ofta att den sitter i en utvärdering, så den granskningen säger lite om produktion.
- Sonnet 5.5 och Haiku 5.5 finns inte i API:et idag. Sidan säger att de kommer under de närmaste veckorna. Inget datum.
Om din arbetsbelastning är offensiv säkerhet eller våtlabbsdesign är priset $4 inte priset för en obegränsad Opus 5.5. Klassificeraren lägger en del av de anropen på en äldre modell, och ditt anropsspår bör visa fallbacken. Annars debiterar du fel id.
Vad tidiga testare sa till Anthropic
GitHub, Optiver och Box rapporterar färre tokens än Opus 5. Raderna är citat som Anthropic publicerade.
De är signerade noteringar från tidig åtkomst, inte en oberoende resultatlista. @claudeai postade kl. 16:31 UTC. Svaren samma timme berömde utrymmet i Pro och felsökningen. Ingen delad logg.
| Vem, på lanseringssidan | Vad de sa | Vad det inte bevisar |
|---|---|---|
| Mario Rodriguez, GitHub | Färst tokens de mätte. Terminaluppgifter i VS Code på under hälften så många steg som Opus 5. | Ingen publik logg. |
| Noyan Tokgozoglu, Optiver | Opus 5-kvalitet på ungefär hälften av turerna, tiden och output-tokens. Kostnad ned 40 % till 50 %. | Deras tradingdesk. Vår sänkning var 16,8 %, cache på 0. |
| Yashodha Bhavnani, Box | En tredjedel så många tokens, 40 % mindre ordrik, träffsäkerheten höll. | Deras innehållsutvärdering. |
| Zimu Li, Factory | Medium matchade Opus 5 på high, med 20 % till 25 % färre output-tokens. | Vårt anrop på high krympte inte tokenantalet. |
| Fabian Hedin, Lovable | En tredjedel till hälften färre steg, och färre tokens. | Deras byggloop, inte API-kortet. |
Citaten beskriver färre steg och färre tokens, en större sänkning än listprisets 20 %. Vår funktion gjorde tvärtom: 336 svarstokens mot 316.
Båda kan stämma. Anthropic säger att en granskning på 200 000 rader blev klar på under 3 timmar, mot över 20 timmar för Opus 5, med 2,5× färre tokens. Vi körde inte om den.
Vad en cache-tung tur gör med fakturan
En omläsning på 500 000 cache-tokens sjunker från $0.25 på Opus 5 till $0.10 på Opus 5.5.
Det är aritmetik på de publicerade priserna, inte ett av de 9 anropen. De anropen cachade ingenting, så de visar bara sänkningen på 20 % minus extra tokens. Sätt in storleken på ditt eget prefix. Mixen avgör procenten.
| Arbetsbelastning | Opus 5 | Opus 5.5 | Sänkning |
|---|---|---|---|
| 500 000 cache-lästa tokens | $0.25 | $0.10 | 60 % |
| 20 000 ny input + 8 000 output, ingen cache | $0.30 | $0.24 | 20 % |
| 500 000 cache + 20 000 in + 8 000 ut | $0.55 | $0.34 | 38 % |
| Samma 20 000 in + 8 000 ut i snabbläge $8/$40 | n/a | $0.48 | en prishöjning mot standard 5.5 |
38 % på den tredje raden är hur en tokensänkning på 20 % blir ”ungefär 40 % mindre på typiska arbetsbelastningar”: en cache-tung agent, standardinställningar, plus färre tokens. Utan cachen är du tillbaka på 20 % tills modellen pratar mer. Snabbläget går åt andra hållet, $0.48 mot $0.24 på delen utan cache. Batch-raden i pristabellen ($2/$10) är ett katalogpris. Vi skickade inget batch-jobb.
Vilket id du ska låsa efter 22 september
Lås claude-opus-5-5 för ny agenttrafik om uppgiften inte är cyber eller biologi.
Julitexten om Opus 5 prissatte en modell i Fable-klass till hälften av Fables tokenkort. Det priset är inaktuellt sedan 22 sep.
Opus 5.5 ligger ytterligare 20 % under Opus 5 på input och output, och 60 % under Opus 5 på cache-läsningar. Skydden ligger nu på Fable 5.1-nivå, inte på den lösare Opus-linjen. Grok 4.7, mätt samma dag, är ett annat kort.
- Korta API-anrop utan cache, som de vi bedömde: flytta dem till Opus 5.5. Träffgraden var lika, 8/8. Fakturan sjönk 16,8 % på den här serien, och 20,1 % när antalen svarstokens matchar.
- Agentloopar som läser om ett stort prefix: flytta dem också, och lägg budgeten närmare räkneexemplet på 38 % än fakturan på 16,8 %. Bekräfta att
cached_tokensinte är noll i svaret, annars ligger du kvar på spåret med 20 %. - Forskningsutvärderingar på max effort: behåll den gamla Opus 5-budgeten tills du mäter. Kostnaden per uppgift i AA:s Intelligence Index sjönk inte i takt med tokenpriset.
- Cyberoffensiv, biologisk FoU och sondering i destillationsstil: räkna inte med att Opus 5.5 svarar. Räkna med Opus 4.8 eller Opus 5, eller en vägran. Verifieringsprogrammen är dörren Anthropic namngav.
- Snabbläge: betala $8/$40 bara när 2,5× hastighet är värd 2× tokenpris. Det är inte den billiga nivån.
- Låt Fable 5.1 vara låst bara där du har mätt ett kvalitetsgap som de här 9 anropen inte kan se. Fable kostar 2,5× på input och output. Cache-läsningar är $0.25 mot $0.20.
Vanliga frågor
Vilket är API-modell-id:t för Claude Opus 5.5?
På Claude Platform är id:t claude-opus-5-5. På OpenRouter är det anthropic/claude-opus-5.5, batch anthropic/claude-opus-5.5:batch. Vi anropade standard-id:t kl. 18:57 UTC den 22 sep 2026. Listad kontext: 1 000 000 tokens. Snabbläge är ett pris ($8/$40), inte ett andra id på lanseringssidan.
Tar Claude Opus 5.5 bort femtimmarsgränsen?
Nej. Femtimmarsgränsen höjs på Pro, Max, Team och Enterprise per plats, och en återställning kan sparas. Inget antal meddelanden publicerades. Veckotaket beskrivs inte som borttaget. Gränser för tokens per minut i API:et är en separat mätare. Kolla Settings, sedan Usage.
Går det att stänga av tänkande på Opus 5.5?
Anthropic säger nej. Sidan från 22 sep säger att tänkande inte längre går att stänga av. Bevarat tänkande hindrar också konton som skapades 31 aug 2026 eller senare från att redigera tidigare resonemang. Vårt anrop på effort=high returnerade ändå en vanlig funktion, med 0 resonemangstokens i OpenRouters usage-objekt. En låsning på high är inte en synlig tankekedja.
Är sänkningen på 40 % verklig på varje arbetsbelastning?
Inte på vår arbetsbelastning. Åtta anrop utan cache kostade 16,8 % mindre. Bara fakturaparet kostade 20,1 % mindre. Ett räkneexempel med 500 000 cache-lästa tokens plus en kort komplettering landar på en sänkning på 38 %. Artificial Analysis säger att uppgifter i Intelligence Index på max effort kostar ungefär lika mycket som Opus 5, eftersom output-tokens steg ungefär 1,6×.
När kommer Claude Sonnet 5.5 och Haiku 5.5?
Anthropic sa att båda kommer under de närmaste veckorna, på sidan från 22 sep 2026, utan datum. Opus 5.5 var det enda 5.5-id vi kunde anropa den kvällen. En billigare väg som inte är Opus är fortfarande det tidigare kortet för Sonnet eller Haiku.