Claude Sonnet 5.5: samma $2/$10, men de 30 procenten sparas bara på långa jobb
Anthropic släppte Claude Sonnet 5.5 den 28 september 2026 till exakt Sonnet 5:s pris: $2 per miljon input-tokens och $10 per miljon output-tokens. Dagen efter körde vi 19 bedömda anrop via OpenRouter. På en lång HTML-fil sjönk notan med 11,1%. På en liten fakturasumma steg den med 12,8%.
Samma pris. Olika nota.
Vad ändrades när Claude Sonnet 5.5 kom den 28 september?
Byt modell-id till claude-sonnet-5-5 så ligger priset per token kvar på $2 för input och $10 för output.
Anthropics prissida listar Sonnet 5.5 och Sonnet 5 på identiska rader, cache och batch inräknade, så varje kostnadsskillnad mellan dem är ett antal tokens.
| Post | Sonnet 5.5 vid lansering |
|---|---|
| Modell-id i API:et | claude-sonnet-5-5 |
| Input / output, per 1M tokens | $2 / $10 |
| Cache-läsning / cache-skrivning | $0.20 / $2.50 (5 min), $4 (1 timme) |
| Batch input / output | $1 / $5 |
| Kontext / maximal output | 1M / 128K tokens |
| Standardnivå för effort | Medium i Claude Code och apparna, High i API:et |
| Tillgänglighet | Zero data retention; AWS, Google Cloud, Microsoft Azure |
| GitHub Copilot | Pro, Pro+, Max, Business, Enterprise, till listpris |
Källor: Anthropics modellsida för Sonnet 5.5, lanseringsinlägg och GitHubs changelog. Bakgrund: vad Sonnet 5 förändrade och tokenpriser hos olika leverantörer.
Hur nära Opus 5.5 kommer Sonnet 5.5 i Anthropics tabell?
Sonnet 5.5 ligger under tre poäng efter Opus 5.5 på fyra av sex procentrader, och den enda raden där Sonnet vinner ligger inom felmarginalen.
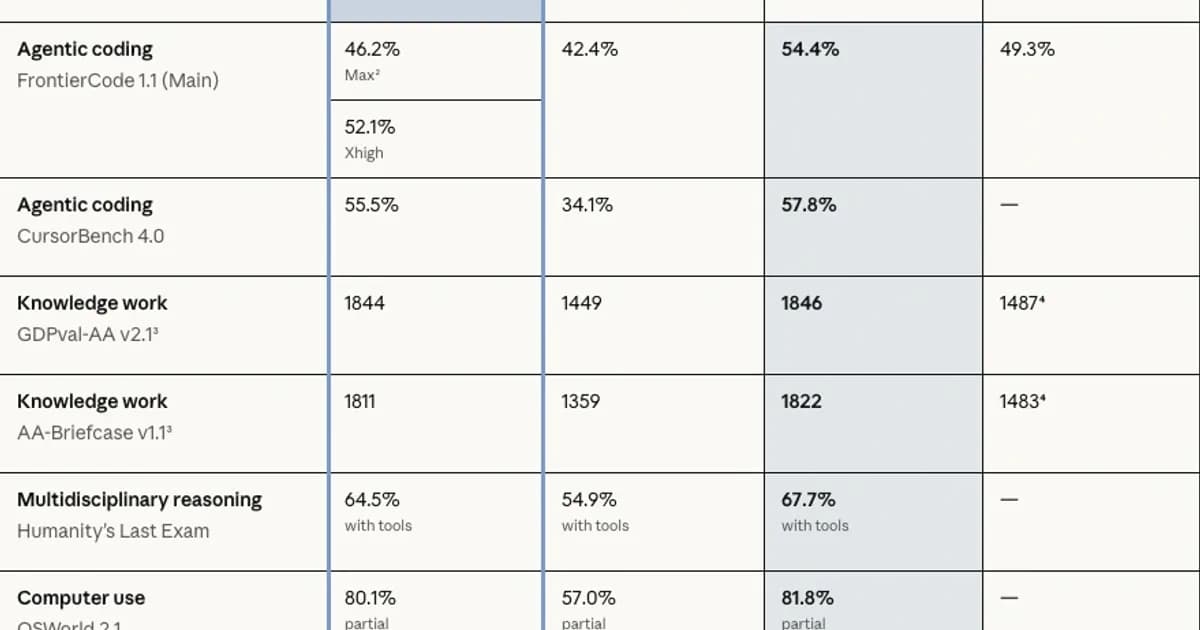
Cellerna är återskrivna från hero-bilden:
| Benchmark | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70,6% | 10,3% | 66,4%¹ | n/a |
| FrontierCode 1.1 Main | 46,2% (Max)², 52,1% (Xhigh) | 42,4% | 54,4% | 49,3% |
| CursorBench 4.0 | 55,5% | 34,1% | 57,8% | n/a |
| GDPval-AA v2.1³ | 1844 | 1449 | 1846 | 1487⁴ |
| AA-Briefcase v1.1³ | 1811 | 1359 | 1822 | 1483⁴ |
| HLE (with tools) | 64,5% | 54,9% | 67,7% | n/a |
| OSWorld 2.1 (partial) | 80,1% | 57,0% | 81,8% | n/a |
| Chartography (no tools) | 61,6% | 15,6% | 64,4% | 53,6%⁴ |
¹ Opus med effort Xhigh. ² Max fick lägre resultat än Xhigh: modellen körde fler subagenter för kodgranskning, vilket enligt Cognition gav timeouts eller ändringar utanför uppdraget i två fall. ³ Körd av Artificial Analysis på en förhandsdeployment med en bugg i strukturerad output, sedan rättad. ⁴ En bildbugg hos GPT-6 Sol kanske inte syns i siffrorna. Anthropics diagram för Terminal-Bench och CursorBench visar GPT-5.6 Sol.
FrontierCode (Xhigh) och CursorBench ligger 2,3 poäng efter, OSWorld 1,7 och Chartography 2,8. HLE är undantaget med 3,2. Elo-raderna ligger 2 och 11 ifrån varandra.
Terminal-Bench-raden matar r/ClaudeCode-tråden ”Sonnet 5.5 beats Opus 5.5 at coding and it's half the price??”. Systemkortet anger standardfel på ±2,5 och ±2,6 poäng, så glappet på 4,2 poäng motsvarar ungefär 1,2 sammanlagda standardfel, och Sonnet kördes på max medan Opus kördes på xhigh. Artificial Analysis mätte Sonnet 5.5 till 64% på samma test. Opus största försprång står inte på lanseringssidan: SWE-Bench Pro, 81,3 mot 89,9.
GPT-6 Sol är bara den kolumn Anthropic valde att trycka. Hur GPT-6 Astra står sig mot Opus 5.5 ser du i vårt test av alla tre.
Håller Anthropics 30 procent i 19 API-anrop?
Bara på det långa jobbet: 11,1% billigare på en HTML-uppgift med i snitt 2 564 output-tokens, och 10-13% dyrare på två små uppgifter.
Den 29 september kl. 14:25 UTC skickade vi 19 bedömda anrop via OpenRouter till Sonnet 5.5 och Sonnet 5: 3 uppgifter, 3 försök, 2 modeller, plus ett extra anrop med hög effort. Total kostnad: $0.183434. Alla 18 matchade anrop klarade bedömningen.
# sonnet55_bench.py, 29 Sep 2026, POST https://openrouter.ai/api/v1/chat/completions
body = {
    "model": model,        # anthropic/claude-sonnet-5.5 or anthropic/claude-sonnet-5
    "messages": messages,
    "max_tokens": max_tokens,         # 12000 on the HTML task
    "reasoning": {"effort": effort},  # low: invoice, merge_intervals; medium: HTML
}
Ingen språkmodell bedömde något. Fakturan (800k cache-läsning, 200k input, 50k output-tokens) skulle returnera exakt 1.06, merge_intervals körde 6 exekverade asserts, och HTML-filen krävde doctype, canvas, requestAnimationFrame och inget externt script. Kostnaderna är usage.cost summerat över 3 försök.
| Uppgift (effort) | Sonnet 5.5 | Sonnet 5 | Skillnad | Snitt output-tokens | Snittlatens |
|---|---|---|---|---|---|
| Faktura (low) | $0.002754 | $0.002442 | +12,8% | 71 / 61 | 2,63 s / 4,49 s |
| merge_intervals (low) | $0.006054 | $0.005502 | +10,0% | 172 / 154 | 3,06 s / 3,68 s |
| HTML med 150 fåglar (medium) | $0.077508 | $0.087156 | -11,1% | 2 564 / 2 886 | 15,54 s / 21,61 s |
| Matchad summa | $0.086316 | $0.0951 | -9,2% | n/a | n/a |
Anthropic lovar ”up to 30% less per task than its predecessor”, alltså upp till 30% lägre kostnad per uppgift än föregångaren. Matthias Bastian på The Decoder la till den rätta reservationen: ”Independent testing still needs to confirm these claims.”
I vår mätning med 19 anrop på låg och medelhög effort, med en enda lång uppgift, blev besparingen -11,1% på HTML-uppgiften och vände till +12,8% och +10,0% på de små. Samma listpris betyder att varje besparing är ett tokenantal, och på våra två minsta uppgifter skrev Sonnet 5.5 fler tokens, inte färre.
Hastigheten höll bättre. Latensen på HTML-uppgiften föll med 28,1%, och genomströmningen steg från 133,5 till 165,0 tokens per sekund (+23,6%): rätt riktning, en bit under 30%. Sonnet 5 loggade dessutom 54-63 reasoning-tokens per fakturaanrop, medan Sonnet 5.5 loggade 0 på alla 10 anrop.
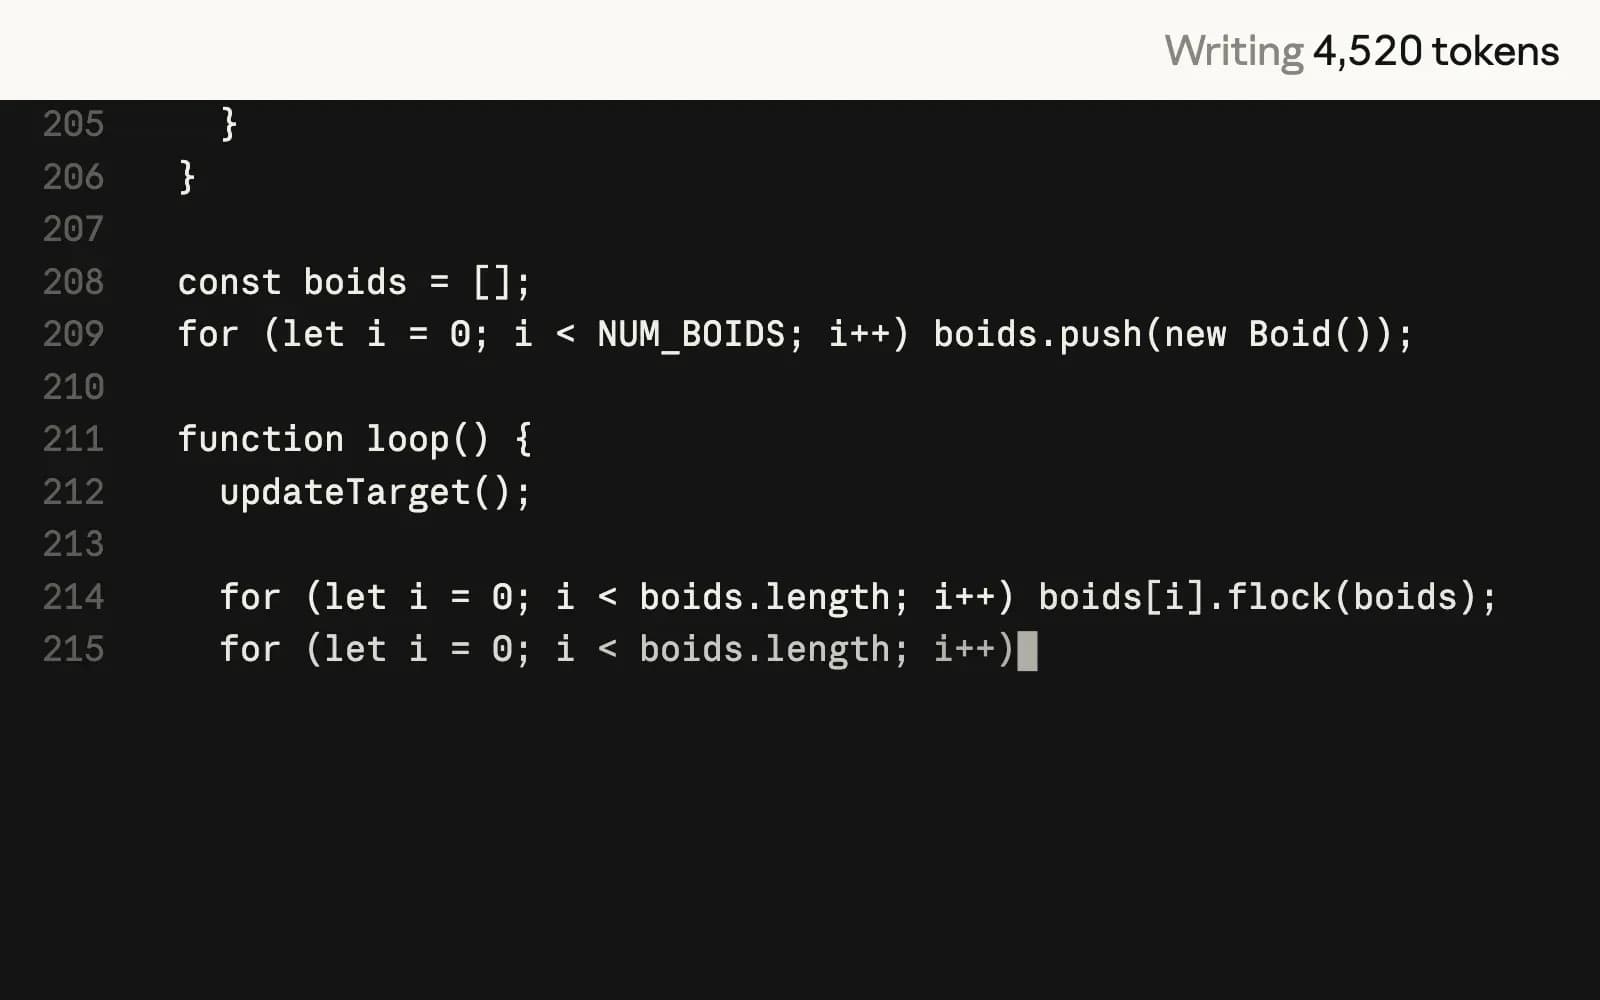
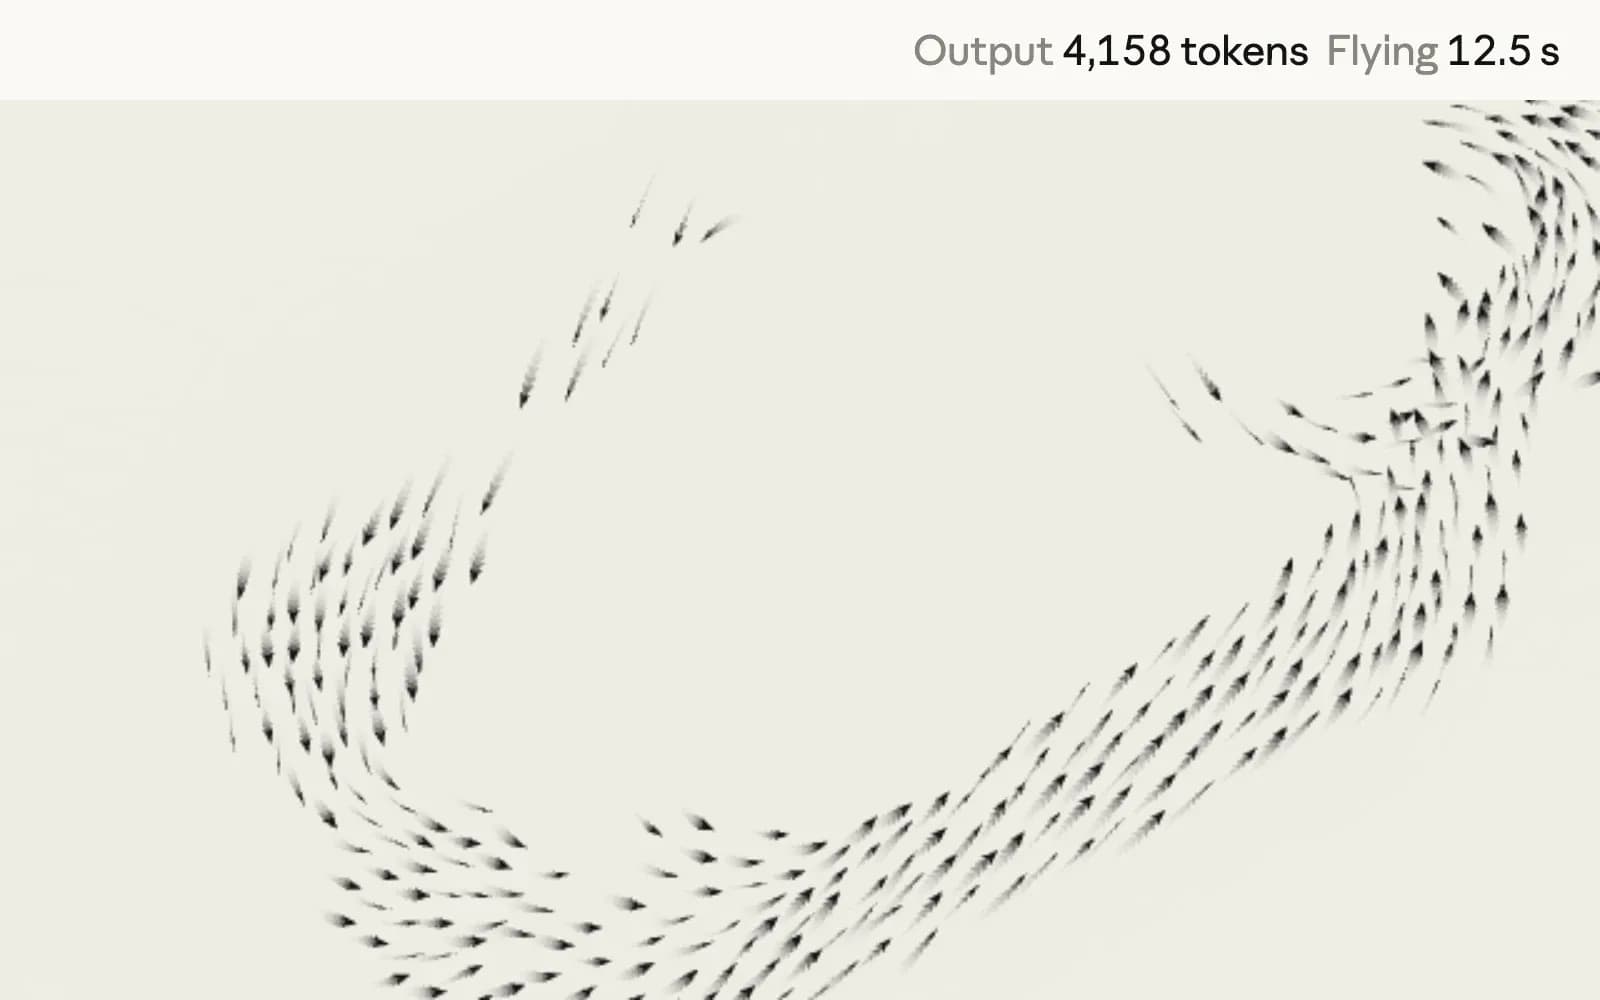
HTML-uppgiften är en version med 150 fåglar av Anthropics demo-prompt med 400 stararna på lanseringssidan. Bildrutorna nedan är Anthropics inspelning, inte vår körning.
Vad Anthropics lanseringstestare rapporterade
”Utan att ändra någon av våra prompts presterade Claude Sonnet 5.5 bättre än Sonnet 5 på nästan alla våra offline-evals för Slackbot, i färre steg och med ungefär 14% färre output-tokens.” Curtis Allen, Principal Engineer, Slack
”Den nya modellen hanterade tiotusentals rader kod för spelsystemets arkitektur, höll svaren snabba, klarade uppgifter som pågick i flera timmar och levererade med mindre detaljstyrande prompts.” Daniel Vogel, Chief Operating Officer, Epic Games
Båda citaten är insamlade av leverantören, och båda beskriver långa arbeten i flera steg. Våra små uppgifter gick åt andra hållet.
Inte mätt: agentiskt arbete, benchmarkresultaten ovan, cyber-fallbacken. Tre försök är en stickprovsmätning. Vill du köra din egen, läs usage på varje anrop.
Varför påverkar effort-nivån notan mer än modellen?
Artificial Analysis mätte $0.59 per uppgift på medium och $7.60 på max, ett hopp på 13 gånger för 15 indexpoäng.
På max räknade de ”~193k Output Tokens per Intelligence Index Task. This is the highest token use we have measured”.
| Effort | AA-kostnad per uppgift | AA Intelligence Index | AA-placering, 29 sep |
|---|---|---|---|
| Low | $0.41 | 36 | 63 av 216 |
| Medium | $0.59 | 41 | 44 av 216 |
| High | $1.08 | 47 | 23 av 216 |
| Max | $7.60 | 56 | 3 av 216 |
Raderna kommer från AA:s modellsidor per effort, hämtade den 29 september. AA:s lanseringsartikel sa att Sonnet 5.5 hamnade på andra plats i indexet, men modellsidan visade 56, plats 3 av 216, samma dag. Max kostade dessutom ”~50% higher than Sonnet 5's Cost per Task”.
Vårt eget anrop med hög effort ignorerade inställningen: merge_intervals med effort=high kostade $0.002018 för 172 output-tokens, identiskt med low. Effort spelar bara roll när jobbet är stort nog att tänka på, och där börjar arbetet med att sänka LLM-API-kostnaderna.
Vad ger 400 när du har bytt modell-id?
Varje anrop med thinking avstängt misslyckas: ändra till between_tools och håll effort på high eller lägre.
Anthropics migreringsguide visar felet:
# Before (Sonnet 5 habit): 400 invalid_request_error on claude-sonnet-5-5
thinking = {"type": "disabled"}
# '"thinking.type.disabled" is not supported for this model. Use
#  "thinking.type.between_tools" for the lowest thinking setting, ...'

# After: accepted at low / medium / high effort, 400 at xhigh / max
thinking = {"type": "between_tools"}
output_config = {"effort": "medium"} # fixed for the conversation under between_toolstool_choicemed värdetanyellertoolger 400. Användautoplusstrict: true(högst 20 strikta verktyg), eller baraautopå Amazon Bedrock.- Thinking-block från Opus 5, Opus 5.5, Fable eller Mythos tas bort tyst. Konton som skapades den 31 augusti 2026 eller senare får 400 om du spelar upp ett block efter att ha redigerat historiken. Mekaniken liknar hur Fable 5.1 binder thinking-block.
- Computer use kräver
computer_toolset_20260801på Google Cloud och i Claude API. - Avslag anger en
stop_details-kategori, bland annatcyber,frontier_llm(”could assist the development of competing AI models”) ochreasoning_extraction. - Fallback på serversidan (
fallbacks: "default", beta, bara Claude API) försöker igen med Sonnet 5 närcyberochfrontier_llmavslås. Enligt systemkortet föll 1,2% av Terminal-Bench-anropen tillbaka. - Minsta cachebara prompt sjunker till 512 tokens från 1 024 (minimigränser för prompt caching), och
/claude-api migratei Claude Code genomför de här ändringarna.
Säkerhetsteam träffas av punkt 4 först. En HN-kommentator, johnmlussier, skrev att han trots deltagande i Cyber Verification Program ”can't use Opus 5.5 or Sonnet 5.5 for any authorized bounty work”, alltså inte kan använda någon av modellerna för godkänt bounty-arbete. Anthropic säger att det utökade programmet kommer ”Soon”.
Samma checklista säger ”Re-run your effort sweep, and re-baseline cost”. Gör det innan du litar på de 30 procenten.
Sonnet 5.5 eller Opus 5.5: vilken ska vara standard?
Välj Sonnet 5.5 som standard för avgränsad kodning och anrop i hög volym, och behåll Opus 5.5 för öppet omdöme och allt arbete på max effort.
Sonnet listas till hälften av Opus 5.5:s $4/$20, men Artificial Analysis mätte Sonnet på max till $7.60 per uppgift mot $5.98 för Opus 5.5, ungefär 27% mer.
| Signal | Sonnet 5.5 | Opus 5.5 | Fördel |
|---|---|---|---|
| Input / output per 1M | $2 / $10 | $4 / $20 | Sonnet, halva priset |
| Cache-läsning / 5-min-skrivning | $0.20 / $2.50 | $0.20 / $5 | Lika på läsningar |
| Cachetung mix (nedan) | $1.06 | $1.96 | Sonnet, 1,85x och inte 2x |
| AA-kostnad per uppgift, max effort | $7.60 | $5.98 | Opus, 27% billigare |
| SWE-Bench Pro | 81,3% | 89,9% | Opus med 8,6 poäng |
Mix: 800k cache-read + 200k input + 50k output tokens
Sonnet 5.5: 0.8 x $0.20 + 0.2 x $2 + 0.05 x $10 = $0.16 + $0.40 + $0.50 = $1.06
Opus 5.5:   0.8 x $0.20 + 0.2 x $4 + 0.05 x $20 = $0.16 + $0.80 + $1.00 = $1.96
Ratio: 1.96 / 1.06 = 1.85x
Aleksei Aleinikovs ”approximately 1.65×” bygger på en mix han inte anger. Sätt in din egen: ju större cacheandel, desto mindre är Sonnets försprång.
Anthropic säger själva att ”Opus 5.5 remains clearly stronger at complex, open-ended work requiring sustained judgment.” En HN-kommentator, datadrivenangel, gick längre: ”Opus 5.5 on Low seems smarter, cheaper, and faster than sonnet on medium”. Otestat av oss. Opus priser och gränser finns i vår genomgång av Opus 5.5.
Vårt standardval från och med den 29 september: claude-sonnet-5-5 på medium effort. Jobb på max effort går till Opus 5.5, eftersom Sonnet på max inte längre är den billiga modellen.
För svenska köpare: alla priser här är listpriser i USD. Lägg på 25% moms och räkna om till kronor med dagens kurs, eftersom vi inte anger något SEK-belopp som riskerar att bli inaktuellt.
Vanliga frågor
När släpptes Claude Sonnet 5.5?
Anthropic släppte Claude Sonnet 5.5 den 28 september 2026 som claude-sonnet-5-5, samma dag på Amazon Web Services, Google Cloud, Microsoft Azure och GitHub Copilot. Enligt Anthropics dokumentation dras den inte tillbaka före den 28 september 2027.
Är Claude Sonnet 5.5 billigare än Sonnet 5?
Inte per token: båda listas till $2 för input och $10 för output. I vår mätning kostade en lång HTML-uppgift 11,1% mindre på Sonnet 5.5 och en liten fakturauppgift 12,8% mer. På max effort mätte Artificial Analysis ungefär 50% högre kostnad per uppgift.
Kan jag använda Sonnet 5.5 i Claude Code och GitHub Copilot?
Ja. Claude Code använder Medium effort som standard, API:et High. I GitHub Copilot, från Pro till Enterprise, är den ”billed at provider list pricing under usage-based billing”. Vill du låsa modellen kan du läsa hur du byter modell i Claude Code.
Hur stort är Sonnet 5.5:s kontextfönster och vilket är knowledge cutoff?
Modellen tar 1M tokens kontext och returnerar upp till 128K tokens output, med en tillförlitlig knowledge cutoff i juni 2026 enligt systemkortet.
Finns det en Haiku 5.5?
Inte per den 29 september 2026. Anthropic sa den 28 september att Claude Haiku 5.5 ”will join the Claude 5.5 family in the coming weeks.”