Grok 4.7 vs Grok 4.6: mismos $2/$6, y el marcador se parte por tarea
Grok 4.7 salió el 21 de septiembre de 2026 a $2 por millón de tokens de entrada y $6 por millón de salida, la misma tarifa que Grok 4.6. En el marcador de SpaceXAI, 4.7 se queda con todas las filas frente a 4.6, y luego pierde cuatro de esas siete contra Fable 5.1 Max. Guardamos los dos gráficos de la página de lanzamiento y enviamos 12 llamadas evaluadas por OpenRouter el 22 de septiembre, de 14:51 a 14:53 UTC.
Dónde Grok 4.7 le gana de verdad a Grok 4.6
Enruta el trabajo eléctrico, el de agente jurídico y el de terminal hacia Grok 4.7, y deja los ítems clínicos en Fable 5.1 o en GPT-5.6 Sol.
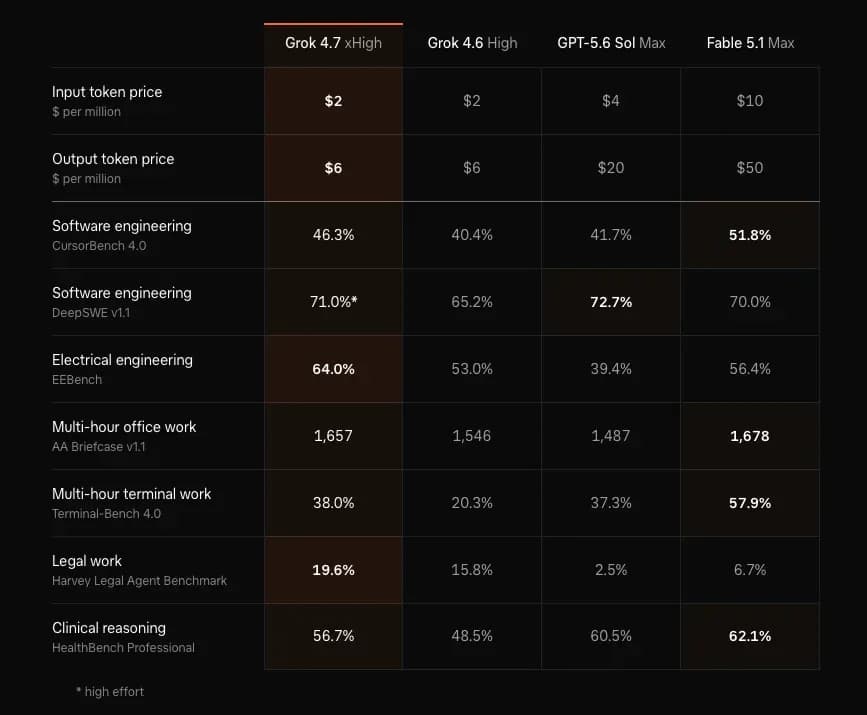
Cada cifra de la columna del líder sale de la nota de lanzamiento del 21 de septiembre, consultada el 22 de septiembre de 2026. La última fila es nuestra.
| Trabajo | Líder en esa fila | Grok 4.7 | Ruta |
|---|---|---|---|
| EEBench | Grok 4.7 xHigh | 64,0 % | Grok 4.7 |
| Agente jurídico Harvey | Grok 4.7 xHigh | 19,6 % | Grok 4.7, y dile al usuario que el 80,4 % sigue fallando |
| Terminal-Bench 4.0 | Fable 5.1 Max, 57,9 % | 38,0 % | 4.7 si dejas 4.6; Fable cuando la puntuación es el producto |
| CursorBench 4.0 | Fable 5.1 Max, 51,8 % | 46,3 % | Fable, salvo que $6 de salida compensen una brecha de 5,5 puntos |
| DeepSWE v1.1 | GPT-5.6 Sol Max, 72,7 % | 71,0 % en high, no en xHigh | Sol, o 4.7 si 1,7 puntos no justifican $20 de salida |
| AA Briefcase v1.1 | Fable 5.1 Max, 1.678 | 1.657 | Fable, por 21 Elo, o 4.7 si manda la factura de salida |
| HealthBench Professional | Fable 5.1 Max, 62,1 % | 56,7 % | Fable o Sol (60,5 %), no 4.7 |
| Cuatro llamadas cortas, nuestras | Empate | 4/4 | Quédate con el cliente que ya tienes |
Grok 4.6 High queda por debajo de 4.7 en las siete filas publicadas. Ahí se acaba la mejora frente al modelo que ya tienes en marcha. Frente a Fable no hay mejora que valga en el editor, el trabajo de oficina, la terminal ni los ítems clínicos.
Qué miden de verdad los dos gráficos de SpaceXAI
La columna naranja es xHigh, el esfuerzo por defecto de la API es high, y el 71,0 % de DeepSWE está marcado como high.
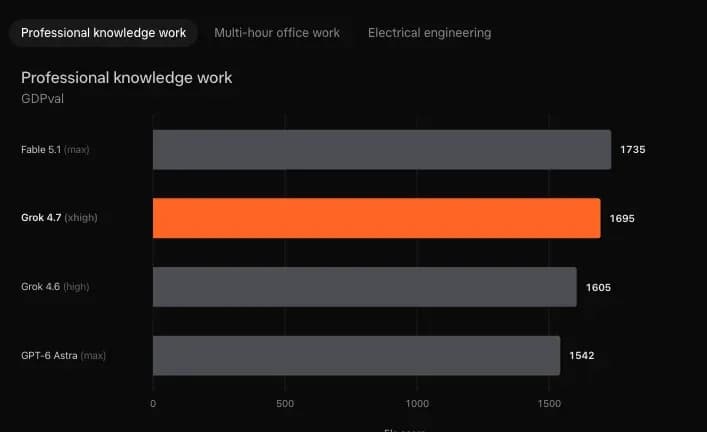
GDPval pone a Fable 5.1 max en 1.735 Elo, a Grok 4.7 xhigh en 1.695, a Grok 4.6 high en 1.605 y a GPT-6 Astra max en 1.542. Eso es +90 Elo sobre 4.6, 40 Elo por detrás de Fable y 153 Elo por delante de Astra. En este gráfico el nombre de OpenAI es Astra. En el marcador el nombre de OpenAI es GPT-5.6 Sol Max. Son modelos distintos, y la página de lanzamiento usa los dos.
- Lee la columna naranja como xHigh. docs.x.ai fija el esfuerzo por defecto en high.
- Lee el 71,0 % como esfuerzo high. El asterisco está en esa celda de DeepSWE y en ninguna otra celda de Grok 4.7.
- Deja el 1.542 de Astra en el gráfico de Elo. No lo pegues en la columna de Sol.
Artificial Analysis desglosa la ganancia en el trabajo de oficina. En AA-Briefcase, la calidad analítica pasó de 1.690 Elo en Grok 4.6 high a 1.994 en Grok 4.7. La calidad de presentación pasó de 1.519 a 1.499. Los documentos quedaron más finos en el análisis y un poco peores como documentos.
CursorBench es la suite de Cursor. SpaceX acordó comprar al fabricante de Cursor, Anysphere, por $60B en acciones el 16 de junio de 2026.
Grok 4.7 está en la API como grok-4.7, en Cursor, y es el modelo por defecto de Grok Build. El artículo del 12 de agosto, Grok 4.6 frente a Grok 4.5, decía que 4.7 todavía no había salido. Esa frase era cierta el 12 de agosto. Dejó de serlo el 21 de septiembre.
Qué dejan fuera del cartel los $2 y los $6
Un prompt de 250.000 tokens se factura a $4 y $12, y esa tarifa cae sobre todos los tokens de la petición.
El gráfico marca $2 y $6. La página de modelos marca dos filas. Por debajo de 200.000 tokens de prompt, las tarifas son $2 de entrada, $0.50 de entrada en caché y $6 de salida. Desde 200.000 hacia arriba, toda la petición pasa a $4, $1 y $12.
prompt, output = 250_000, 2_000
chart_rate = prompt / 1e6 * 2 + output / 1e6 * 6     # $0.512
cliff_rate = prompt / 1e6 * 4 + output / 1e6 * 12    # $1.024
Cruzar la línea duplica una factura que el gráfico nunca enseña. $0.512 pasa a $1.024. Los tokens por debajo de 200.000 no se quedan con la tarifa barata.
La entrada a $2 es la mitad de los $4 de GPT-5.6 Sol y la quinta parte de los $10 de Fable 5.1. La salida a $6 sale 3,3× más barata que los $20 de Sol y 8,3× más barata que los $50 de Fable. Por cada dólar de salida son 166.667 tokens en Grok, 50.000 en Sol y 20.000 en Fable. «La mitad del precio» cuadra con la fila de entrada frente a Sol. No cuadra con ninguna de las dos filas de salida.
La entrada en caché se mantiene en $0.50 por millón por debajo de 200.000 tokens, la misma cifra que en Grok 4.6, y sube a $1 en el salto. Cómo esa línea de caché aparece en una factura real es el tema de la guía de coste de inferencia.
Grok 4.7 Fast es otro modo: el doble de velocidad de salida al doble de precio por token, dentro de Cursor y de Grok Build. No coincide con el salto de los 200.000 tokens, y la API pública no lo vende.
Artificial Analysis midió los prompts largos en unos 188 tokens por segundo y unos 7,1 minutos por tarea del Intelligence Index. Nuestra mediana en llamadas cortas fue de 5,02 segundos en Grok 4.7 high, frente a 8,12 segundos en Grok 4.6 high. Ninguna de las dos cifras sostiene una velocidad 2× frente a Fable o a Sol.
Qué devolvieron 12 llamadas a Grok 4.7 el 22 de septiembre
Las doce llamadas salieron 12/12, y xhigh devolvió las mismas cuatro respuestas que high.
Mismos cuatro prompts, temperature 0, max_tokens 4000, un ensayo cada uno, sin herramientas. Grok 4.6 en high, Grok 4.7 en high, Grok 4.7 en xhigh. La pasarela fue OpenRouter, el mismo esquema de nuestra comparación de pasarelas LLM. Los objetos usage sin procesar están en benchmark-raw.json, junto a este post. El usage.cost de OpenRouter para las doce llamadas sumó $0.029279.
{
  "model": "x-ai/grok-4.7",
  "temperature": 0,
  "max_tokens": 4000,
  "reasoning": {"effort": "xhigh"},
  "messages": [{"role": "user", "content": "..."}]
}| Tarea | Esperado | 4.6 high | 4.7 high | 4.7 xhigh |
|---|---|---|---|---|
| Mediana de 3, 1, 4, 1, 5 y 9 | 3,5 | 3,5; 6,17 s; 348 tok | 3,5; 5,42 s; 359 tok | 3,5; 4,67 s; 300 tok |
| 2,2 kΩ a 5 mA | 11 V | 11; 8,06 s; 511 tok | 11; 4,62 s; 273 tok | 11; 5,31 s; 348 tok |
| Reintentar 429 y 503, nunca 500 | 429,503 | 429,503; 78,30 s; 451 tok | 429,503; 3,37 s; 216 tok | 429,503; 2,07 s; 87 tok |
count_passed([59, 60, 100, 0]) con el bucle que empieza en el índice 1 | 2 | 2; 8,18 s; 466 tok | 2; 6,10 s; 409 tok | 2; 5,16 s; 368 tok |
Los tokens de completado bajaron de 1.776 en Grok 4.6 high a 1.257 en Grok 4.7 high y a 1.103 en xhigh. Los tokens de razonamiento, incluidos en esos totales de completado, fueron 1.543, luego 1.052 y luego 944. La factura de OpenRouter se movió con ellos: $0.012258, luego $0.008877 y luego $0.008144. Eso supone un 29,2 % menos de tokens de completado en high, y una factura un 27,6 % más baja, en una prueba que los dos modelos cerraron 4/4.
prompt_tokens en Grok 4.7 volvió exactamente 1.036 por encima de la llamada emparejada de Grok 4.6 en high: 1.311 frente a 275, 1.288 frente a 252, 1.295 frente a 259 y 1.339 frente a 303. xhigh sumó un token más en cada llamada. A $2 por millón, 1.036 tokens cuestan $0.002072. La partida mediana salió a $0.002446 en 4.6 y a $0.002438 en 4.7 high, así que la brecha no llegó a la factura. Las cuatro facturas de Grok 4.6 sí coinciden con $2 y $6 sobre los recuentos que devolvió. No hay una línea de factura para ese millar de más.
El ensayo de 78,30 segundos es un prompt y un intento. Grok 4.7 high respondió ese mismo prompt de reintentos en 3,37 segundos, y xhigh en 2,07. Los tres devolvieron 429,503. La latencia mediana de los cuatro prompts fue de 8,12 s, 5,02 s y 4,92 s. No conviertas ese único ensayo lento en un ratio de velocidad.
En el trabajo largo el reparto de tokens se invierte. Artificial Analysis informó de unos 81.000 tokens de salida por tarea del Intelligence Index para Grok 4.7 en xhigh, frente a unos 36.000 de Grok 4.6 en high. Nuestra mediana de 316 tokens describe cuatro respuestas cortas. No describe un Briefcase de varias horas.
De dónde sale el 38,0 % en Terminal-Bench
Tres cifras publicadas de Terminal-Bench 4.0 no coinciden: 38,0 %, 33 % y una subida de 4,5 puntos.
- La tabla de lanzamiento de xAI, la captura de arriba: Grok 4.7 xHigh 38,0 %, Grok 4.6 High 20,3 %, GPT-5.6 Sol Max 37,3 %, Fable 5.1 Max 57,9 %. Frente a 4.6 eso es 1,87×, o +17,7 puntos. Frente a Sol son +0,7 puntos. Fable lidera por 19,9 puntos.
- Artificial Analysis, con Grok Build como agente, el 21 de septiembre de 2026: Terminal-Bench 4.0 del 18 % al 33 %, y DeepSWE v1.1 del 65 % al 73 %. Su Coding Agent Index pasó de 47 a 56 y quedó cuarto, por detrás de Fable 5.1, GPT-6 Astra y Claude Opus 5.
- El Intelligence Index del mismo laboratorio, con un ejecutor compartido para cada modelo: Terminal-Bench 4.0 sube 4,5 puntos, y el índice sube 2 puntos, hasta 46. AA-LCR bajó 3,7 puntos. AutomationBench-AA bajó 1,1 puntos.
xAI no dice qué agente hay detrás del 38,0 %. Quédate con la cifra que encaje con tu cliente. El análisis de Fable 5.1 registra un 55,8 % de Fable en Terminal-Bench 4.0, frente al 57,9 % de este marcador. El índice de código de Astra va en el artículo de GPT-6 Astra. En esta página basta la barra de 1.542 Elo.
Qué trabajo debe salir de Grok 4.6
Las llamadas cortas y estructuradas pueden quedarse, y conviene mover el trabajo de terminal, el eléctrico y el de agente jurídico.
Fable sigue por delante en CursorBench 4.0 por 5,5 puntos: 51,8 % frente a 46,3 %. HealthBench Professional sigue con Fable en el 62,1 % y Sol en el 60,5 %, y Grok 4.7 en el 56,7 %. Esas dos filas explican por qué «cambia todo» es el orden equivocado.
| Si el trabajo se parece a esto | Conserva | Pasa a Grok 4.7 cuando |
|---|---|---|
| Una transformación corta y evaluada, como los cuatro prompts de arriba | El modelo que ya tienes integrado | La única queja es la factura de tokens de completado. La nuestra bajó un 29,2 % en high |
| Trabajo de shell con la forma de Terminal-Bench 4.0 | Fable 5.1, si el 57,9 % es el requisito | Dejas el 20,3 % de Grok 4.6 y puedes vivir con el 38,0 % |
| Circuitos y unidades con la forma de EEBench | Nadie en este marcador supera el 64,0 % | Siempre, en esta tabla |
| Un bucle de agente jurídico con la forma de Harvey | Nadie en este marcador supera el 19,6 % | Siempre en esta tabla, con la tasa de fallo del 80,4 % en el contrato |
| Documentos de varias horas, AA Briefcase | Fable, 21 Elo por delante, en 1.678 | Manda el precio de salida: $6 frente a los $50 de Fable |
| Tareas de editor, CursorBench 4.0 | Fable, en el 51,8 % | Una brecha de 5,5 puntos sale más barata que una tarifa de salida 8,3× |
| Ítems clínicos, HealthBench Professional | Fable o Sol | No te muevas por la puntuación. El 56,7 % va por detrás de los dos |
La tarifa de salida de $50 de Fable es 8,3× los $6 de Grok. Paga ese múltiplo cuando la fila es el producto. La misma elección, escrita como configuración de un router, está en la guía de enrutamiento de modelos. El 19,6 % de Harvey lidera este marcador y aun así falla en el 80,4 % del conjunto.
Qué no puede decirte esta medición
Cuatro prompts, un ensayo cada uno, no dicen nada de CursorBench 4.0 ni de una tarea de oficina de 7 minutos.
- La
temperaturefue 0,max_tokensfue 4000, las herramientas estaban apagadas y no reintentamos nada. Un segundo ensayo de la llamada de 78,30 segundos podría haber salido normal. - No llamamos a Fable 5.1, ni a GPT-5.6 Sol, ni a GPT-6 Astra. Esas celdas son citas de xAI y de Artificial Analysis.
- La brecha de 1.036 tokens de prompt es un hecho contable. Nada en la respuesta nombra esos tokens, y la factura no sumó los $0.002072 del precio de lista.
- Artificial Analysis registró regresiones, no solo subidas: AA-LCR bajó 3,7 puntos, AutomationBench-AA bajó 1,1, y la calidad de presentación en AA-Briefcase pasó de 1.519 Elo a 1.499.
- La precisión de AA-Omniscience fue del 47 % en Grok 4.7, frente al 48 % de Grok 4.6 high. La tasa de alucinación en ese conjunto bajó del 34 % al 29 %.
Usa 4.7 donde la fila se movió y la tasa absoluta pueda quedar junto al nombre de un cliente. Deja los ítems clínicos en Fable o en Sol. Deja xhigh fuera hasta que una tarea evaluada cambie la respuesta. Estas cuatro no la cambiaron.
Preguntas frecuentes
¿Cuál es el corte de conocimiento de Grok 4.7?
docs.x.ai sitúa el corte en mayo de 2026. Este lanzamiento del 21 de septiembre no está en los pesos. La búsqueda web y la búsqueda en X son herramientas distintas en esa misma página. Una petición sin ellas responde con lo que había en mayo de 2026. Pasa la fuente en el prompt si el dato es posterior.
¿El endpoint de EE. UU. cambia el precio del token?
La URL base de la región de EE. UU. es https://us.api.x.ai/v1. docs.x.ai le pone un recargo del 10 % para que la inferencia se quede en Estados Unidos. Un token de salida de $6 pasa allí a $6.60, y un token de entrada de $2 pasa a $2.20. El id del modelo sigue siendo grok-4.7. El salto de 200.000 tokens y la tarifa de entrada en caché se suman a ese recargo.
¿La API acepta una imagen?
Sí. La página del modelo lista entrada de texto y de imagen, con salida solo de texto, una ventana de contexto de 500.000 tokens y sin tope en la salida de texto. Las imágenes aceptadas son jpg o png, hasta 20 MiB cada una, sin un tope de cantidad declarado. La respuesta es texto. Generar imágenes sigue en los modelos Imagine, con su propia lista de precios.
¿Dónde corre de verdad Grok 4.7 Fast?
Fast usa los mismos pesos en máquinas más rápidas, al doble de tarifa por token: $4 de entrada y $12 de salida, fuera del cartel estándar. docs.x.ai lo vende en Cursor y en Grok Build, y lo deja fuera del plan gratuito de Grok Build. La API pública no lo lista. El tráfico de la API se queda en $2 y $6, salto incluido.
¿Qué cadena de modelo debe enviar el SDK?
En la API de xAI la cadena es grok-4.7. En OpenRouter llamamos a x-ai/grok-4.7 el 22 de septiembre de 2026. Pon reasoning.effort en low, medium, high o xhigh. High es el valor por defecto documentado. La columna naranja es xhigh, así que un cliente que omite el campo no está en esa columna.