IA que corre en tus propios servidores.

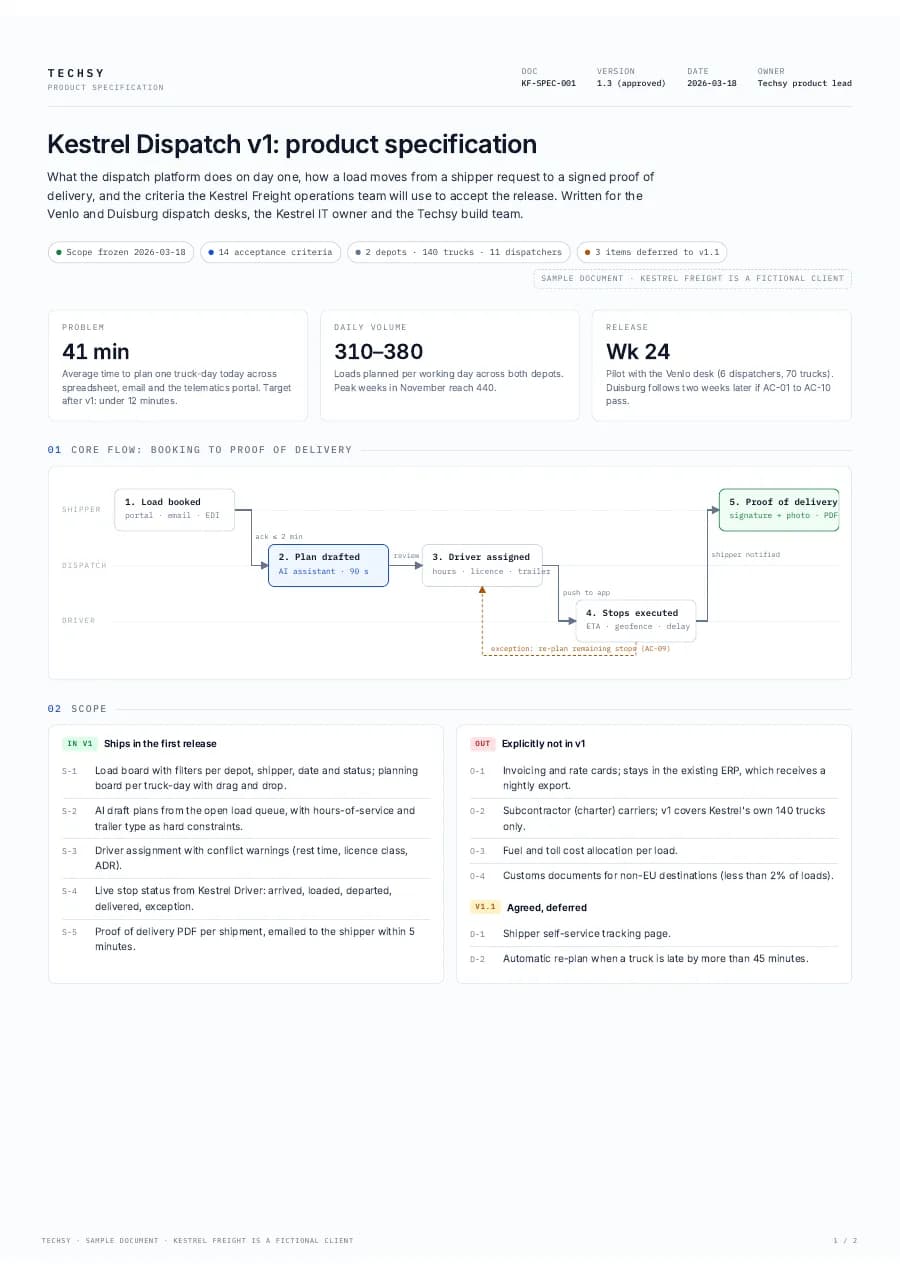
Modelos abiertos como Llama, Mistral y Qwen, servidos con vLLM u Ollama en tu hardware o en tu nube privada. Los prompts, los documentos y las respuestas nunca salen de tu red, así que la ley de privacidad de tu país deja de ser un problema. Dimensionamos el hardware, montamos la recuperación sobre tus datos internos, hacemos fine-tuning donde compensa y te entregamos un sistema que gestiona tu equipo de IT.

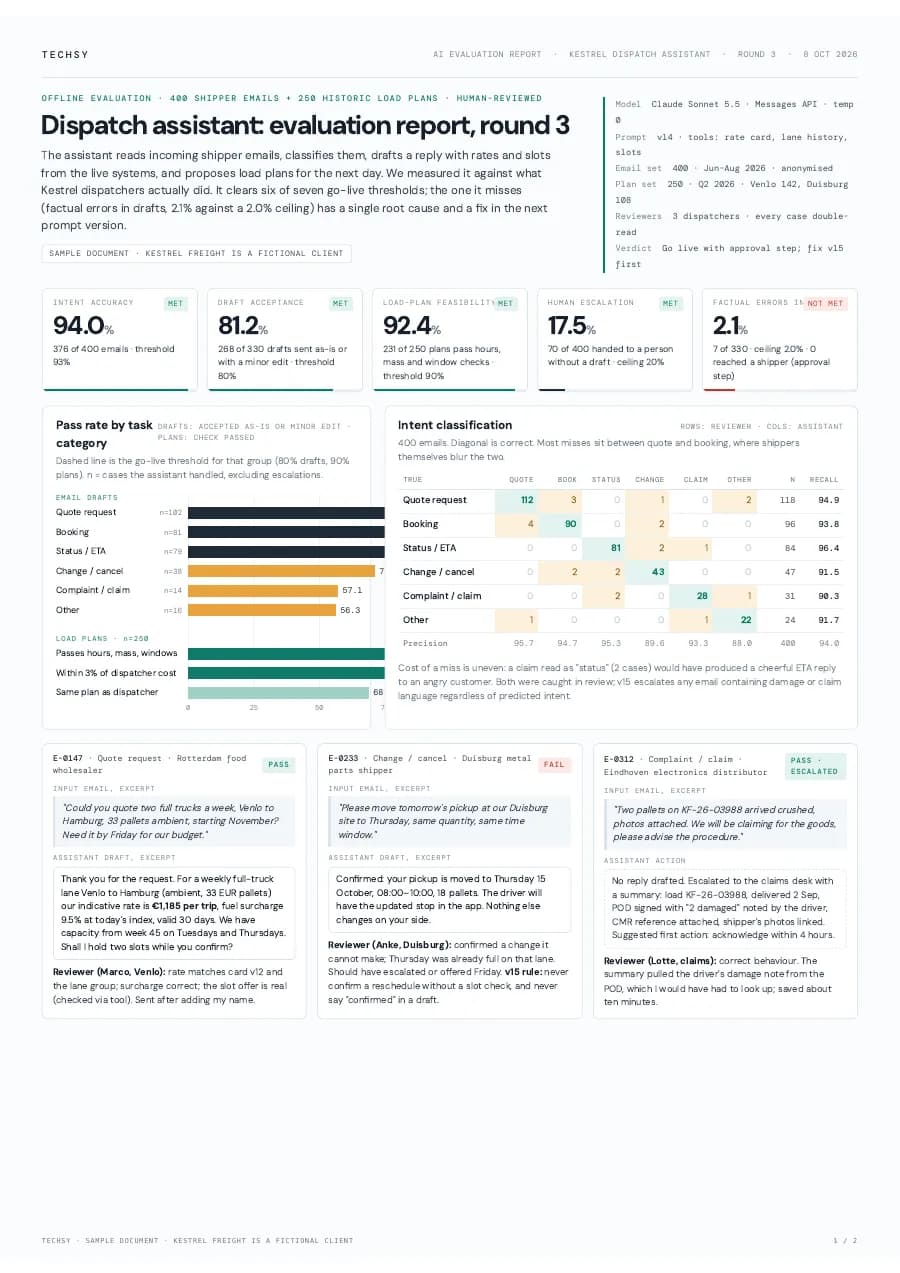
de prompts o documentos salen de tu red
0 B
hasta un asistente funcionando sobre tus propios datos
2–4 sem.
de los modelos, los pesos y el código en tu hardware
100 %

Inferencia privada

En tu hardware, sin conexión a internet

Llama 3.3 70B · vLLMgpu-01 · tu centro de datos

Pregunta de Finanzas

Resume el contrato de suministro con Acme y enumera las cláusulas de rescisión.

Recuperado de documentos internos

  • contratos/acme-suministro-2025.pdf · págs. 3, 11
  • legal/politica-rescision.docx · sección 4

Respuesta

Latencia 1,4 s

  • Contrato de suministro a tres años desde marzo de 2025, 60.000 unidades por trimestre a precio unitario fijo.
  • Cualquiera de las partes puede rescindir con seis meses de preaviso tras el primer año [1].
  • Se permite la rescisión inmediata por incumplimiento grave no subsanado en 30 días [1][2].

Datos que salieron de la red0 B

Registrado en tu rastro de auditoría

Los CIO, CTO y responsables de datos montan su IA local con nosotros.

Los mismos ingenieros, el mismo proceso. Qué caso de uso va primero depende de quién lo pide y de lo que permite su política.

CIO / Responsable de IT

Antes
Legal dijo que no a la IA en la nube. Los datos de nuestros clientes no pueden salir del edificio, así que mis equipos no usan nada o lo usan a escondidas.
Después
Un modelo en tus propios servidores, detrás de tu SSO y con cada prompt registrado. Tus equipos tienen el asistente que ya querían, y el mapa de datos de la documentación responde al auditor.

0 Bde datos salen de tu red
CTO / Responsable de ingeniería

Antes
Pagamos por token a una API, la factura crece cada mes y seguimos sin poder enviarle datos de clientes.
Después
Una tabla de dimensionado con tu coste real por token en tus propias GPU, y después una pila de servicio que sustituye a la API detrás de un único gateway. Las mismas llamadas desde tu código, sin factura por token y con los datos de clientes permitidos.

2–4 sem.hasta el primer caso de uso en vivo

Responsable de datos / operaciones

Antes
Nuestros documentos están en alemán y en turco y llenos de términos propios. Los modelos genéricos los responden mal.
Después
Recuperación sobre tus documentos en sus idiomas, fine-tuning con tus ejemplos cuando las evaluaciones muestran mejora, y respuestas con la página de origen adjunta. Medido con tus preguntas reales antes del lanzamiento.

100 %de los pesos y el código, tuyos

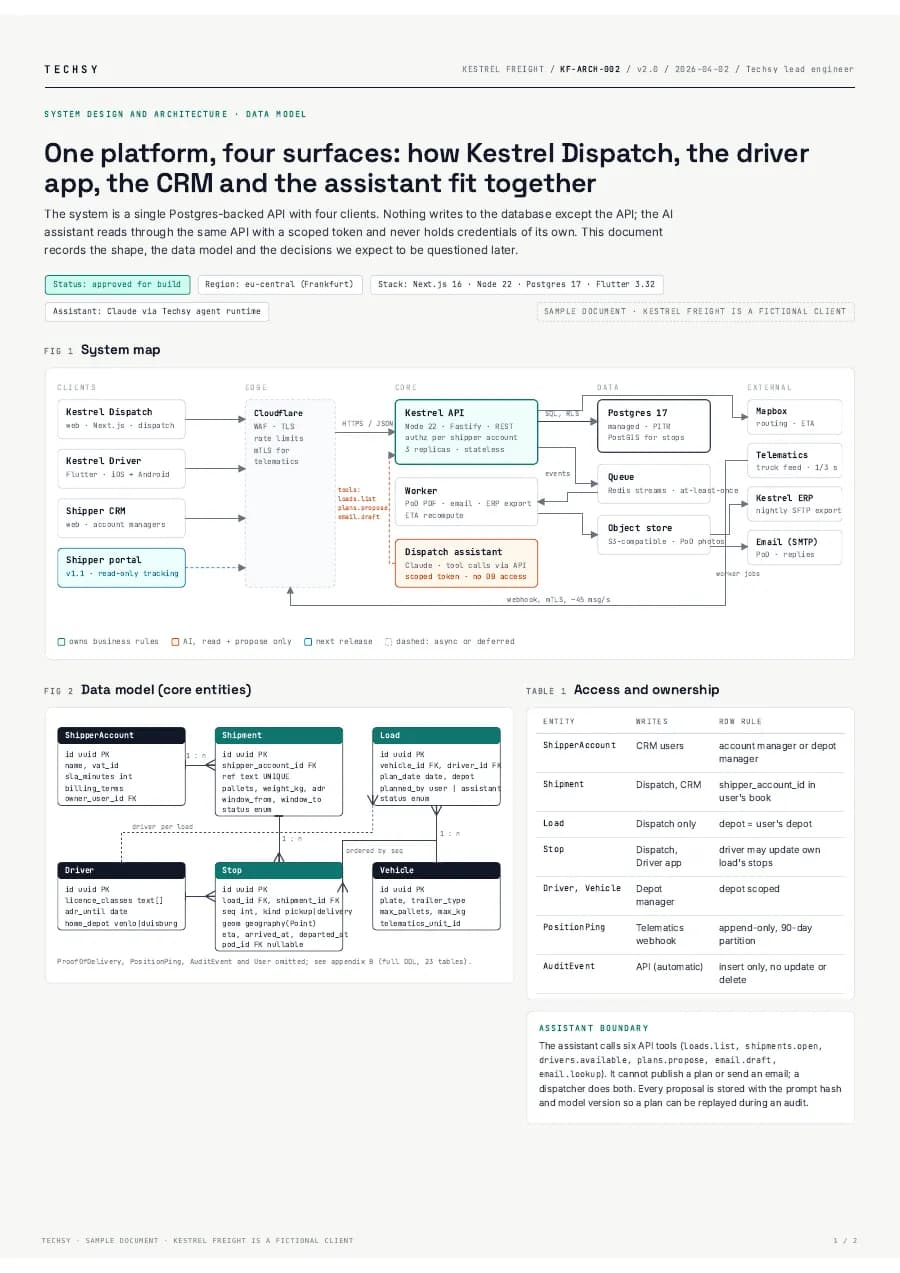
Construimos, probamos y entregamos IA local en tu hardware.

  • 01

    La pila de inferencia

    vLLM u Ollama sirviendo un modelo abierto, un gateway con la misma forma de API que tu código ya llama, planificación de GPU, caché y monitorización. En un servidor, un clúster o tu nube privada.

  • 02

    Recuperación sobre tus datos internos

    Conectores a tus carpetas compartidas, wikis, bases de datos y sistemas de tickets. Los embeddings y el índice se quedan en local, la recuperación respeta tus reglas de acceso y cada respuesta cita el documento y la página.

  • 03

    Fine-tuning donde compensa

    Un fine-tuning LoRA con tus propios ejemplos cuando las evaluaciones muestran mejora: tu formato, tu vocabulario, tus idiomas. Entrenado en tu hardware; los pesos son tuyos.

  • 04

    Dimensionado del hardware y el runbook

    Una tabla de dimensionado con el coste por token, el plan de GPU, failover y copias de seguridad, y un runbook con el que tu equipo de IT actualiza modelos, vuelve atrás y lee la monitorización.

Incluidos gratis

El paquete de entrada incluye 5 documentos.

La misma carpeta que ves en la página de precios. Abre cualquiera para leer una primera página de ejemplo.

Todos estos documentos van incluidos gratis en el paquete; ninguno añade una línea al plan.

  • ¿Te falta algo?Pídelo. Lo añadimos a tu paquete, gratis.

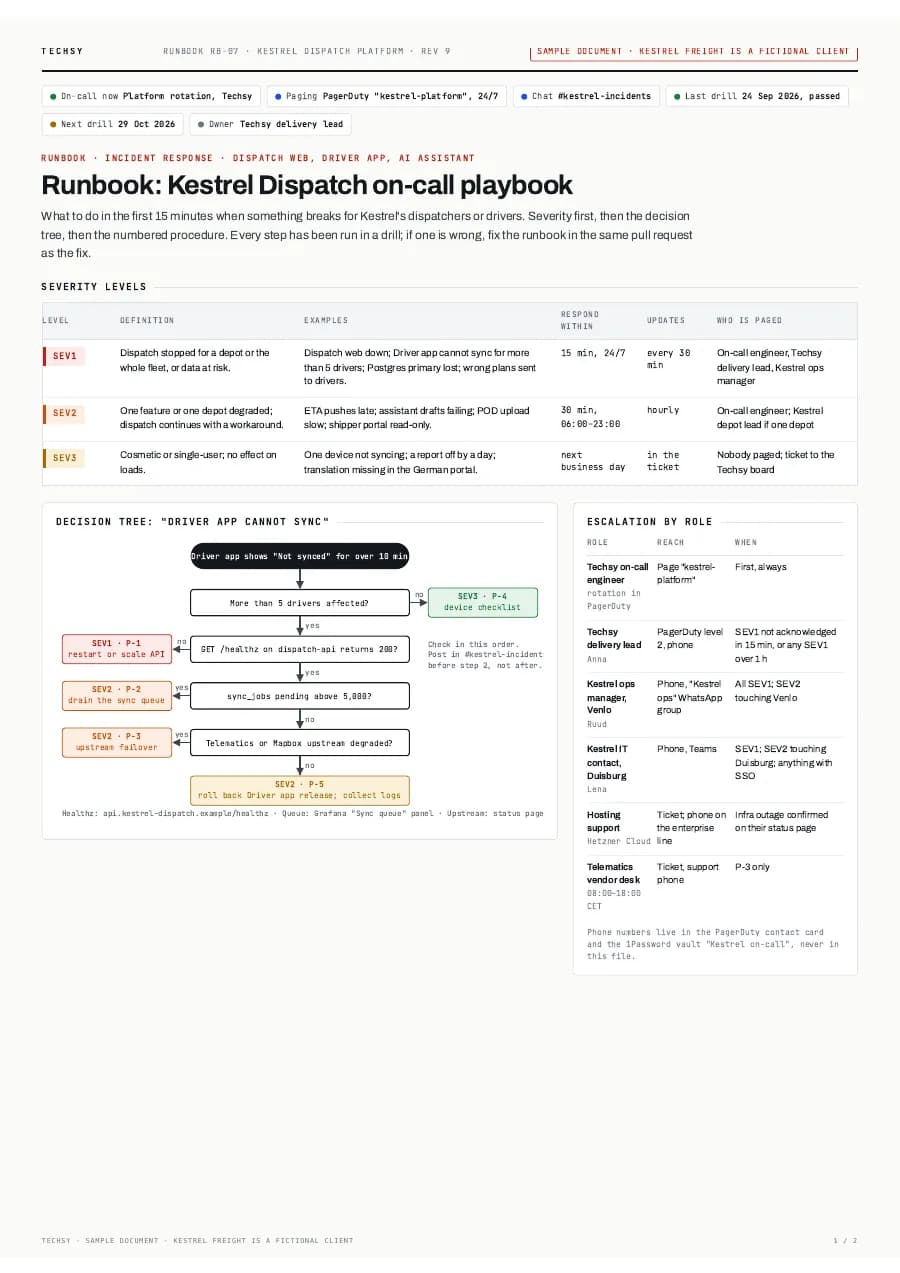
Tu IA local arranca en dos a cuatro semanas.

Tú pones el caso de uso, los documentos y una hora a la semana. Nosotros dimensionamos, construimos, medimos y entregamos, y tu equipo de IT participa en cada paso desde el primer servidor.

  1. 01

    Semana 1

    Primera reunión y dimensionado

    Nosotros
    Una primera reunión gratuita sobre los casos de uso y los datos. Después, un informe de investigación: mapa de datos, lista corta de modelos, dimensionado del hardware con coste por token y un precio cerrado.
    Tú
    Apruebas el plan y pagas el 50 %. Pides el hardware o nos indicas la nube privada que ya tienes.
  2. 02

    Semanas 2–3

    Piloto con un caso de uso

    Nosotros
    Servimos el modelo en tu primer nodo, conectamos una fuente de documentos, montamos la recuperación con citas y escribimos las evaluaciones a partir de tus preguntas reales.
    Tú
    Nos pasas de 50 a 100 preguntas reales con las respuestas que esperas.
  3. 03

    Semanas 3–6

    Reforzar y ampliar

    Nosotros
    SSO y reglas de acceso, el registro de prompts y respuestas, monitorización, failover y copias de seguridad. Fine-tuning si las evaluaciones muestran mejora. Añadimos el siguiente caso de uso.
    Tú
    Revisas con nosotros las puntuaciones y das el visto bueno a los umbrales.
  4. 04

    Lanzamiento

    Traspaso a tu IT

    Nosotros
    Runbook, formación para tu equipo de IT y el 50 % restante en la entrega. Las plataformas más grandes llegan hasta los tres meses con las mismas condiciones.
    Tú
    Lo gestionas tú, o nos mantienes con un plan mensual para actualizar modelos y repetir las evaluaciones.

Empiece con un asistente privado. Crezca hasta una plataforma de IA privada.

Tres paquetes, cada uno a un precio fijo que ve antes de decidir. Cada uno se apoya en el anterior, así que no se tira nada.

  1. 01

    Primera reunión

    30 minutos, gratis

    Nos describes el caso de uso y dónde viven los datos. Te decimos qué modelo y qué hardware encajan, cuánto cuesta el paquete de entrada y cuánto sería la factura de API en su lugar.

  2. 02

    Asistente de IA privado

    En marcha en 2 a 3 semanas

    Un modelo abierto en su propio servidor. Nada sale de su red.

  3. 03

    Base de conocimiento privada

    En marcha en 3 a 5 semanas

    Sus documentos consultables con IA, por completo dentro de su red.

  4. 04

    IA privada empresarial

    En marcha en 6 a 10 semanas

    Varios departamentos en una sola plataforma de IA privada.

La IA local corre en tus servidores y usa tu SSO para el acceso.

Construimos sobre el hardware y las cuentas que ya tienes, los usuarios entran con tu SSO y las métricas van a la monitorización que ya consultas.

Cualquier otra herramienta con API: escribimos el conector y te entregamos el código.

Nube privada

  • AWS
  • Google Cloud
  • Azure
  • Cloudflare

Identidad y acceso

  • Okta
  • Microsoft Entra ID
  • Auth0

Fuentes de datos

  • PostgreSQL
  • Supabase
  • Notion
  • SAP
  • Dynamics 365
  • Odoo

Monitorización

  • Grafana
  • Datadog
  • Sentry
  • Elastic

Úsalo con cualquier herramienta de IA.

Los agentes, skills y el código que entregamos funcionan en las herramientas que tu equipo ya usa.

  • Codex
  • Claude
  • Cursor
  • Grok
  • Z.ai
  • Hermes
  • OpenClaw
  • Eve
  • Mistral
  • OpenCode
  • VS Code
  • Antigravity
  • Windsurf
  • JetBrains
  • Zed
  • GitHub Copilot
  • Cline
  • Qwen
  • Amp
  • Goose
  • Lovable
  • Replit
  • v0

Tu paquete de IA local tiene un precio cerrado.

  • El más asequible

    Asistente de IA privado

    Un modelo abierto en su propio servidor. Nada sale de su red.

    $4,500

    $3,000

    Precio inicial · pago único

    • 5 documentos, gratis
    • Un modelo abierto, como Llama o Qwen, en su servidor
    • Chat de equipo con inicio de sesión
    • Sus datos nunca van a un proveedor de IA externo
    • Dimensionado del hardware y guía de instalación
    • Revisión de seguridad de la instalación
  • El más elegido

    Gama media

    Base de conocimiento privada

    Sus documentos consultables con IA, por completo dentro de su red.

    $12,000

    $8,000

    Precio inicial · pago único

    Todo lo de Asistente de IA privado, más:

    • Sus documentos conectados, con permisos
    • Respuestas con sus fuentes
    • Inicio de sesión único con sus cuentas de empresa
    • Pruebas de calidad con sus propias preguntas
    • Monitorización y plan de actualizaciones
  • Gama alta

    IA privada empresarial

    Varios departamentos en una sola plataforma de IA privada.

    $30,000

    $20,000

    Precio inicial · pago único

    Todo lo de Base de conocimiento privada, más:

    • Varios departamentos, cada uno con sus datos y reglas
    • Dimensionado de GPU para su carga
    • Una API para sus otros sistemas
    • Registros de auditoría e informes de acceso
    • Pruebas de calidad en cada actualización del modelo

Tu primera reunión con Techsy es gratis.

Sales entendiendo lo que necesitas.

  • La primera reunión no cuesta nada.
  • El informe de investigación también es gratis.
  • 25 % de vuelta si cancelas en los primeros 28 días.
Cómo avanza un proyecto con Techsy, paso a paso
  1. Primera reunión gratis: Treinta minutos con alguien que construye.
  2. Planificación: Alcance, fases y fechas, acordados por escrito.
  3. Investigación y docs: Un informe de investigación gratis y las specs.
  4. Solución y beneficios: Qué construimos y cuánto te ahorra.
  5. Desarrollo: En ciclos cortos que puedes ver.
  6. Lanzamiento: En producción, monitorizado y entregado.

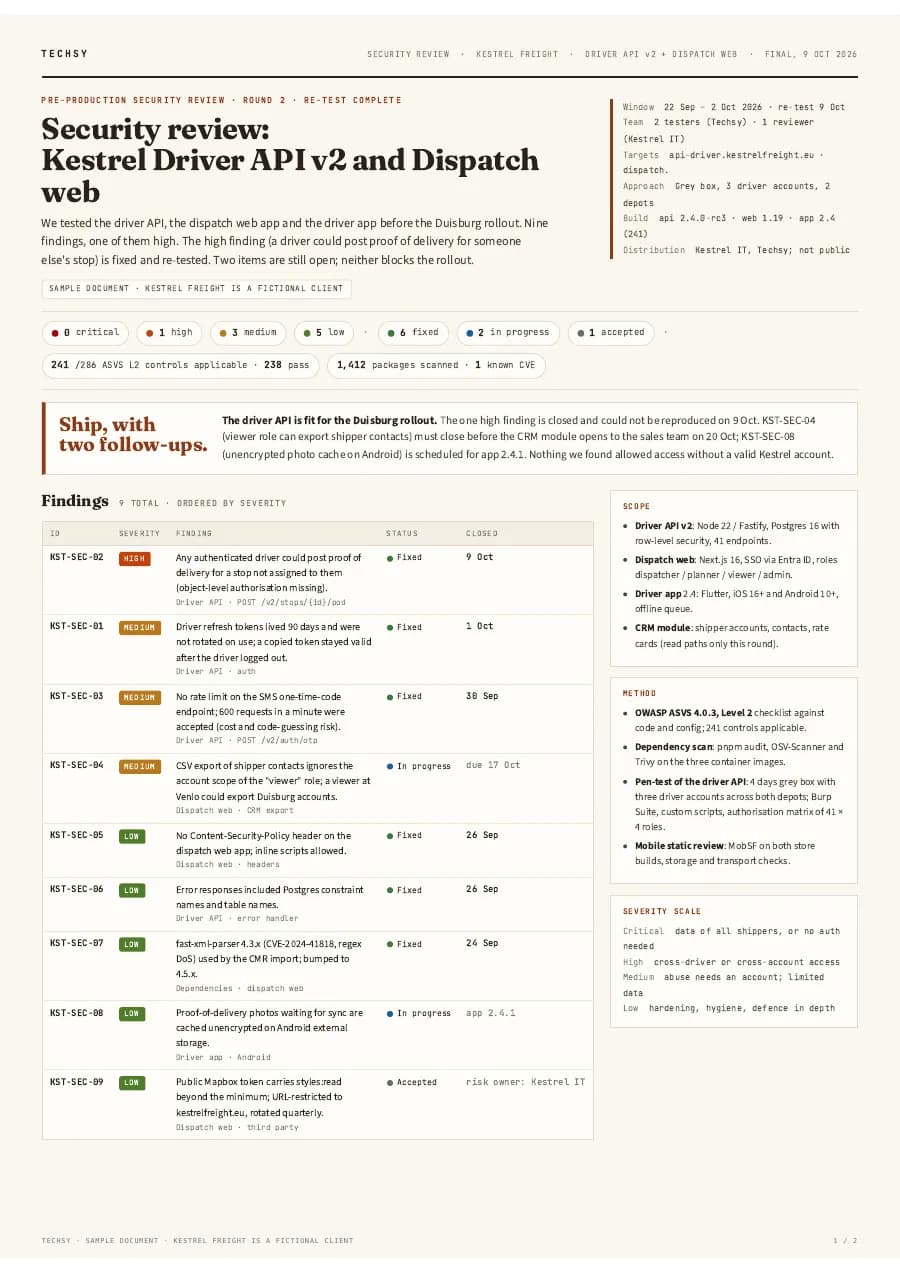
Esto preguntan los equipos antes de llevar la IA a sus propios servidores.

Coste, modelos, hardware, privacidad y quién lo mantiene en marcha. Las preguntas que oímos en cada primera reunión.

  • Tres paquetes. Asistente de IA privado por $3,000 instala un modelo abierto en su propio servidor con un chat de equipo. Base de conocimiento privada por $8,000 añade sus documentos con permisos, fuentes y SSO. IA privada empresarial por $20,000 atiende a varios departamentos, con dimensionado de GPU, API y registros de auditoría. Paga el 50 % al aprobar el plan y el resto en la entrega. El hardware se compra a su nombre; lo dimensionamos y le damos el coste por token antes de pedirlo.

  • Modelos de pesos abiertos: Llama, Mistral, Qwen, Gemma, DeepSeek y modelos más pequeños para embeddings, reranking y clasificación. Elegimos por caso de uso según las puntuaciones de evaluación, la latencia y el hardware que tengas. Un modelo de 7B a 14B en una sola GPU cubre la mayoría de las tareas de documentos y soporte; uno de 70B necesita un nodo con varias GPU. Cada llamada al modelo pasa por un único gateway, así que cambiar de modelo más adelante es un cambio de configuración, no una reconstrucción.

  • Depende del modelo y de cuántas personas lo usen a la vez. Un solo servidor con una o dos GPU de centro de datos sirve un modelo de 14B a unos cientos de usuarios. Un modelo de 70B pide de cuatro a ocho GPU. Si ya tienes capacidad de GPU, en una nube privada o en una estación de trabajo, empezamos por ahí. El informe de investigación incluye una tabla de dimensionado con el coste por token, para que lo compares con la factura de API que pagas hoy.

  • Elimina la parte más difícil: ningún dato personal sale de tu infraestructura, así que no hay encargado del tratamiento externo, ni transferencias fuera de tu país, ni un proveedor entrenando con tus prompts. Añadimos lo que piden los auditores: reglas de acceso ligadas a tu SSO, un registro de cada prompt y cada respuesta, políticas de retención y un mapa de datos en la documentación. La política sigue siendo de tu equipo legal; nosotros hacemos que la respuesta técnica a cada pregunta sea un sí.

  • En conocimiento general, las API de frontera van por delante. Sobre tus documentos, tus términos y tu idioma, un modelo local con una buena recuperación y un fine-tuning pequeño suele igualarlos o superarlos, porque la respuesta sale de tus datos y no de la memoria del modelo. No te pedimos que lo creas sin más: antes del lanzamiento ejecutamos evaluaciones con un conjunto de tus preguntas reales y te enseñamos las puntuaciones lado a lado.

  • Empieza por la recuperación. RAG pone los documentos correctos delante del modelo y te da citas, y por sí solo cubre la mayoría de los casos de uso. El fine-tuning compensa cuando el modelo tiene que aprender un estilo, un formato o el vocabulario de un sector, como el lenguaje contractual alemán o la terminología contable turca. Solo lo proponemos cuando las evaluaciones muestran una mejora clara, y lo ejecutamos en tu hardware con tus ejemplos.

  • Tu equipo de IT puede hacerlo con el runbook que entregamos: cómo actualizar un modelo, volver atrás, añadir una GPU, leer la monitorización y restaurar desde una copia de seguridad. Muchos clientes prefieren mantenernos con un plan mensual: mantenemos al día los modelos, los drivers y la pila de servicio, repetimos las evaluaciones cuando cambian tus datos y vigilamos el uso de GPU y la latencia. En cualquier caso, el sistema es tuyo y funciona sin nosotros.

  • La primera reunión es gratuita. En una semana tienes un informe de investigación con los casos de uso, el mapa de datos, el dimensionado del hardware y un precio cerrado. Apruebas el plan y pagas el 50 %. El primer caso de uso está en vivo en tu hardware en dos a cuatro semanas; una plataforma completa con varios casos de uso, SSO y fine-tuning lleva hasta tres meses. El 50 % restante se paga en la entrega, cuando las evaluaciones superan los umbrales que acordamos.

¿No encuentras tu respuesta?

Pregunta a una persona

Lanza el sistema sobre el que gira tu negocio.

Reserva una llamada para definir el alcance y dejamos claros el desarrollo, el coste y los plazos. La mayoría de los equipos salen de la primera con un plan cerrado.

Tres preguntas rápidas y verás tu rango de precio y el plazo. Sin llamada.