Grok 4.7 vs Grok 4.6 : même $2/$6, le tableau se coupe selon la tâche
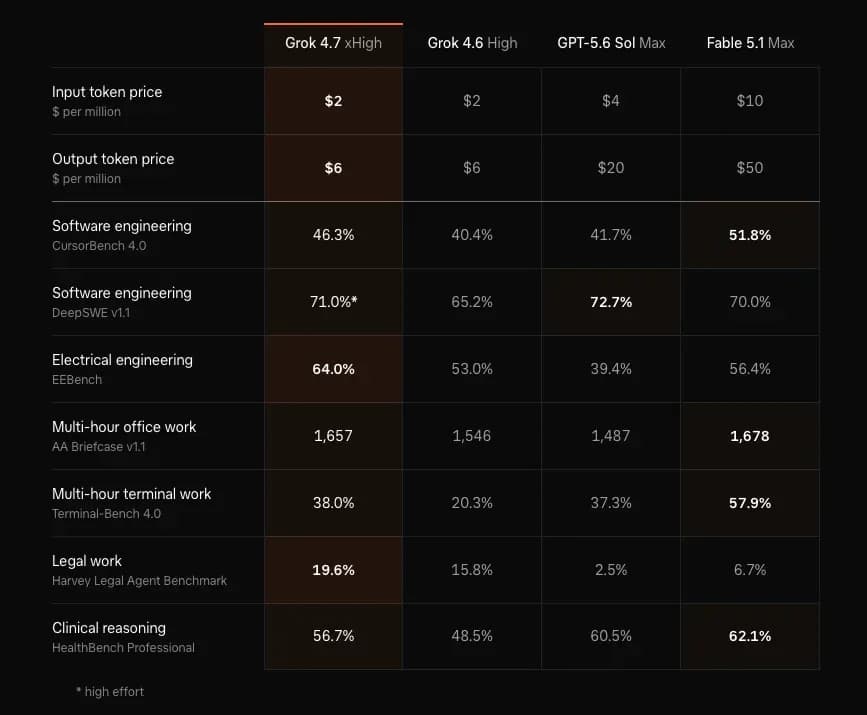
Grok 4.7 est sorti le 21 septembre 2026 à $2 par million de tokens d'entrée et $6 par million en sortie, la même carte que Grok 4.6. Le tableau de SpaceXAI donne chaque ligne à 4.7 contre 4.6, puis en cède quatre sur sept à Fable 5.1 Max. On a enregistré les deux graphiques de la page de lancement et envoyé 12 appels notés via OpenRouter le 22 septembre, de 14:51 à 14:53 UTC.
Où Grok 4.7 bat vraiment Grok 4.6
Envoie le travail électrique, l'agent juridique et le terminal vers Grok 4.7. Laisse les tâches cliniques sur Fable 5.1 ou GPT-5.6 Sol.
Chaque chiffre de la colonne de tête vient de l'article de lancement du 21 septembre, consulté le 22 septembre 2026. La dernière ligne est la nôtre.
| Charge | En tête sur la ligne | Grok 4.7 | Routage |
|---|---|---|---|
| EEBench | Grok 4.7 xHigh | 64,0 % | Grok 4.7 |
| Harvey legal agent | Grok 4.7 xHigh | 19,6 % | Grok 4.7. Dis bien que 80,4 % des cas ratent encore |
| Terminal-Bench 4.0 | Fable 5.1 Max, 57,9 % | 38,0 % | 4.7 en quittant 4.6 ; Fable quand le score est le produit |
| CursorBench 4.0 | Fable 5.1 Max, 51,8 % | 46,3 % | Fable, sauf si une sortie à $6 bat un écart de 5,5 points |
| DeepSWE v1.1 | GPT-5.6 Sol Max, 72,7 % | 71,0 % en high, pas en xHigh | Sol, ou 4.7 si 1,7 point ne vaut pas $20 en sortie |
| AA Briefcase v1.1 | Fable 5.1 Max, 1 678 | 1 657 | Fable de 21 Elo, ou 4.7 quand la facture de sortie domine |
| HealthBench Professional | Fable 5.1 Max, 62,1 % | 56,7 % | Fable ou Sol (60,5 %), pas 4.7 |
| Quatre appels courts, les nôtres | Égalité | 4/4 | Garde le client que tu as |
Grok 4.6 High reste sous 4.7 sur les sept lignes publiées. C'est tout ce qui justifie de quitter le modèle que tu fais déjà tourner. Ça ne justifie pas de quitter Fable sur les tâches d'éditeur, le travail de bureau, le terminal ou les tâches cliniques.
Ce que comptent les deux graphiques de SpaceXAI
La colonne orange est xHigh, le défaut de l'API est high et les 71,0 % de DeepSWE sont marqués high.
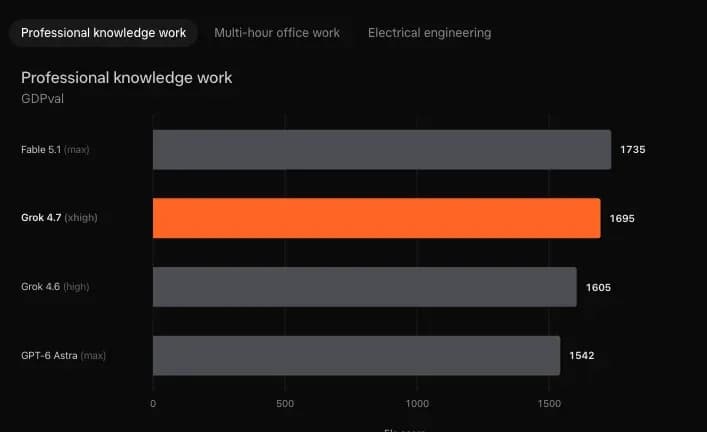
GDPval place Fable 5.1 max à 1 735 Elo, Grok 4.7 xhigh à 1 695, Grok 4.6 high à 1 605 et GPT-6 Astra max à 1 542. Ça fait +90 Elo sur 4.6, 40 Elo derrière Fable et 153 Elo devant Astra. Sur ce graphique, le nom OpenAI est Astra. Sur le tableau de scores, le nom OpenAI est GPT-5.6 Sol Max. Deux modèles différents. La page de lancement emploie les deux.
- Lis la colonne orange comme xHigh. docs.x.ai fixe l'effort par défaut à high.
- Lis 71,0 % comme le palier high. L'astérisque est sur cette cellule DeepSWE et sur aucune autre cellule Grok 4.7.
- Garde les 1 542 Elo d'Astra sur le graphique Elo. Ne les colle pas dans la colonne de Sol.
Artificial Analysis sépare le gain sur le travail de bureau. Sur AA-Briefcase, la qualité d'analyse passe de 1 690 Elo sur Grok 4.6 high à 1 994 sur Grok 4.7. La qualité de présentation passe de 1 519 à 1 499. L'analyse est plus nette. En tant que documents, ils sont un peu moins bons.
CursorBench, c'est la suite de Cursor. SpaceX a accepté de racheter l'éditeur de Cursor, Anysphere, pour $60B en actions le 16 juin 2026.
Grok 4.7 est sur l'API sous grok-4.7, dans Cursor et comme modèle par défaut de Grok Build. L'article du 12 août Grok 4.6 vs Grok 4.5 disait que 4.7 n'était pas encore sorti. C'était vrai le 12 août. Ça ne l'est plus depuis le 21 septembre.
Ce que $2 et $6 laissent hors de la carte
Un prompt de 250 000 tokens est facturé $4 et $12, sur chaque token de la requête.
Le graphique affiche $2 et $6. La page des modèles en affiche deux lignes. Sous 200 000 tokens de prompt, les tarifs sont $2 en entrée, $0.50 pour l'entrée en cache et $6 en sortie. À partir de 200 000, toute la requête repasse à $4, $1 et $12.
prompt, output = 250_000, 2_000
chart_rate = prompt / 1e6 * 2 + output / 1e6 * 6     # $0.512
cliff_rate = prompt / 1e6 * 4 + output / 1e6 * 12    # $1.024
Franchir ce seuil double une facture que le graphique n'affiche jamais. $0.512 devient $1.024. Les tokens sous 200 000 ne gardent pas le tarif bas.
L'entrée à $2, c'est la moitié des $4 de GPT-5.6 Sol et le cinquième des $10 de Fable 5.1. La sortie à $6 est 3,3× moins chère que les $20 de Sol et 8,3× moins chère que les $50 de Fable. Par dollar de sortie, ça fait 166 667 tokens sur Grok, 50 000 sur Sol et 20 000 sur Fable. « La moitié du prix » colle à la ligne d'entrée face à Sol. Ça ne colle à aucune des deux lignes de sortie.
L'entrée en cache reste à $0.50 par million sous 200 000 tokens, le même chiffre que Grok 4.6, puis $1 au seuil. Comment ce tarif de cache se lit sur une vraie facture, c'est le sujet du guide du coût d'inférence.
Grok 4.7 Fast est un réglage à part : le double de la vitesse de sortie, pour le double du prix du token, dans Cursor et Grok Build. Ce n'est pas le seuil des 200 000 tokens. L'API publique ne le vend pas.
Artificial Analysis a mesuré les prompts longs autour de 188 tokens par seconde et autour de 7,1 minutes par tâche de l'Intelligence Index. Notre médiane sur les appels courts était de 5,02 secondes pour Grok 4.7 high, contre 8,12 secondes pour Grok 4.6 high. Aucun de ces deux chiffres n'est un argument de vitesse 2× face à Fable ou à Sol.
Ce que 12 appels Grok 4.7 ont renvoyé le 22 septembre
Douze appels ont fait 12/12. Le palier xhigh a renvoyé les quatre mêmes réponses que high.
Quatre prompts identiques, température 0, max_tokens à 4000, un essai chacun, sans outils. Grok 4.6 en high, Grok 4.7 en high et Grok 4.7 en xhigh. La passerelle était OpenRouter, le même montage que dans notre comparatif des passerelles LLM. Les objets usage bruts sont dans benchmark-raw.json, à côté de cet article. Le usage.cost OpenRouter des douze appels totalise $0.029279.
{
  "model": "x-ai/grok-4.7",
  "temperature": 0,
  "max_tokens": 4000,
  "reasoning": {"effort": "xhigh"},
  "messages": [{"role": "user", "content": "..."}]
}| Tâche | Attendu | 4.6 high | 4.7 high | 4.7 xhigh |
|---|---|---|---|---|
| Médiane de 3, 1, 4, 1, 5, 9 | 3,5 | 3,5, 6,17 s, 348 tok | 3,5, 5,42 s, 359 tok | 3,5, 4,67 s, 300 tok |
| 2,2 kΩ à 5 mA | 11 V | 11, 8,06 s, 511 tok | 11, 4,62 s, 273 tok | 11, 5,31 s, 348 tok |
| Réessaie 429 et 503, jamais 500 | 429,503 | 429,503, 78,30 s, 451 tok | 429,503, 3,37 s, 216 tok | 429,503, 2,07 s, 87 tok |
count_passed([59, 60, 100, 0]) avec la boucle qui démarre à l'index 1 | 2 | 2, 8,18 s, 466 tok | 2, 6,10 s, 409 tok | 2, 5,16 s, 368 tok |
Les tokens de complétion passent de 1 776 sur Grok 4.6 high à 1 257 sur Grok 4.7 high, puis à 1 103 en xhigh. Les tokens de raisonnement, inclus dans ces totaux de complétion, sont 1 543, puis 1 052, puis 944. La facture OpenRouter suit : $0.012258, puis $0.008877, puis $0.008144. Soit 29,2 % de tokens de complétion en moins en high et une facture plus basse de 27,6 %, sur un test que les deux modèles finissent à 4/4.
prompt_tokens sur Grok 4.7 revient avec exactement 1 036 tokens de plus que l'appel Grok 4.6 apparié en high : 1 311 contre 275, 1 288 contre 252, 1 295 contre 259, 1 339 contre 303. xhigh en ajoute encore un sur chaque appel. À $2 le million, 1 036 tokens valent $0.002072. L'item médian facture $0.002446 sur 4.6 et $0.002438 sur 4.7 high, donc l'écart ne se voit pas sur la facture. Les quatre factures de Grok 4.6 collent à $2 et $6 sur les comptes renvoyés. Aucun poste ne couvre ce millier en plus.
L'essai de 78,30 secondes, c'est un prompt et un seul essai. Grok 4.7 high répond à ce même prompt de relance en 3,37 secondes, xhigh en 2,07 secondes. Les trois renvoient 429,503. La latence médiane sur les quatre prompts est de 8,12 s, 5,02 s et 4,92 s. Ne transforme pas cet essai lent isolé en ratio de vitesse.
Sur le travail long, le compte des tokens s'inverse. Artificial Analysis rapporte environ 81 000 tokens de sortie par tâche de l'Intelligence Index pour Grok 4.7 en xhigh, contre environ 36 000 pour Grok 4.6 en high. Notre médiane de 316 tokens décrit quatre réponses courtes. Elle ne décrit pas un dossier AA Briefcase de plusieurs heures.
D'où vient le score Terminal-Bench de 38,0 %
Trois chiffres publiés de Terminal-Bench 4.0 ne concordent pas : 38,0 %, 33 % et une hausse de 4,5 points.
- Le tableau de lancement xAI, la capture ci-dessus : Grok 4.7 xHigh à 38,0 %, Grok 4.6 High à 20,3 %, GPT-5.6 Sol Max à 37,3 %, Fable 5.1 Max à 57,9 %. Face à 4.6, c'est 1,87×, soit +17,7 points. Face à Sol, +0,7 point. Fable mène de 19,9 points.
- Artificial Analysis, Grok Build comme agent, le 21 septembre 2026 : Terminal-Bench 4.0 passe de 18 % à 33 % et DeepSWE v1.1 de 65 % à 73 %. Leur Coding Agent Index passe de 47 à 56 et finit quatrième, derrière Fable 5.1, GPT-6 Astra et Claude Opus 5.
- L'Intelligence Index du même labo, un runner partagé pour tous les modèles : Terminal-Bench 4.0 gagne 4,5 points et l'indice gagne 2 points pour arriver à 46. AA-LCR perd 3,7 points. AutomationBench-AA perd 1,1 point.
xAI ne nomme pas l'agent derrière les 38,0 %. Retiens le chiffre qui correspond à ton client. La mesure de Fable 5.1 note 55,8 % pour Fable sur Terminal-Bench 4.0, contre 57,9 % sur ce tableau. L'indice de codage d'Astra a sa place dans l'article GPT-6 Astra. Ici, seule la barre à 1 542 Elo compte.
Quelle charge doit quitter Grok 4.6
Les appels structurés courts peuvent rester. Le terminal, le travail électrique et l'agent juridique doivent bouger.
Fable mène encore CursorBench 4.0 de 5,5 points, 51,8 % contre 46,3 %. HealthBench Professional laisse Fable à 62,1 % et Sol à 60,5 %, avec Grok 4.7 à 56,7 %. Ces deux lignes disent pourquoi « tout basculer » est le mauvais ordre.
| Si le travail ressemble à ça | Tu gardes | Tu passes à Grok 4.7 quand |
|---|---|---|
| Une transformation courte notée, comme les quatre prompts ci-dessus | Le modèle déjà en place | La facture de tokens de complétion est le seul reproche. La nôtre a baissé de 29,2 % en high |
| Du travail shell au format de Terminal-Bench 4.0 | Fable 5.1, si 57,9 % est exigé | Tu quittes les 20,3 % de Grok 4.6 et tu acceptes 38,0 % |
| Circuits et unités au format EEBench | Personne sur ce tableau ne dépasse 64,0 % | Toujours, sur ce tableau |
| Une boucle d'agent juridique au format Harvey | Personne sur ce tableau ne dépasse 19,6 % | Toujours sur ce tableau, avec 80,4 % d'échecs écrits au contrat |
| Documents de plusieurs heures, AA Briefcase | Fable, 21 Elo devant à 1 678 | Le prix de sortie domine : $6 contre $50 chez Fable |
| Tâches d'éditeur, CursorBench 4.0 | Fable à 51,8 % | Un écart de 5,5 points coûte moins qu'un tarif de sortie à 8,3× |
| Tâches cliniques, HealthBench Professional | Fable ou Sol | Ne bouge pas pour le score. 56,7 % reste derrière les deux |
La sortie Fable à $50 vaut 8,3× la sortie Grok à $6. Paie ce multiple quand la ligne est le produit. Le même choix, écrit comme une config de routeur, est dans le guide du routage de modèles. Le 19,6 % de Harvey mène ce tableau et rate encore 80,4 % du jeu.
Ce que cette mesure ne peut pas te dire
Quatre prompts, un essai chacun, ne disent rien sur CursorBench 4.0 ni sur une tâche de bureau de 7 minutes.
- La température était à 0,
max_tokensà 4000, les outils étaient coupés et rien n'a été relancé. Un second essai sur l'appel de 78,30 secondes aurait pu être ordinaire. - Fable 5.1, GPT-5.6 Sol et GPT-6 Astra n'ont pas été appelés. Leurs cellules sont citées depuis xAI et depuis Artificial Analysis.
- L'écart de 1 036 tokens de prompt est un fait comptable. Rien dans la réponse ne nomme ces tokens. La facture n'ajoute pas les $0.002072 du prix catalogue.
- Artificial Analysis a relevé des régressions, pas seulement des gains : AA-LCR baisse de 3,7 points ; AutomationBench-AA baisse de 1,1 point ; la qualité de présentation sur AA-Briefcase passe de 1 519 Elo à 1 499.
- La précision AA-Omniscience est de 47 % pour Grok 4.7, contre 48 % pour Grok 4.6 high. Le taux d'hallucination sur ce jeu tombe de 34 % à 29 %.
Passe sur 4.7 là où la ligne a bougé et où le taux absolu peut s'écrire à côté du nom d'un client. Laisse les tâches cliniques sur Fable ou sur Sol. Laisse xhigh de côté jusqu'à ce qu'une tâche notée change de réponse. Pas ces quatre-là.
Questions fréquentes
Quelle est la coupure de connaissances de Grok 4.7 ?
docs.x.ai date la coupure à mai 2026. Cette sortie du 21 septembre n'est pas dans les poids. La recherche web et la recherche X sont des outils séparés, sur la même page. Une requête sans eux répond depuis mai 2026. Passe la source dans le prompt quand le fait est plus récent que ça.
L'endpoint US change-t-il le prix du token ?
L'URL de base régionale US est https://us.api.x.ai/v1. docs.x.ai la tarife avec une majoration de 10 % pour que l'inférence reste aux États-Unis. Un token de sortie à $6 y devient $6.60 et un token d'entrée à $2 devient $2.20. L'id du modèle reste grok-4.7. Le seuil des 200 000 tokens et le tarif d'entrée en cache s'appliquent en plus de cette majoration.
L'API accepte-t-elle une image ?
Oui. La page du modèle annonce une entrée texte et image, une sortie texte seule, une fenêtre de contexte de 500 000 tokens et aucun plafond de sortie texte. Les images acceptées sont jpg ou png, jusqu'à 20 MiB chacune, sans plafond indiqué sur le nombre. La réponse est du texte. La génération d'images reste sur les modèles Imagine, avec leur propre liste de tarifs.
Où Grok 4.7 Fast tourne-t-il vraiment ?
Fast reprend les mêmes poids sur des machines plus rapides, au double du tarif par token : $4 en entrée et $12 en sortie, hors de la carte standard. docs.x.ai le vend dans Cursor et dans Grok Build, hors de l'offre gratuite de Grok Build. L'API publique ne le liste pas. Le trafic API reste sur $2 et $6, seuil compris.
Quelle chaîne le SDK doit-il envoyer ?
Sur l'API xAI, la chaîne est grok-4.7. Sur OpenRouter, on a appelé x-ai/grok-4.7 le 22 septembre 2026. Règle reasoning.effort sur low, medium, high ou xhigh. High est la valeur par défaut documentée. La colonne orange est xhigh, donc un client qui omet le champ n'est pas sur cette colonne.