L'IA qui tourne sur vos propres serveurs.

Des modèles ouverts comme Llama, Mistral et Qwen, servis avec vLLM ou Ollama sur votre matériel ou dans votre cloud privé. Prompts, documents et réponses ne quittent jamais votre réseau, et la loi sur la protection des données de votre pays reste simple à respecter. Nous dimensionnons le matériel, construisons la recherche sur vos données internes, affinons le modèle là où ça paie et vous remettons un système que votre équipe IT fait tourner.

de prompts ou de documents sortent de votre réseau
0 octet
semaines jusqu'à un assistant opérationnel sur vos données
2–4
des modèles, des poids et du code sur votre matériel
100 %

Inférence privée

Tourne sur votre matériel, sans internet

Llama 3.3 70B · vLLMgpu-01 · votre data center

Question de la Finance

Résume le contrat fournisseur avec Acme et liste les clauses de résiliation.

Extrait des documents internes

  • contrats/acme-supply-2025.pdf · pages 3, 11
  • juridique/politique-resiliation.docx · section 4

Réponse

Latence 1,4 s

  • Contrat d'approvisionnement de trois ans à partir de mars 2025, 60 000 unités par trimestre à prix unitaire fixe.
  • Chaque partie peut résilier avec un préavis de six mois après la première année [1].
  • La résiliation immédiate est possible en cas de manquement grave non corrigé sous 30 jours [1][2].

Données sorties du réseau0 octet

Consigné dans votre piste d'audit

DSI, CTO et responsables data déploient l'IA en local avec nous.

Mêmes ingénieurs, même processus. Le cas d'usage qui passe en premier dépend de qui demande et de ce que sa politique autorise.

DSI / Responsable IT

Avant
Le juridique a dit non à l'IA dans le cloud. Nos données clients ne peuvent pas sortir de l'entreprise, donc mes équipes n'utilisent rien, ou l'utilisent en cachette.
Après
Un modèle sur vos propres serveurs, derrière votre SSO, avec chaque prompt journalisé. Vos équipes obtiennent l'assistant qu'elles voulaient déjà, et la cartographie des données dans la documentation répond à l'auditeur.

0 octetde données sortent de votre réseau
CTO / Responsable engineering

Avant
Nous payons une API au token, la facture grossit chaque mois, et nous ne pouvons toujours pas lui envoyer de dossiers clients.
Après
Un tableau de dimensionnement avec votre vrai coût par token sur vos propres GPU, puis une stack de serving qui remplace l'API derrière une seule gateway. Les mêmes appels depuis votre code, plus de facture au token, et les dossiers clients autorisés.

2–4semaines jusqu'au premier cas d'usage en production

Responsable data / opérations

Avant
Nos documents sont en allemand et en turc, remplis de nos propres termes. Les modèles génériques y répondent mal.
Après
La recherche sur vos documents dans leurs langues, un fine-tuning sur vos exemples quand les evals montrent un gain, et des réponses avec la page source jointe. Mesuré sur vos vraies questions avant le lancement.

100 %des poids et du code vous appartiennent

Nous construisons, testons et livrons l'IA en local sur votre matériel.

  • 01

    La stack d'inférence

    vLLM ou Ollama qui sert un modèle ouvert, une gateway avec la même forme d'API que votre code appelle déjà, l'ordonnancement GPU, le cache et le monitoring. Sur un serveur, un cluster ou votre cloud privé.

  • 02

    La recherche sur vos données internes

    Des connecteurs vers vos partages de fichiers, wikis, bases de données et outils de tickets. Les embeddings et l'index restent en local, la recherche respecte vos règles d'accès, et chaque réponse cite le document et la page.

  • 03

    Le fine-tuning là où ça paie

    Un fine-tuning LoRA sur vos propres exemples quand les evals montrent un gain : votre format, votre vocabulaire, vos langues. Entraîné sur votre matériel ; les poids sont à vous.

  • 04

    Le dimensionnement du matériel et le runbook

    Un tableau de dimensionnement avec le coût par token, le plan GPU, le failover et les sauvegardes, et un runbook que votre équipe IT utilise pour mettre à jour les modèles, revenir en arrière et lire le monitoring.

Inclus gratuitement

5 documents livrés avec la formule d'entrée.

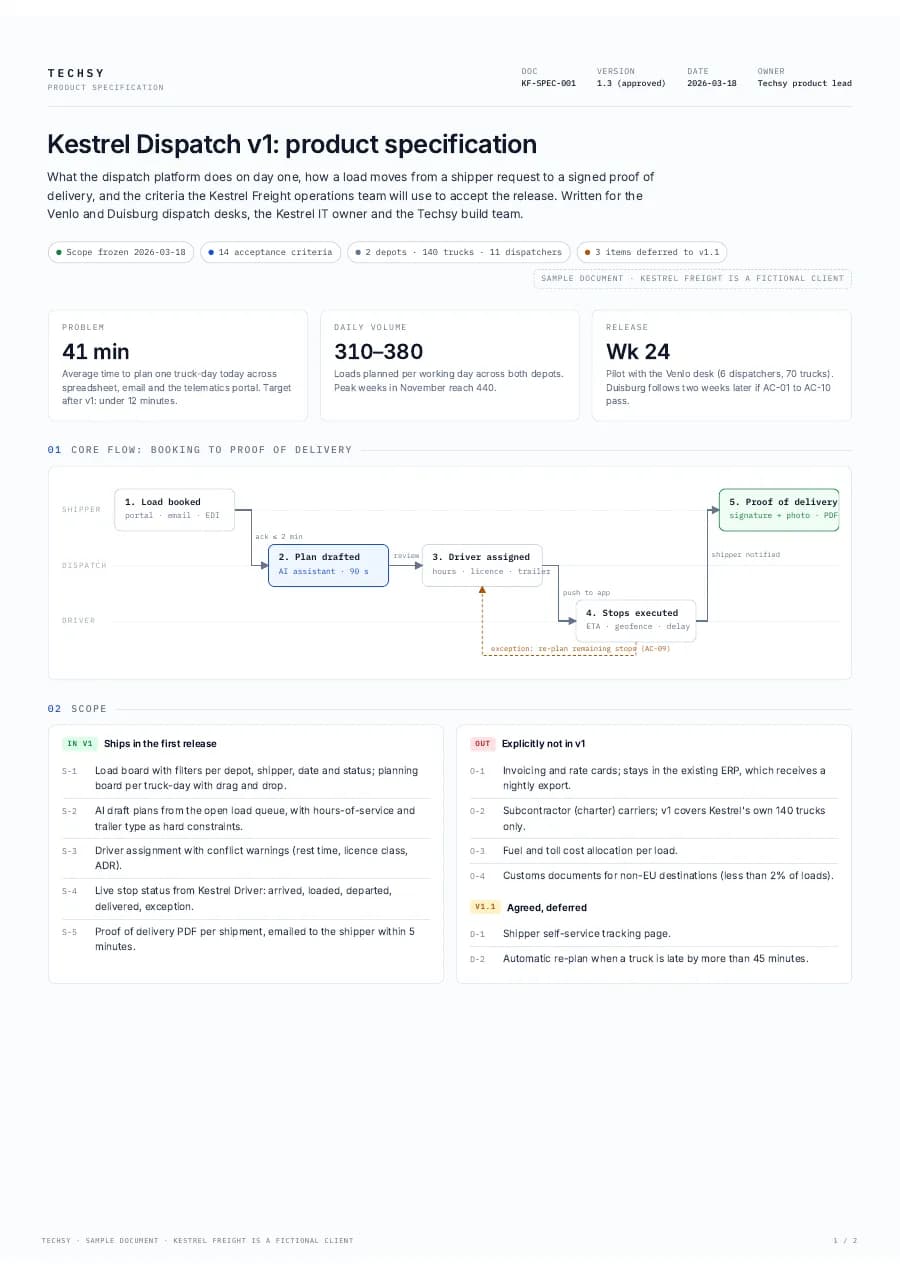
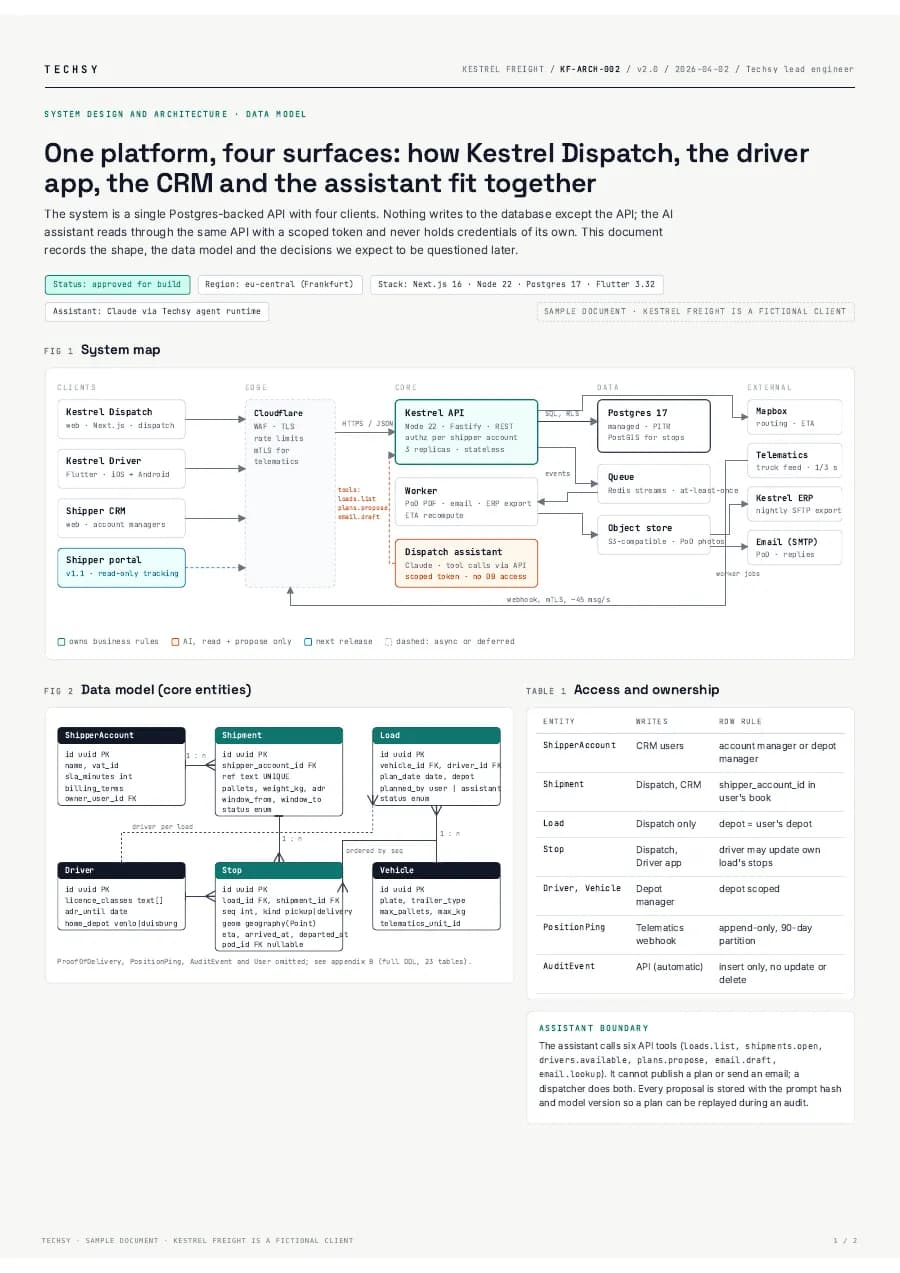
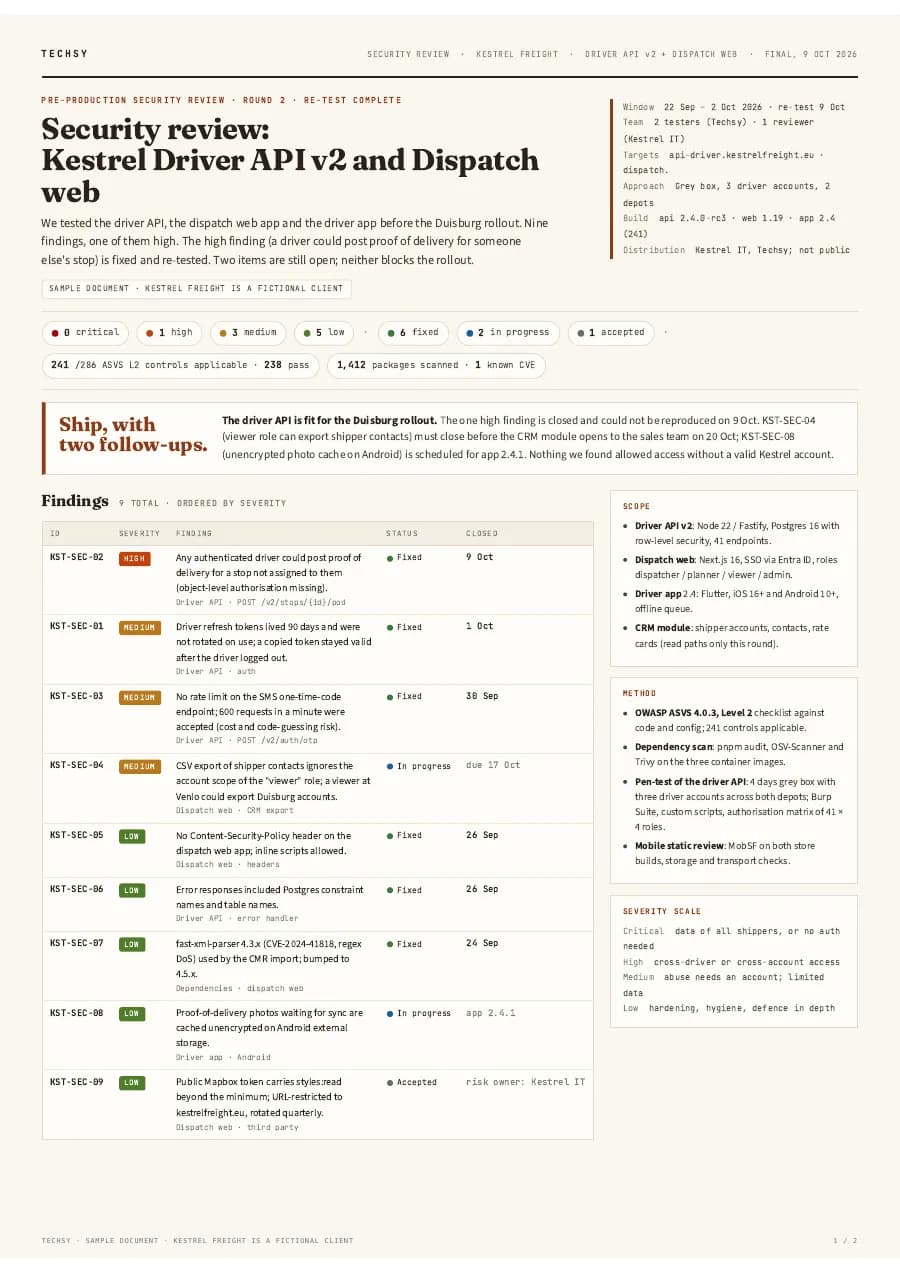
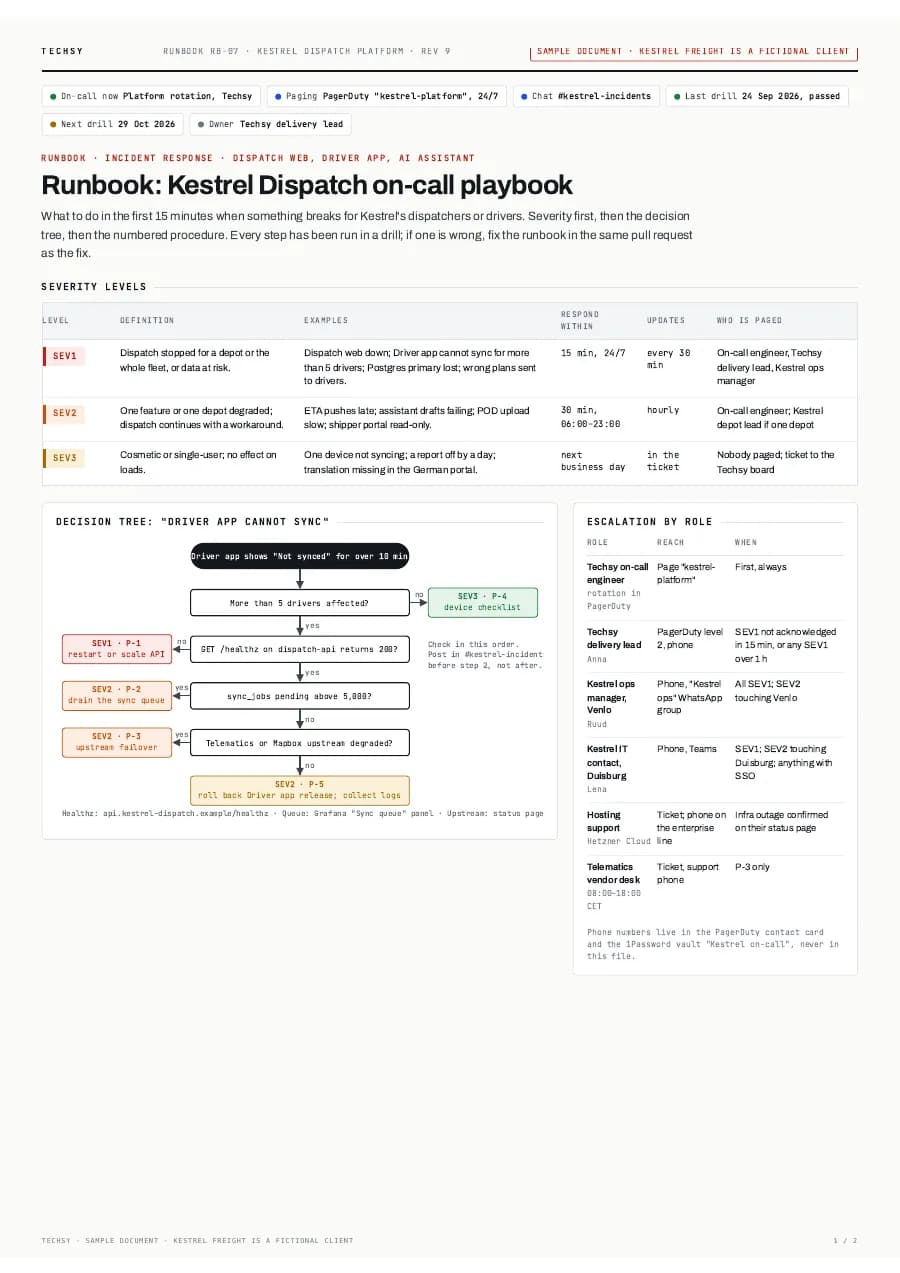
Le même dossier que sur la page Tarifs. Ouvrez-en un pour lire un exemple de première page.

Tous ces documents sont inclus gratuitement dans la formule ; aucun n'ajoute de ligne au plan.

  • Il vous manque quelque chose ?Dites-le-nous. Nous l’ajoutons à votre formule, gratuitement.

Votre premier cas d'usage d'IA en local tourne en deux à quatre semaines.

Vous apportez le cas d'usage, les documents et une heure par semaine. Nous dimensionnons, construisons, mesurons et remettons, et votre équipe IT est présente à chaque étape dès le premier serveur.

  1. 01

    Semaine 1

    Premier rendez-vous et dimensionnement

    Nous
    Un premier rendez-vous gratuit sur les cas d'usage et les données. Puis un rapport de recherche : cartographie des données, présélection de modèles, dimensionnement du matériel avec le coût par token, et un prix fixe.
    Vous
    Vous validez le plan et payez 50 %. Vous commandez le matériel, ou nous indiquez le cloud privé que vous avez déjà.
  2. 02

    Semaines 2–3

    Pilote sur un cas d'usage

    Nous
    Nous servons le modèle sur votre premier nœud, connectons une source documentaire, construisons la recherche avec citations et écrivons les evals à partir de vos vraies questions.
    Vous
    Vous nous remettez 50 à 100 vraies questions avec les réponses attendues.
  3. 03

    Semaines 3–6

    Durcissement et extension

    Nous
    SSO et règles d'accès, le journal des prompts et des réponses, le monitoring, le failover et les sauvegardes. Fine-tuning si les evals montrent un gain. Ajout du cas d'usage suivant.
    Vous
    Vous passez en revue les scores d'eval avec nous et validez les seuils.
  4. 04

    Lancement

    Remise à votre IT

    Nous
    Le runbook, la formation de votre équipe IT, et les 50 % restants à la livraison. Les plateformes plus importantes vont jusqu'à trois mois, aux mêmes conditions.
    Vous
    Vous le faites tourner vous-même, ou vous nous gardez sur un forfait mensuel pour les mises à jour de modèles et les relances d'evals.

Commencez par un assistant privé. Grandissez jusqu'à une plateforme d'IA privée.

Trois offres, chacune à un prix fixe que vous voyez avant de vous engager. Chacune s'appuie sur la précédente : rien n'est jeté.

  1. 01

    Premier rendez-vous

    30 minutes, gratuit

    Vous décrivez le cas d'usage et où se trouvent les données. Nous vous disons quel modèle et quel matériel conviennent, ce que coûte la formule d'entrée et ce que coûterait la facture d'API à la place.

  2. 02

    Assistant IA privé

    En ligne en 2 à 3 semaines

    Un modèle ouvert sur votre propre serveur. Rien ne sort de votre réseau.

  3. 03

    Base de connaissances privée

    En ligne en 3 à 5 semaines

    Vos documents interrogeables par l'IA, entièrement dans votre réseau.

  4. 04

    IA privée d'entreprise

    En ligne en 6 à 10 semaines

    Plusieurs services sur une seule plateforme d'IA privée.

L'IA en local tourne sur vos serveurs et passe par votre SSO.

Nous construisons sur le matériel et les comptes que vous possédez déjà, connectons les utilisateurs via votre SSO et envoyons les métriques au monitoring que vous suivez déjà.

Tout autre outil doté d'une API : nous écrivons le connecteur et vous remettons le code.

Cloud privé

  • AWS
  • Google Cloud
  • Azure
  • Cloudflare

Identité et accès

  • Okta
  • Microsoft Entra ID
  • Auth0

Sources de données

  • PostgreSQL
  • Supabase
  • Notion
  • SAP
  • Dynamics 365
  • Odoo

Monitoring

  • Grafana
  • Datadog
  • Sentry
  • Elastic

Avec n’importe quel outil d’IA.

Les agents, skills et le code que nous livrons fonctionnent dans les outils que votre équipe utilise déjà.

  • Codex
  • Claude
  • Cursor
  • Grok
  • Z.ai
  • Hermes
  • OpenClaw
  • Eve
  • Mistral
  • OpenCode
  • VS Code
  • Antigravity
  • Windsurf
  • JetBrains
  • Zed
  • GitHub Copilot
  • Cline
  • Qwen
  • Amp
  • Goose
  • Lovable
  • Replit
  • v0

Votre IA en local tient en une formule à prix fixe.

  • Le plus accessible

    Assistant IA privé

    Un modèle ouvert sur votre propre serveur. Rien ne sort de votre réseau.

    4 500 $US

    3 000 $US

    Prix de départ · paiement unique

    • 5 documents offerts
    • Un modèle ouvert, comme Llama ou Qwen, sur votre serveur
    • Chat d'équipe avec connexion
    • Vos données ne partent jamais chez un fournisseur d'IA externe
    • Dimensionnement du matériel et guide d'installation
    • Une revue de sécurité de l'installation
  • Le plus choisi

    Milieu de gamme

    Base de connaissances privée

    Vos documents interrogeables par l'IA, entièrement dans votre réseau.

    12 000 $US

    8 000 $US

    Prix de départ · paiement unique

    Tout ce que contient Assistant IA privé, plus :

    • Vos documents connectés, avec leurs droits
    • Des réponses avec leurs sources
    • Authentification unique avec vos comptes d'entreprise
    • Tests qualité sur vos propres questions
    • Supervision et plan de mise à jour
  • Haut de gamme

    IA privée d'entreprise

    Plusieurs services sur une seule plateforme d'IA privée.

    30 000 $US

    20 000 $US

    Prix de départ · paiement unique

    Tout ce que contient Base de connaissances privée, plus :

    • Plusieurs services, chacun avec ses données et ses règles
    • Dimensionnement GPU pour votre charge
    • Une API pour vos autres systèmes
    • Journaux d'audit et rapports d'accès
    • Tests qualité à chaque mise à jour du modèle

Votre premier rendez-vous avec Techsy est offert.

Vous repartez en sachant ce dont vous avez besoin.

  • Le premier rendez-vous ne coûte rien.
  • Le rapport d'étude est offert lui aussi.
  • 25 % remboursés en cas d'annulation sous 28 jours.
Le déroulé d’un projet avec Techsy, étape par étape
  1. Premier rendez-vous offert: Trente minutes avec quelqu’un qui construit.
  2. Planification: Périmètre, phases et dates, validés par écrit.
  3. Étude et documentation: Un rapport d’étude offert et les specs.
  4. Solution et bénéfices: Ce que nous construisons et ce que vous gagnez.
  5. Développement: Des cycles courts, visibles à chaque étape.
  6. Mise en ligne: En production, supervisé et transmis.

Les équipes posent ces questions avant de faire tourner l'IA sur leurs propres serveurs.

Le coût, les modèles, le matériel, la confidentialité et qui fait tourner tout ça ensuite. Les questions que nous entendons à chaque premier rendez-vous.

  • Trois offres. Assistant IA privé à 3 000 $US installe un modèle ouvert sur votre propre serveur avec un chat d'équipe. Base de connaissances privée à 8 000 $US ajoute vos documents avec droits, sources et SSO. IA privée d'entreprise à 20 000 $US sert plusieurs services, avec dimensionnement GPU, API et journaux d'audit. Vous payez 50 % à la validation du plan et le solde à la livraison. Le matériel est acheté à votre nom ; nous le dimensionnons et vous donnons le coût par token avant la commande.

  • Les modèles à poids ouverts : Llama, Mistral, Qwen, Gemma, DeepSeek, et des modèles plus petits pour les embeddings, le reranking et la classification. Nous choisissons par cas d'usage, selon les scores d'eval, la latence et le matériel dont vous disposez. Un modèle de 7B à 14B sur un seul GPU couvre la plupart des tâches documentaires et de support ; un modèle de 70B demande un nœud multi-GPU. Chaque appel de modèle passe par une seule gateway : changer de modèle plus tard est un changement de configuration, pas une reconstruction.

  • Cela dépend du modèle et du nombre de personnes qui l'utilisent en même temps. Un seul serveur avec un ou deux GPU de data center sert un modèle de 14B à quelques centaines d'utilisateurs. Un modèle de 70B demande quatre à huit GPU. Si vous avez déjà de la capacité GPU, dans un cloud privé ou sur une station de travail, nous partons de là. Le rapport de recherche comprend un tableau de dimensionnement avec le coût par token, pour le comparer à la facture d'API que vous payez aujourd'hui.

  • Cela règle la partie la plus difficile : aucune donnée personnelle ne quitte votre infrastructure, donc pas de sous-traitant tiers, pas de transfert hors de votre pays et aucun fournisseur qui s'entraîne sur vos prompts. Nous ajoutons ce que les auditeurs demandent : des règles d'accès liées à votre SSO, un journal de chaque prompt et de chaque réponse, des politiques de conservation et une cartographie des données dans la documentation. Votre équipe juridique reste propriétaire de la politique ; nous faisons en sorte que la réponse technique à chaque question soit oui.

  • Sur les connaissances générales, les grandes API du marché gardent l'avantage. Sur vos documents, vos termes et votre langue, un modèle local avec une bonne recherche documentaire et un petit fine-tuning fait en général aussi bien, voire mieux, parce que la réponse vient de vos données et non de la mémoire du modèle. Nous ne vous demandons pas de nous croire sur parole : avant le lancement, nous lançons des evals sur un jeu de vos vraies questions et vous montrons les scores côte à côte.

  • Commencez par la recherche documentaire. Le RAG place les bons documents devant le modèle et vous donne des citations ; à lui seul, il couvre la plupart des cas d'usage. Le fine-tuning devient rentable quand le modèle doit apprendre un style, un format ou un vocabulaire métier, comme le langage contractuel allemand ou les termes comptables turcs. Nous ne le proposons que lorsque les evals montrent un gain net, et nous le faisons tourner sur votre matériel avec vos exemples.

  • Votre équipe IT peut le faire, avec le runbook que nous remettons : comment mettre à jour un modèle, revenir en arrière, ajouter un GPU, lire le monitoring et restaurer une sauvegarde. Beaucoup de clients préfèrent nous garder sur un forfait mensuel : nous tenons à jour les modèles, les drivers et la stack de serving, relançons les evals quand vos données changent et surveillons l'usage GPU et la latence. Dans les deux cas, le système est à vous et tourne sans nous.

  • Le premier rendez-vous est gratuit. Sous une semaine, vous avez un rapport de recherche avec les cas d'usage, la cartographie des données, le dimensionnement du matériel et un prix fixe. Vous validez le plan et payez 50 %. Un premier cas d'usage est en production sur votre matériel en deux à quatre semaines ; une plateforme complète avec plusieurs cas d'usage, le SSO et du fine-tuning prend jusqu'à trois mois. Les 50 % restants sont dus à la livraison, une fois que les evals passent les seuils convenus.

Vous n’avez pas trouvé votre réponse ?

Poser la question à quelqu’un

Livrez le système sur lequel votre entreprise tourne au quotidien.

Réservez un appel de cadrage : nous posons le périmètre, le budget et le calendrier. La plupart des équipes en repartent avec un plan ferme dès le premier échange.

Trois questions rapides, puis votre fourchette de prix et le planning. Sans rendez-vous.