L'IA che gira sui tuoi server.

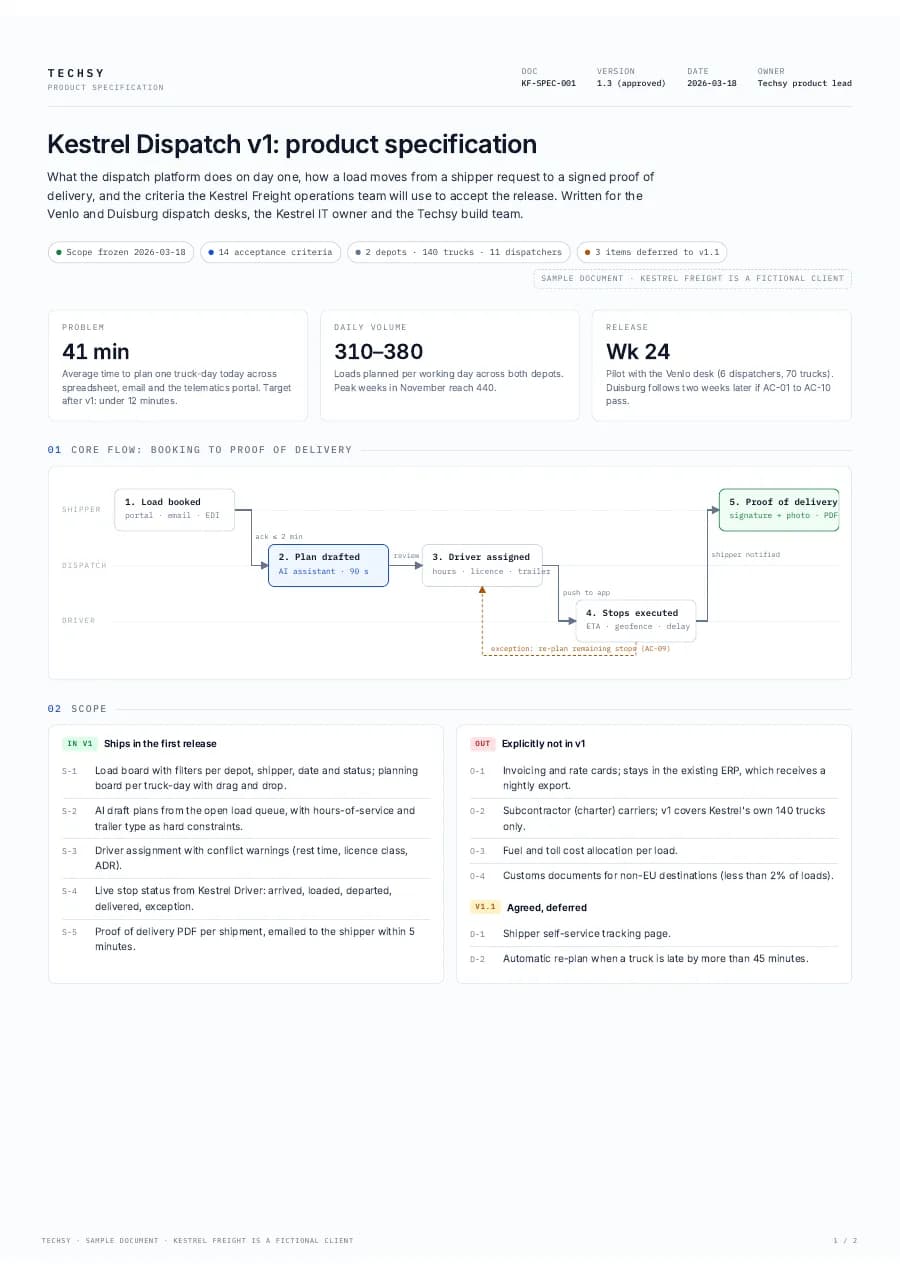
Modelli open come Llama, Mistral e Qwen, serviti con vLLM o Ollama sul tuo hardware o nel tuo cloud privato. Prompt, documenti e risposte non escono mai dalla tua rete, così la legge sulla privacy del tuo Paese resta semplice da rispettare. Dimensioniamo l'hardware, costruiamo il retrieval sui tuoi dati interni, facciamo fine-tuning dove ripaga e consegniamo un sistema che il tuo team IT gestisce da solo.

di prompt o documenti escono dalla tua rete
0 B
settimane per un assistente funzionante sui tuoi dati
2–4
di modelli, pesi e codice sul tuo hardware
100%

Inferenza privata

Gira sul tuo hardware, senza internet

Llama 3.3 70B · vLLMgpu-01 · il tuo data center

Domanda dal Finance

Riassumi il contratto di fornitura con Acme ed elenca le clausole di recesso.

Recuperato dai documenti interni

  • contracts/acme-supply-2025.pdf · pagine 3, 11
  • legal/termination-policy.docx · sezione 4

Risposta

Latenza 1,4 s

  • Contratto di fornitura triennale da marzo 2025, 60.000 unità a trimestre a prezzo unitario fisso.
  • Ciascuna parte può recedere con sei mesi di preavviso dopo il primo anno [1].
  • Il recesso immediato è consentito per inadempimento grave non sanato entro 30 giorni [1][2].

Dati usciti dalla rete0 B

Registrato nel tuo audit trail

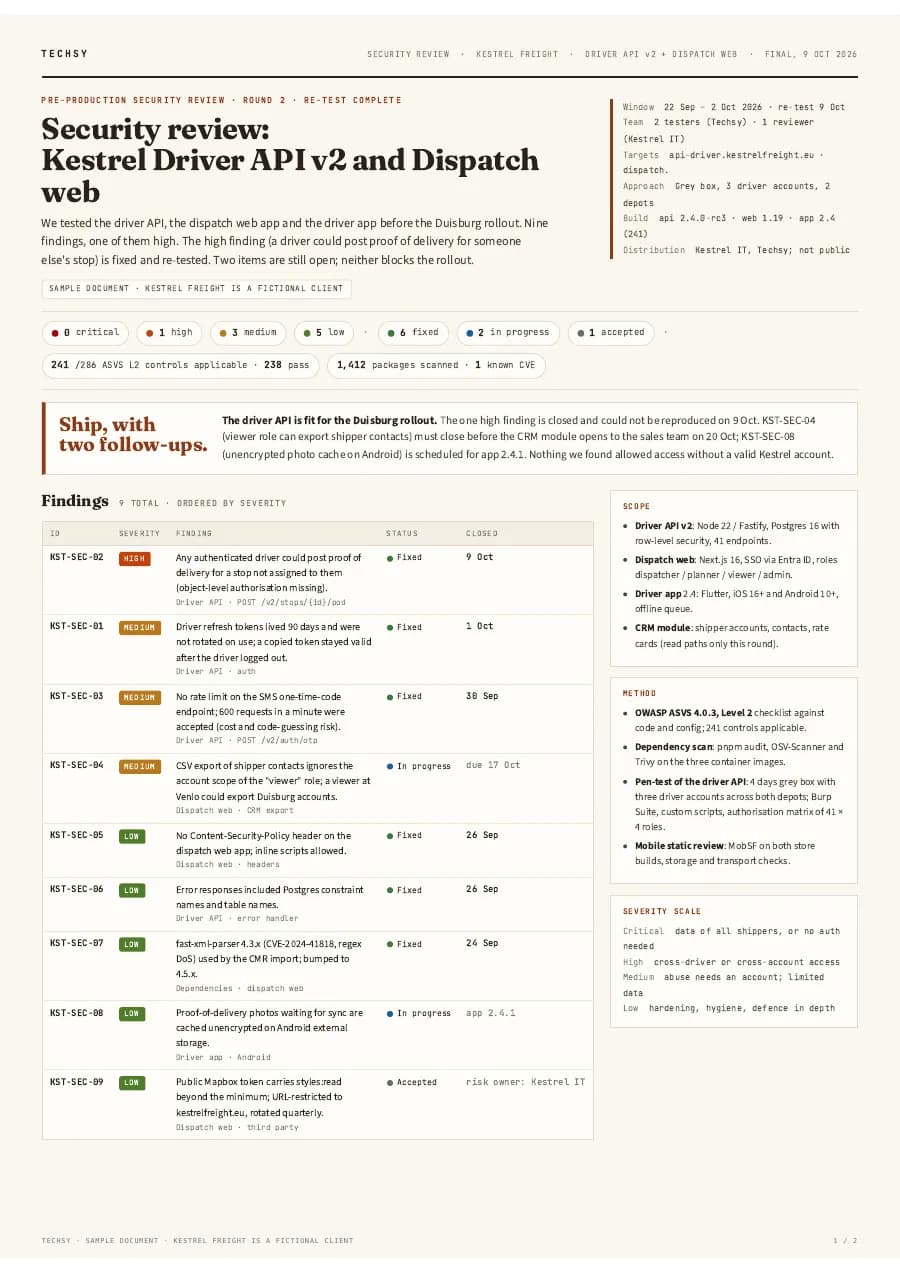
CIO, CTO e responsabili dei dati fanno girare l'IA in locale con noi.

Stessi ingegneri, stesso processo. Quale caso d'uso parte per primo dipende da chi lo chiede e da cosa consente la sua policy.

CIO / Responsabile IT

Prima
Il legale ha detto no all'IA in cloud. I dati dei nostri clienti non possono uscire dall'edificio, quindi i miei team non usano niente o la usano di nascosto.
Dopo
Un modello sui tuoi server dietro il tuo SSO, con ogni prompt registrato. I tuoi team ottengono l'assistente che volevano già, e la mappa dei dati nella documentazione risponde all'auditor.

0 Bdi dati escono dalla tua rete
CTO / Responsabile engineering

Prima
Paghiamo un'API a token, la bolletta cresce ogni mese e comunque non possiamo mandarle i dati dei clienti.
Dopo
Una tabella di dimensionamento con il tuo costo reale per token sulle tue GPU, poi uno stack di serving che sostituisce l'API dietro un unico gateway. Stesse chiamate dal tuo codice, nessuna bolletta a token, e i dati dei clienti sono ammessi.

2–4settimane per il primo caso d'uso operativo

Responsabile dati / operations

Prima
I nostri documenti sono in tedesco e in turco e pieni di termini nostri. I modelli generici rispondono male.
Dopo
Retrieval sui tuoi documenti nelle loro lingue, un fine-tuning sui tuoi esempi quando i test mostrano un guadagno, e risposte con la pagina di origine allegata. Misurato sulle tue domande reali prima del lancio.

100%di pesi e codice di tua proprietà

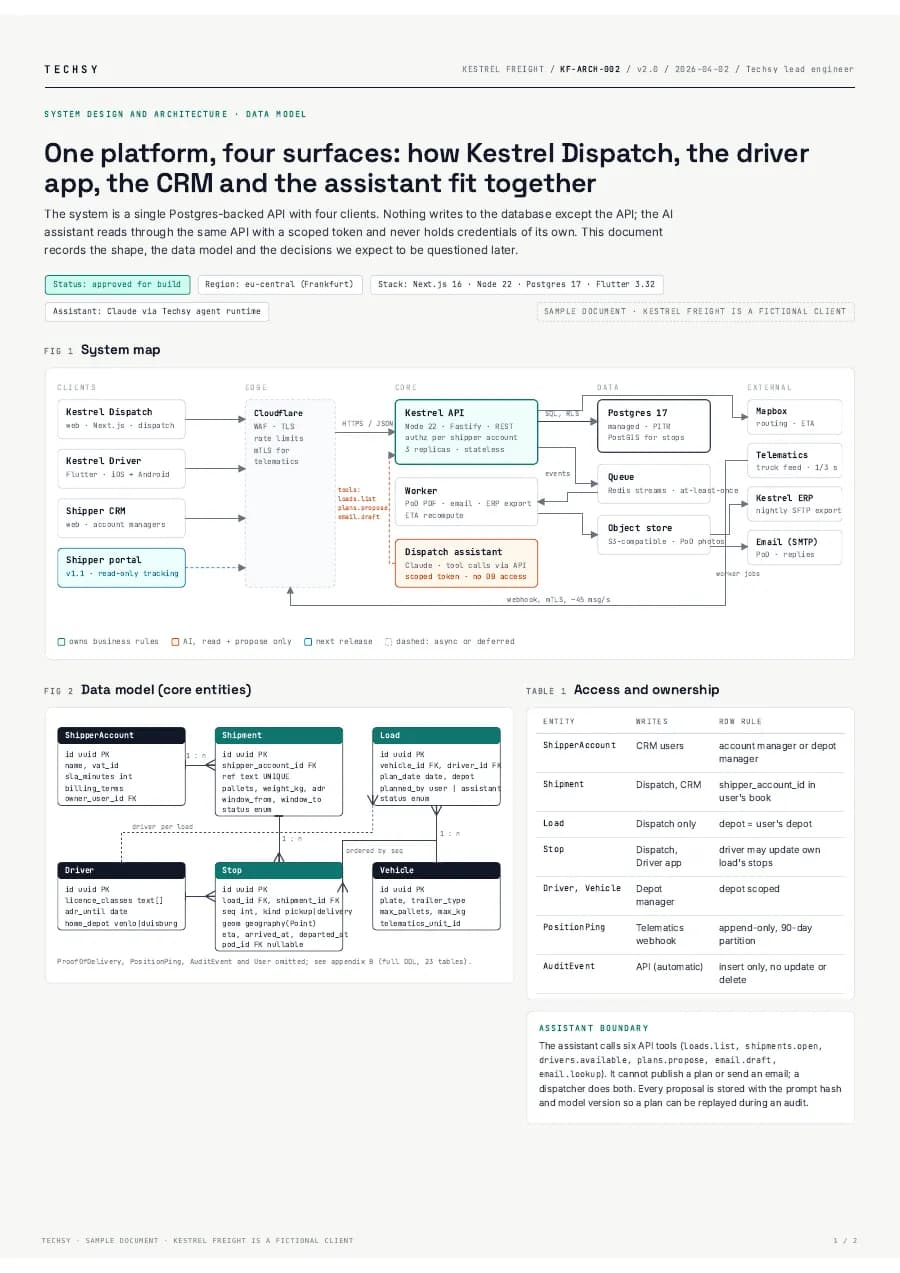
Costruiamo, testiamo e consegniamo l'IA in locale sul tuo hardware.

  • 01

    Lo stack di inferenza

    vLLM o Ollama che servono un modello open, un gateway con la stessa forma di API che il tuo codice chiama già, scheduling delle GPU, caching e monitoraggio. Su un server, un cluster o il tuo cloud privato.

  • 02

    Retrieval sui tuoi dati interni

    Connettori verso le tue condivisioni di file, wiki, database e sistemi di ticket. Embedding e indice restano in locale, il retrieval rispetta le tue regole di accesso e ogni risposta cita documento e pagina.

  • 03

    Fine-tuning dove ripaga

    Un fine-tuning LoRA sui tuoi esempi quando i test mostrano un guadagno: il tuo formato, il tuo vocabolario, le tue lingue. Addestrato sul tuo hardware; i pesi sono tuoi.

  • 04

    Dimensionamento dell'hardware e runbook

    Una tabella di dimensionamento con il costo per token, il piano GPU, failover e backup, e un runbook che il tuo team IT usa per aggiornare i modelli, tornare indietro e leggere il monitoraggio.

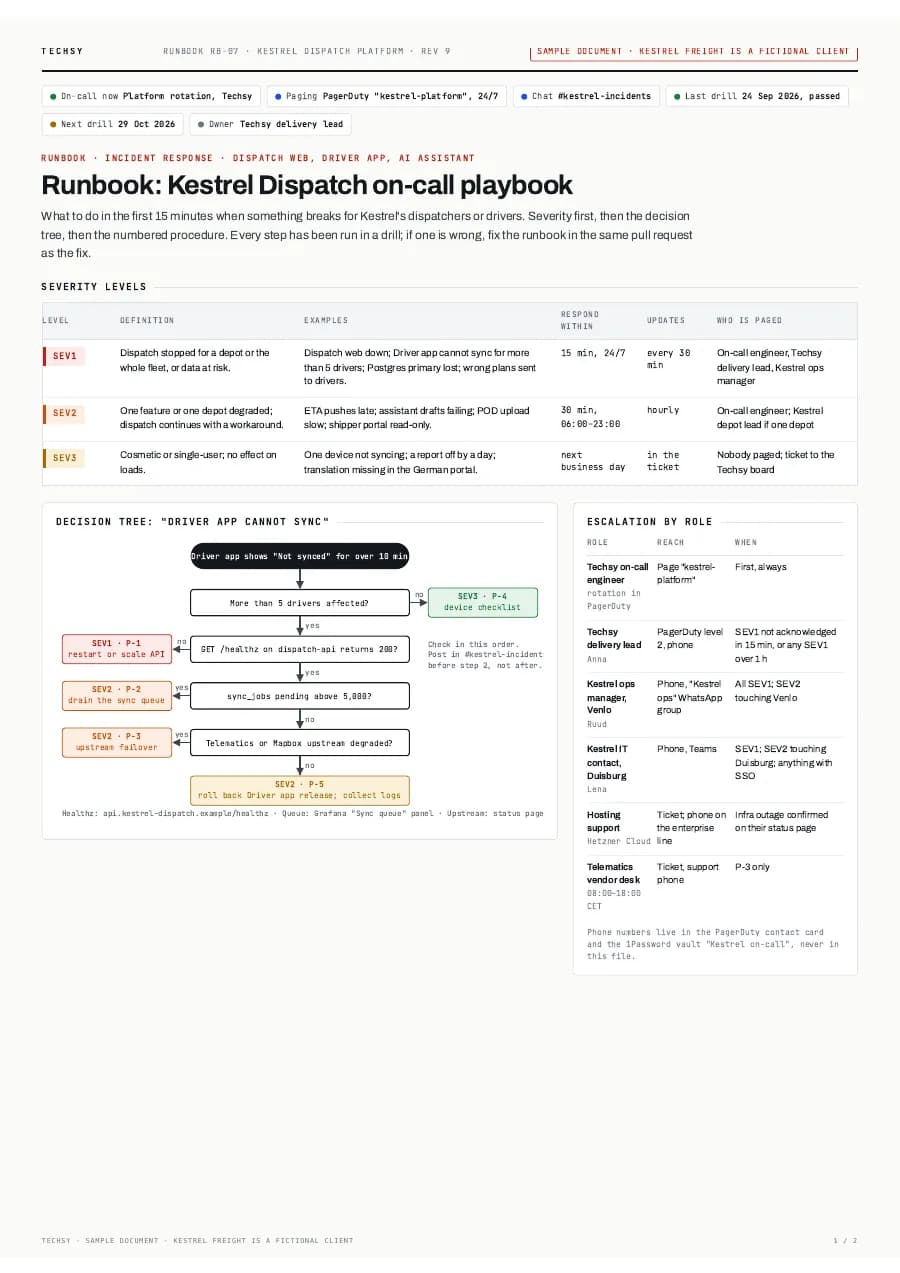
Inclusi gratis

5 documenti inclusi nel pacchetto base.

La stessa cartella che vedi nella pagina prezzi. Aprine uno qualsiasi per leggere una prima pagina di esempio.

Tutti questi documenti sono inclusi gratis nel pacchetto; nessuno aggiunge una voce al piano.

  • Ti serve altro?Chiedilo. Lo aggiungiamo al tuo pacchetto, gratis.

Il tuo primo caso d'uso di IA in locale gira in due-quattro settimane.

Tu porti il caso d'uso, i documenti e un'ora a settimana. Noi dimensioniamo, costruiamo, misuriamo e consegniamo, e il tuo team IT è presente in ogni passaggio, dal primo server in poi.

  1. 01

    Settimana 1

    Primo incontro e dimensionamento

    Noi
    Un primo incontro gratuito sui casi d'uso e sui dati. Poi un report di ricerca: mappa dei dati, shortlist dei modelli, dimensionamento dell'hardware con costo per token e un prezzo fisso.
    Tu
    Approvi il piano e paghi il 50%. Ordini l'hardware, oppure ci indichi il cloud privato che hai già.
  2. 02

    Settimane 2–3

    Pilota su un caso d'uso

    Noi
    Serviamo il modello sul tuo primo nodo, colleghiamo una fonte documentale, costruiamo il retrieval con le citazioni e scriviamo i test a partire dalle tue domande reali.
    Tu
    Ci consegni da 50 a 100 domande reali con le risposte che ti aspetti.
  3. 03

    Settimane 3–6

    Messa in sicurezza ed estensione

    Noi
    SSO e regole di accesso, il log di prompt e risposte, monitoraggio, failover e backup. Fine-tuning se i test mostrano un guadagno. Aggiungiamo il caso d'uso successivo.
    Tu
    Rivedi i punteggi dei test con noi e approvi le soglie.
  4. 04

    Lancio

    Consegna al tuo IT

    Noi
    Runbook, formazione per il tuo team IT e il restante 50% alla consegna. Le piattaforme più grandi arrivano fino a tre mesi, alle stesse condizioni.
    Tu
    Lo gestisci da solo, oppure ci tieni con un piano mensile per aggiornare i modelli e rieseguire i test.

Partite da un assistente privato. Crescete fino a una piattaforma AI privata.

Tre pacchetti, ognuno a un prezzo fisso che vedete prima di decidere. Ognuno si basa sul precedente, quindi non si butta via nulla.

  1. 01

    Primo incontro

    30 minuti, gratis

    Descrivi il caso d'uso e dove si trovano i dati. Ti diciamo quale modello e quale hardware servono, quanto costa il pacchetto base e quanto pagheresti invece in API.

  2. 02

    Assistente AI privato

    Online in 2-3 settimane

    Un modello aperto sul vostro server. Nulla esce dalla vostra rete.

  3. 03

    Knowledge base privata

    Online in 3-5 settimane

    I vostri documenti interrogabili con l'AI, interamente nella vostra rete.

  4. 04

    AI privata aziendale

    Online in 6-10 settimane

    Più reparti su un'unica piattaforma AI privata.

L'IA in locale gira sui tuoi server e usa il tuo SSO per l'accesso.

Costruiamo sull'hardware e sugli account che possiedi già, autentichiamo gli utenti con il tuo SSO e mandiamo le metriche al monitoraggio che guardi già.

Qualsiasi altro sistema con un'API: scriviamo noi il connettore e ti consegniamo il codice.

Cloud privato

  • AWS
  • Google Cloud
  • Azure
  • Cloudflare

Identità e accessi

  • Okta
  • Microsoft Entra ID
  • Auth0

Fonti dati

  • PostgreSQL
  • Supabase
  • Notion
  • SAP
  • Dynamics 365
  • Odoo

Monitoraggio

  • Grafana
  • Datadog
  • Sentry
  • Elastic

Usalo con qualsiasi strumento di IA.

Gli agenti, le skill e il codice che consegniamo funzionano negli strumenti che il tuo team usa già.

  • Codex
  • Claude
  • Cursor
  • Grok
  • Z.ai
  • Hermes
  • OpenClaw
  • Eve
  • Mistral
  • OpenCode
  • VS Code
  • Antigravity
  • Windsurf
  • JetBrains
  • Zed
  • GitHub Copilot
  • Cline
  • Qwen
  • Amp
  • Goose
  • Lovable
  • Replit
  • v0

Il pacchetto per la tua IA in locale ha un prezzo fisso.

  • Il più accessibile

    Assistente AI privato

    Un modello aperto sul vostro server. Nulla esce dalla vostra rete.

    4500 USD

    3000 USD

    Prezzo di partenza · pagamento unico

    • 5 documenti, gratis
    • Un modello aperto, come Llama o Qwen, sul vostro server
    • Chat di team con accesso
    • I vostri dati non vanno mai a un fornitore AI esterno
    • Dimensionamento dell'hardware e guida di installazione
    • Una revisione di sicurezza dell'installazione
  • Il più scelto

    Fascia media

    Knowledge base privata

    I vostri documenti interrogabili con l'AI, interamente nella vostra rete.

    12.000 USD

    8000 USD

    Prezzo di partenza · pagamento unico

    Tutto di Assistente AI privato, più:

    • I vostri documenti collegati, con i permessi
    • Risposte con le loro fonti
    • Single sign-on con gli account aziendali
    • Test di qualità sulle vostre domande
    • Monitoraggio e piano di aggiornamento
  • Fascia alta

    AI privata aziendale

    Più reparti su un'unica piattaforma AI privata.

    30.000 USD

    20.000 USD

    Prezzo di partenza · pagamento unico

    Tutto di Knowledge base privata, più:

    • Più reparti, ognuno con i suoi dati e le sue regole
    • Dimensionamento GPU sul vostro carico
    • Un'API per gli altri sistemi
    • Audit log e report di accesso
    • Test di qualità a ogni aggiornamento del modello

Il tuo primo incontro con Techsy è gratuito.

Alla fine sai di cosa hai bisogno.

  • Il primo incontro non costa nulla.
  • Anche il report di ricerca è gratuito.
  • 25% rimborsato se annulli entro 28 giorni.
Come procede un progetto con Techsy, passo dopo passo
  1. Primo incontro gratuito: Trenta minuti con chi costruisce davvero.
  2. Pianificazione: Perimetro, fasi e date, messi per iscritto.
  3. Ricerca e documenti: Un report di ricerca gratuito e le specifiche.
  4. Soluzione e benefici: Cosa costruiamo e quanto ti fa risparmiare.
  5. Sviluppo: Cicli brevi, sempre visibili.
  6. Lancio: Online, monitorato e consegnato.

Prima di portare l'IA sui propri server, i team ci fanno queste domande.

Costi, modelli, hardware, privacy e chi lo tiene in funzione. Le domande che sentiamo a ogni primo incontro.

  • Tre pacchetti. Assistente AI privato a 3000 USD installa un modello aperto sul vostro server con una chat di team. Knowledge base privata a 8000 USD aggiunge i vostri documenti con permessi, fonti e single sign-on. AI privata aziendale a 20.000 USD serve più reparti, con dimensionamento GPU, API e audit log. Pagate il 50% all'approvazione del piano e il resto alla consegna. L'hardware si acquista a vostro nome; lo dimensioniamo e vi diciamo il costo per token prima dell'ordine.

  • Modelli open-weight: Llama, Mistral, Qwen, Gemma, DeepSeek e modelli più piccoli per embedding, reranking e classificazione. Li scegliamo caso per caso in base ai punteggi dei test, alla latenza e all'hardware che hai. Un modello da 7B a 14B su una sola GPU copre la maggior parte dei compiti su documenti e assistenza; un modello da 70B richiede un nodo multi-GPU. Ogni chiamata al modello passa da un unico gateway, quindi cambiare modello in futuro è una modifica di configurazione, non un rifacimento.

  • Dipende dal modello e da quante persone lo usano contemporaneamente. Un singolo server con una o due GPU da data center serve un modello da 14B a qualche centinaio di utenti. Un modello da 70B vuole da quattro a otto GPU. Se hai già capacità GPU, in un cloud privato o su una workstation, partiamo da lì. Il report di ricerca include una tabella di dimensionamento con il costo per token, così puoi confrontarlo con la bolletta API che paghi oggi.

  • Elimina la parte più difficile: nessun dato personale esce dalla tua infrastruttura, quindi niente responsabile del trattamento esterno, niente trasferimenti fuori dal tuo Paese e nessun fornitore che addestra sui tuoi prompt. Aggiungiamo quello che chiedono gli auditor: regole di accesso legate al tuo SSO, un log di ogni prompt e risposta, policy di conservazione e una mappa dei dati nella documentazione. La policy resta in mano al tuo ufficio legale; noi facciamo in modo che la risposta tecnica a ogni domanda sia un sì.

  • Sulla conoscenza generale, le API di frontiera sono avanti. Sui tuoi documenti, sulla tua terminologia e nella tua lingua, un modello locale con un buon retrieval e un piccolo fine-tuning di solito li eguaglia o li supera, perché la risposta viene dai tuoi dati, non dalla memoria del modello. Non ti chiediamo di fidarti: prima del lancio eseguiamo i test su un insieme delle tue domande reali e ti mostriamo i punteggi fianco a fianco.

  • Parti dal retrieval. Il RAG mette i documenti giusti davanti al modello e ti dà le citazioni, e da solo copre la maggior parte dei casi d'uso. Il fine-tuning ripaga quando il modello deve imparare uno stile, un formato o un vocabolario di settore, come il linguaggio contrattuale tedesco o la terminologia contabile turca. Lo proponiamo solo quando i test mostrano un guadagno netto, e lo eseguiamo sul tuo hardware con i tuoi esempi.

  • Può farlo il tuo team IT, con il runbook che consegniamo: come aggiornare un modello, tornare alla versione precedente, aggiungere una GPU, leggere il monitoraggio e ripristinare da backup. Molti clienti preferiscono tenerci con un piano mensile: manteniamo aggiornati modelli, driver e stack di serving, rieseguiamo i test quando i tuoi dati cambiano e teniamo d'occhio uso delle GPU e latenza. In ogni caso il sistema è tuo e funziona senza di noi.

  • Il primo incontro è gratuito. Entro una settimana hai un report di ricerca con i casi d'uso, la mappa dei dati, il dimensionamento dell'hardware e un prezzo fisso. Approvi il piano e paghi il 50%. Il primo caso d'uso è operativo sul tuo hardware in due-quattro settimane; una piattaforma completa con più casi d'uso, SSO e fine-tuning richiede fino a tre mesi. Il restante 50% si paga alla consegna, dopo che i test hanno superato le soglie concordate.

Non hai trovato la risposta?

Chiedi a una persona

Realizza il sistema su cui gira la tua azienda.

Prenota una call di scoping: definiamo insieme cosa costruire, quanto costa e in quanto tempo. La maggior parte dei team esce dalla prima chiamata con un piano già fissato.

Tre domande rapide, poi la fascia di prezzo e i tempi. Senza chiamata.