Claude Sonnet 5.5 çıktı: fiyat aynı ($2/$10), %30 tasarruf yalnızca uzun işlerde çıkıyor
Anthropic, Claude Sonnet 5.5'i 28 Eylül 2026'da tam olarak Sonnet 5'in fiyatıyla yayınladı: milyon input token'ı $2, milyon output token'ı $10. Bir gün sonra OpenRouter üzerinden 19 puanlı çağrı gönderdik. Uzun bir HTML dosyasında fatura %11,1 düştü. Küçük bir fatura toplama görevinde %12,8 yükseldi.
Fiyat aynı. Fatura farklı.
28 Eylül'de Claude Sonnet 5.5 çıktığında ne değişti?
Model id'sini claude-sonnet-5-5 yapın, token başına fiyatınız $2 input ve $10 output olarak kalır.
Anthropic'in fiyat sayfası Sonnet 5.5 ile Sonnet 5'i aynı satırlarda gösteriyor (cache ve batch dahil). Yani aralarındaki her maliyet farkı bir token sayısı farkıdır.
| Kalem | Lansmanda Sonnet 5.5 |
|---|---|
| API model id | claude-sonnet-5-5 |
| Input / output, 1M token başına | $2 / $10 |
| Cache okuma / cache yazma | $0.20 / $2.50 (5 dk), $4 (1 saat) |
| Batch input / output | $1 / $5 |
| Bağlam / azami output | 1M / 128K token |
| Varsayılan effort | Claude Code ve uygulamalarda Medium, API'de High |
| Erişilebilirlik | Sıfır veri saklama; AWS, Google Cloud, Microsoft Azure |
| GitHub Copilot | Pro, Pro+, Max, Business, Enterprise, liste fiyatıyla |
Kaynaklar: Anthropic'in Sonnet 5.5 model sayfası, lansman yazısı ve GitHub changelog'u. Arka plan için: Sonnet 5 neyi değiştirdi ve sağlayıcılar arası token fiyatları.
Fiyatlar USD cinsinden liste fiyatıdır. Türkiye'den kartla ödüyorsanız TRY karşılığı kura göre oynar, bu yüzden sabit bir lira rakamı yazmıyoruz.
Anthropic'in tablosunda Sonnet 5.5, Opus 5.5'e ne kadar yaklaşıyor?
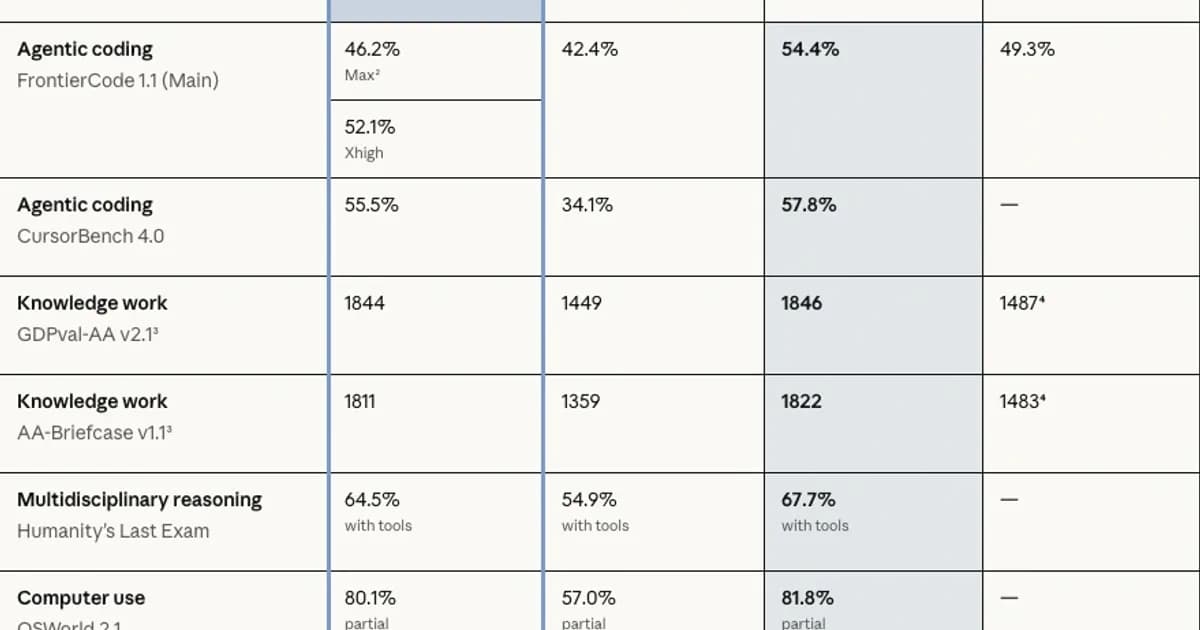
Sonnet 5.5, yüzde puanı veren altı satırın dördünde Opus 5.5'in üç puandan az gerisinde kalıyor; tek galibiyeti de hata payının içinde.
Hücreleri hero görselinden yeniden yazdık:
| Kıyaslama | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | %70,6 | %10,3 | %66,4¹ | yok |
| FrontierCode 1.1 Main | %46,2 (Max)², %52,1 (Xhigh) | %42,4 | %54,4 | %49,3 |
| CursorBench 4.0 | %55,5 | %34,1 | %57,8 | yok |
| GDPval-AA v2.1³ | 1844 | 1449 | 1846 | 1487⁴ |
| AA-Briefcase v1.1³ | 1811 | 1359 | 1822 | 1483⁴ |
| HLE (araçlarla) | %64,5 | %54,9 | %67,7 | yok |
| OSWorld 2.1 (kısmi) | %80,1 | %57,0 | %81,8 | yok |
| Chartography (araçsız) | %61,6 | %15,6 | %64,4 | %53,6⁴ |
¹ Opus, Xhigh effort'ta. ² Max, Xhigh'ın altında puan aldı: daha fazla kod inceleme subagent'ı çalıştırdı ve Cognition bunun iki durumda zaman aşımına veya kapsam dışı düzenlemeye yol açtığını gördü. ³ Artificial Analysis tarafından, yapılandırılmış output hatası olan (sonradan düzeltilmiş) bir ön sürüm dağıtımında çalıştırıldı. ⁴ GPT-6 Sol için bir görsel hatası yansımamış olabilir. Anthropic'in Terminal-Bench ve CursorBench grafikleri GPT-5.6 Sol'u gösteriyor.
FrontierCode'da (Xhigh) ve CursorBench'te fark 2,3, OSWorld'de 1,7, Chartography'de 2,8 puan. İstisna HLE: 3,2 puan. Elo satırlarında fark 2 ve 11.
Terminal-Bench satırı, r/ClaudeCode'daki "Sonnet 5.5 beats Opus 5.5 at coding and it's half the price??" başlıklı konuyu besliyor. Sistem kartı standart hataları ±2,5 ve ±2,6 puan veriyor. Yani 4,2 puanlık fark birleşik standart hatanın yaklaşık 1,2 katı, üstelik Sonnet max'ta, Opus xhigh'da koşmuş. Artificial Analysis aynı testte Sonnet 5.5'i %64 ölçtü. Opus'un en geniş farkı lansman sayfasının dışında: SWE-Bench Pro, 81,3'e karşı 89,9.
GPT-6 Sol, Anthropic'in tabloya koyduğu sütundan ibaret. GPT-6 Astra'nın Opus 5.5 ile nasıl kıyaslandığı için üçlü testimize bakın.
Anthropic'in %30 tasarrufu 19 API çağrısında ayakta kalıyor mu?
Yalnızca uzun işte: çıktı ortalaması 2.564 token olan HTML görevinde %11,1 ucuz, iki küçük görevde %10-13 pahalı.
29 Eylül'de 14:25 UTC'de OpenRouter üzerinden Sonnet 5.5 ve Sonnet 5'e 19 puanlı çağrı gönderdik: 3 görev, 3 deneme, 2 model, artı yüksek effort'lu bir ek çağrı. Toplam fatura $0.183434. Eşleşen 18 çağrının tamamı geçti.
# sonnet55_bench.py, 29 Sep 2026, POST https://openrouter.ai/api/v1/chat/completions
body = {
    "model": model,        # anthropic/claude-sonnet-5.5 or anthropic/claude-sonnet-5
    "messages": messages,
    "max_tokens": max_tokens,         # 12000 on the HTML task
    "reasoning": {"effort": effort},  # low: invoice, merge_intervals; medium: HTML
}
Puanlamayı hiçbir LLM yapmadı. Fatura görevi (800 bin cache okuma, 200 bin input, 50 bin output token'ı) tam olarak 1.06 döndürmek zorundaydı, merge_intervals 6 çalıştırılmış assert'ten geçti, HTML görevi doctype, canvas, requestAnimationFrame içermeli ve dış script barındırmamalıydı. Maliyetler, 3 denemenin usage.cost toplamıdır.
| Görev (effort) | Sonnet 5.5 | Sonnet 5 | Fark | Ortalama output token'ı | Ortalama gecikme |
|---|---|---|---|---|---|
| Fatura (low) | $0.002754 | $0.002442 | +%12,8 | 71 / 61 | 2,63 sn / 4,49 sn |
| merge_intervals (low) | $0.006054 | $0.005502 | +%10,0 | 172 / 154 | 3,06 sn / 3,68 sn |
| 150 kuşluk HTML (medium) | $0.077508 | $0.087156 | -%11,1 | 2.564 / 2.886 | 15,54 sn / 21,61 sn |
| Eşleşen toplam | $0.086316 | $0.0951 | -%9,2 | yok | yok |
Anthropic, "selefine göre görev başına %30'a kadar daha az" maliyet vaat ediyor. The Decoder'dan Matthias Bastian doğru uyarıyı ekledi: “Bağımsız testlerin bu iddiaları hâlâ doğrulaması gerekiyor.”
Low ve medium effort'taki 19 çağrılık ölçümümüzde, tek uzun görev olan HTML'de tasarruf %11,1 çıktı; küçük görevlerde ise +%12,8 ve +%10,0'a döndü. Liste fiyatı aynı olduğu için her tasarruf bir token sayısıdır. En küçük iki görevimizde Sonnet 5.5 daha az değil, daha çok token yazdı.
Hız daha iyi tuttu. HTML gecikmesi %28,1 düştü, işlem hacmi saniyede 133,5 token'dan 165,0'a çıktı (+%23,6): yön doğru, %30'un biraz altında. Sonnet 5 ayrıca her fatura çağrısında 54-63 reasoning token'ı kaydetti; Sonnet 5.5, 10 çağrının hepsinde 0 kaydetti.
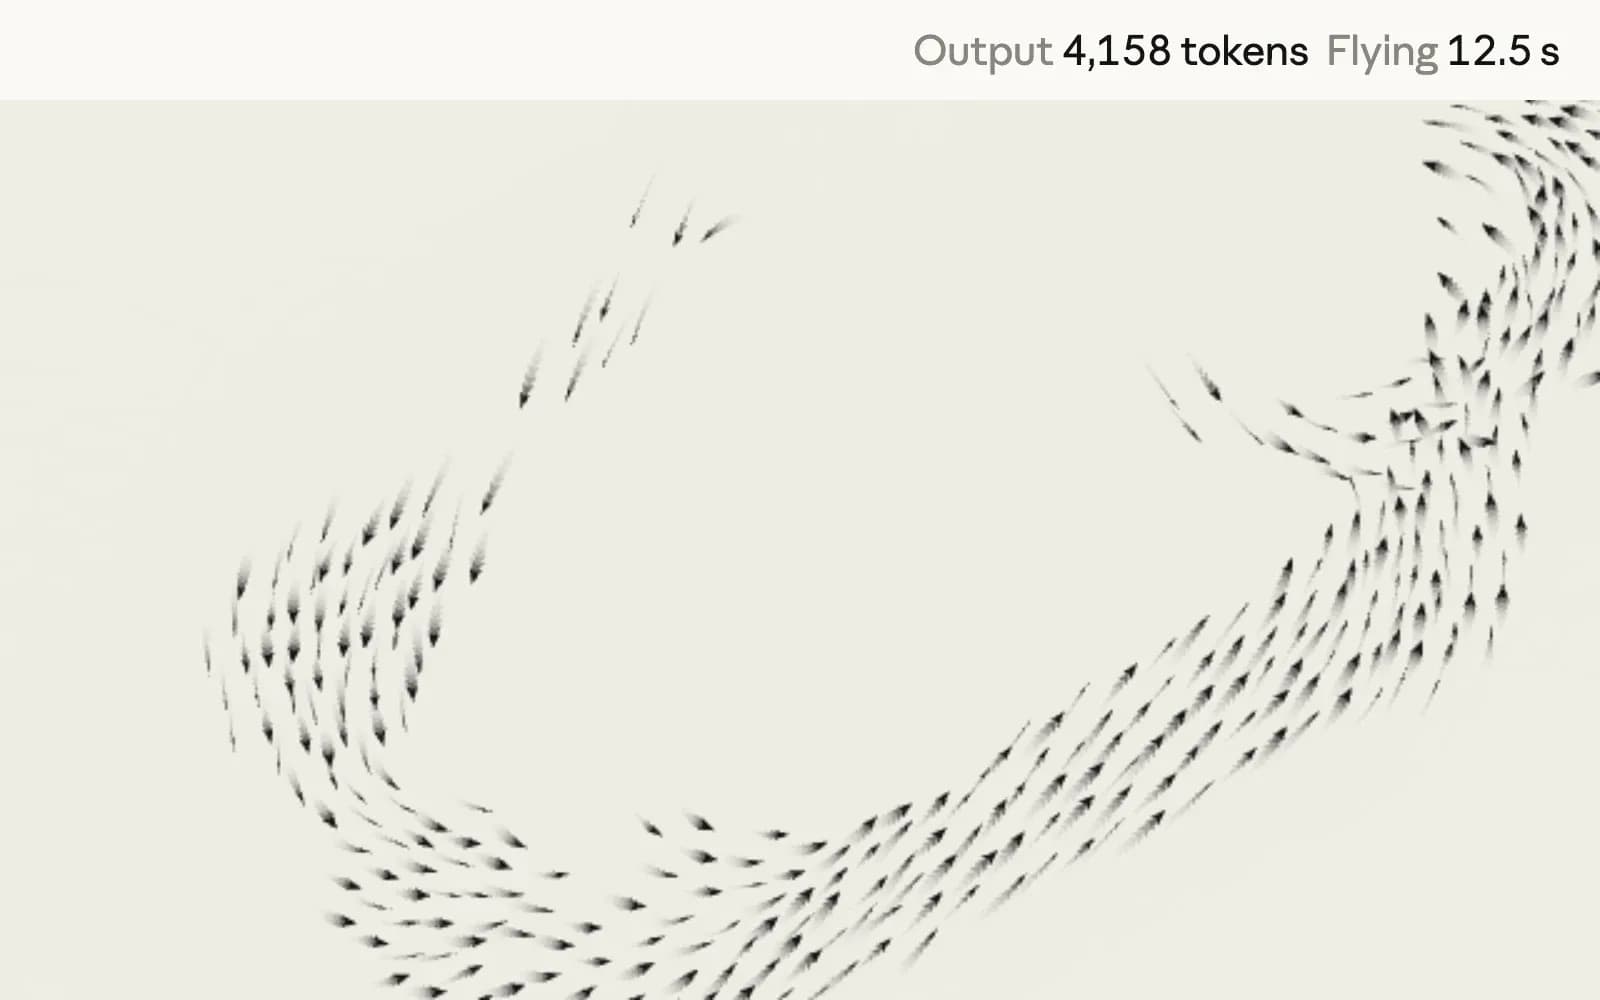
HTML görevi, Anthropic'in lansman sayfasındaki 400 sığırcık demo prompt'unun 150 kuşluk hâli. Aşağıdaki kareler Anthropic'in kaydı, bizim çalıştırmamız değil.
Anthropic'in lansman testçileri ne bildirdi?
“Hiçbir prompt'umuzu değiştirmeden Claude Sonnet 5.5, çevrimdışı Slackbot eval'lerimizin neredeyse hepsinde Sonnet 5'ten daha iyi çıktı; daha az adımda ve yaklaşık %14 daha az output token'ıyla.” Curtis Allen, Principal Engineer, Slack
“Yeni model, oyun sistemi mimarisi için on binlerce satır kodu yönetti, yanıtları hızlı tuttu, saatler süren görevleri idare etti ve daha az kısıtlayıcı prompt'la teslim etti.” Daniel Vogel, Chief Operating Officer, Epic Games
İkisi de üreticinin topladığı görüşler ve ikisi de uzun, çok adımlı işi anlatıyor. Bizim küçük görevlerimiz ters yöne gitti.
Ölçmediklerimiz: ajan işleri, yukarıdaki kıyaslamalar, cyber fallback. 3 deneme bir anlık ölçümdür; kendinizinkini yapmak için her çağrıda usage alanını okuyun.
Effort seviyesi faturayı neden modelden fazla oynatıyor?
Artificial Analysis, görev başına medium'da $0.59, max'ta $7.60 ölçtü: 15 endeks puanı için 13 kat sıçrama.
Max'ta şunu saydı: “Intelligence Index görevi başına ~193 bin output token'ı. Şimdiye kadar ölçtüğümüz en yüksek token kullanımı.”
| Effort | AA görev başı maliyet | AA Intelligence Index | AA sırası, 29 Eylül |
|---|---|---|---|
| Low | $0.41 | 36 | 216 içinde 63 |
| Medium | $0.59 | 41 | 216 içinde 44 |
| High | $1.08 | 47 | 216 içinde 23 |
| Max | $7.60 | 56 | 216 içinde 3 |
Satırlar AA'nın effort bazlı model sayfalarından, 29 Eylül'de alındı. AA'nın lansman yazısı Sonnet 5.5'in endekste ikinci olduğunu söylüyordu; model sayfası o gün 56 puan ve 216 içinde 3. sırayı gösteriyordu. Max ayrıca “Sonnet 5'in görev başına maliyetinden ~%50 yüksek” çıktı.
Kendi yüksek effort'lu çağrımız ayarı görmezden geldi: effort=high ile merge_intervals 172 output token'ı için $0.002018 tuttu, low ile aynı. Effort, yalnızca üzerinde düşünmeye değecek büyüklükteki işte etki ediyor; LLM API harcamasını kısmanın başladığı yer de burası.
Model id'sini değiştirince ne 400 döndürüyor?
Thinking'i kapatan her istek başarısız olur; onu between_tools yapın ve effort'u high veya altında tutun.
Anthropic'in geçiş rehberi hatayı açıkça yazıyor:
# Before (Sonnet 5 habit): 400 invalid_request_error on claude-sonnet-5-5
thinking = {"type": "disabled"}
# '"thinking.type.disabled" is not supported for this model. Use
#  "thinking.type.between_tools" for the lowest thinking setting, ...'

# After: accepted at low / medium / high effort, 400 at xhigh / max
thinking = {"type": "between_tools"}
output_config = {"effort": "medium"} # fixed for the conversation under between_toolstool_choicedeğerianyveyatoololursa 400 döner.autoilestrict: truekullanın (en fazla 20 strict araç); Amazon Bedrock'ta yalnızcaauto.- Opus 5, Opus 5.5, Fable veya Mythos'tan gelen thinking blokları sessizce düşürülür; 31 Ağustos 2026 ve sonrasında açılan hesaplar, geçmiş düzenlendikten sonra bir bloğu yeniden oynatınca 400 alır. Mekanik, Fable 5.1'in thinking bloğu bağlamasıyla aynı.
- Computer use için Claude API'de ve Google Cloud'da
computer_toolset_20260801gerekir. - Reddedilen isteklerde
stop_detailskategorisi yazılır:cyber,frontier_llm(“rakip yapay zekâ modellerinin geliştirilmesine yardımcı olabilir”) vereasoning_extractiondahil. - Sunucu tarafı fallback (
fallbacks: "default", beta, yalnızca Claude API) Sonnet 5'tecybervefrontier_llmretlerini yeniden dener; sistem kartına göre Terminal-Bench isteklerinin %1,2'si fallback'e düştü. - Cache'lenebilir asgari prompt 1.024 token'dan 512 token'a iniyor (prompt caching asgarileri) ve Claude Code'da
/claude-api migratebu değişiklikleri uyguluyor.
Güvenlik ekipleri 4. maddeye ilk çarpanlar. Bir HN yorumcusu, johnmlussier, Cyber Verification Program'da olmasına rağmen “yetkili bounty işlerinde Opus 5.5'i veya Sonnet 5.5'i kullanamıyoruz” dedi. Anthropic genişletilmiş programın “yakında” geleceğini söylüyor.
Aynı kontrol listesi “effort taramanızı yeniden çalıştırın ve maliyeti yeniden baz alın” diyor. %30'a güvenmeden önce bunu yapın.
Sonnet 5.5 mi Opus 5.5 mi: varsayılan yer kimin?
Kapsamı belli kodlama işleri ve yüksek hacimli çağrılar için Sonnet 5.5'i varsayılan yapın; açık uçlu muhakeme ve her max effort işi için Opus 5.5'i tutun.
Sonnet, liste fiyatında Opus 5.5'in $4/$20'sinin yarısı. Ama Artificial Analysis, max'ta Sonnet'in görev başına $7.60'a mal olduğunu, Opus 5.5'in ise $5.98 tuttuğunu ölçtü: yaklaşık %27 fazla.
| Sinyal | Sonnet 5.5 | Opus 5.5 | Yöneliş |
|---|---|---|---|
| Input / output, 1M başına | $2 / $10 | $4 / $20 | Sonnet, yarı fiyat |
| Cache okuma / 5 dk yazma | $0.20 / $2.50 | $0.20 / $5 | Okumada berabere |
| Cache ağırlıklı karışım (aşağıda) | $1.06 | $1.96 | Sonnet, 2 kat değil 1,85 kat |
| AA görev başı maliyet, max effort | $7.60 | $5.98 | Opus, %27 daha ucuz |
| SWE-Bench Pro | %81,3 | %89,9 | Opus, 8,6 puan farkla |
Mix: 800k cache-read + 200k input + 50k output tokens
Sonnet 5.5: 0.8 x $0.20 + 0.2 x $2 + 0.05 x $10 = $0.16 + $0.40 + $0.50 = $1.06
Opus 5.5:   0.8 x $0.20 + 0.2 x $4 + 0.05 x $20 = $0.16 + $0.80 + $1.00 = $1.96
Ratio: 1.96 / 1.06 = 1.85x
Aleksei Aleinikov'un “yaklaşık 1,65×” değeri, belirtmediği bir karışıma dayanıyor. Kendi karışımınızı yerine koyun: cache payınız ne kadar büyükse Sonnet'in avantajı o kadar küçülür.
Anthropic'in kendi sözü: “Opus 5.5, sürekli muhakeme gerektiren karmaşık, açık uçlu işlerde açıkça daha güçlü kalıyor.” Bir HN yorumcusu, datadrivenangel, daha da ileri gitti: “Low'daki Opus 5.5, medium'daki Sonnet'ten daha akıllı, daha ucuz ve daha hızlı görünüyor.” Biz bunu test etmedik. Opus fiyatları ve limitleri Opus 5.5 incelememizde.
29 Eylül'den itibaren varsayılanımız: medium effort'ta claude-sonnet-5-5. Max effort işleri Opus 5.5'e gidiyor, çünkü max'ta Sonnet ucuz model olmaktan çıkıyor.
Sık sorulan sorular
Claude Sonnet 5.5 ne zaman çıktı?
Anthropic, Claude Sonnet 5.5'i 28 Eylül 2026'da claude-sonnet-5-5 adıyla, aynı gün Amazon Web Services, Google Cloud, Microsoft Azure ve GitHub Copilot'ta yayınladı. Anthropic'in dokümanlarına göre 28 Eylül 2027'den önce emekliye ayrılmayacak.
Claude Sonnet 5.5, Sonnet 5'ten ucuz mu?
Token başına değil: ikisi de $2 input ve $10 output liste fiyatına sahip. Bizim ölçümümüzde uzun bir HTML görevi Sonnet 5.5'te %11,1 ucuz, küçük bir fatura görevi %12,8 pahalı çıktı; max effort'ta Artificial Analysis görev başına yaklaşık %50 fazla ölçtü.
Sonnet 5.5'i Claude Code ve GitHub Copilot'ta kullanabilir miyim?
Evet. Claude Code onu Medium effort ile başlatıyor; API varsayılanı High. GitHub Copilot'ta, Pro'dan Enterprise'a kadar, “kullanım bazlı faturalamada sağlayıcı liste fiyatı üzerinden” ücretlendiriliyor. Sabitlemek için Claude Code'da model değiştirme yazımıza bakın.
Sonnet 5.5'in bağlam penceresi ve bilgi kesim tarihi nedir?
1M token bağlam alıyor ve 128K'ya kadar output token'ı döndürüyor; sistem karttaki güvenilir bilgi kesim tarihi Haziran 2026.
Haiku 5.5 var mı?
29 Eylül 2026 itibarıyla yok. Anthropic 28 Eylül'de Claude Haiku 5.5'in “önümüzdeki haftalarda Claude 5.5 ailesine katılacağını” söyledi.