Claude Opus 5.5: $4/$20 fiyat, limitler ve ölçtüğümüz fatura
Claude Opus 5.5, 22 Eylül 2026'da milyon girdi token'ı başına $4, milyon çıktı token'ı başına $20 ile yayına girdi. Cache okuma $0.20. Girdi ve çıktıda bu, Claude Opus 5 fiyatının %20 altı. Cache okumada, Opus 5'in $0.50 satırına göre %60 altı. Platform id'si claude-opus-5-5. OpenRouter, 18:57 UTC'de anthropic/claude-opus-5.5 kaydını aynı üç tarifeyle listelemişti. Bağlam 1.000.000 token.
18:57 ile 18:58 UTC arasında dokuz puanlanmış çağrı gitti. Sekizi Opus 5 ile effort=low üzerinden eşleşti. Sekizi de geçti. Opus 5.5 faturası $0.010564. Opus 5 faturası $0.01269.
Dokuzuncu çağrı Opus 5.5'te effort=high idi. O da geçti. Faturası $0.003936. Deneyin toplamı $0.02719. Kapak, lansman sayfasındaki Anthropic grafiği. Olduğu gibi kaydettik.
Claude Opus 5.5 API fiyatı, Opus 5 karşısında
Yeni kart asıl farkı cache'i ağır trafikte açıyor. Cache'siz çağrılar bizim ölçerde yaklaşık %20 ucuzladı.
Aşağıdaki tablo ve fiyat görüntüsü, Anthropic'in lansman kartı. Standart tarife bu. Fable 5.1 $10/$50'de kalıyor. Cache okuması $0.25. Opus 5.5 cache satırı Fable'dan milyon başına $0.05 ucuz. Yarı fiyat değil. 2,5 katlık fark girdi ve çıktıda: $10/$4 ve $50/$20.
| Satır, 1 milyon token başına | Opus 5.5 | Opus 5 | Fable 5.1 |
|---|---|---|---|
| Girdi | $4 | $5 | $10 |
| Çıktı | $20 | $25 | $50 |
| Cache okuma | $0.20 | $0.50 | $0.25 |
| Cache yazma, 5 dk | $5 | $6.25 | $12.50 |
| Cache yazma, 1 saat | $8 | $10 | $20 |
| OpenRouter batch girdi / çıktı | $2 / $10 | $2.50 / $12.50 | $5 / $25 |
| Fast mode girdi / çıktı | $8 / $40 | bu kartta yok | bu kartta yok |
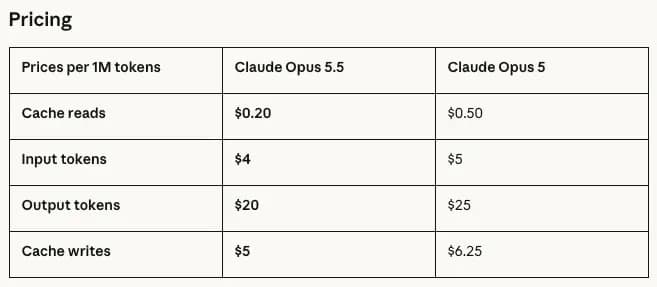
5 dakikalık cache yazma ($5 ile $6.25) hem Anthropic sayfasında hem de Artificial Analysis notunda duruyor.
1 saatlik yazma ($8) ile batch rotası ($2/$10, cache okuma $0.10) OpenRouter'ın 18:57 UTC'deki /api/v1/models payload'unda. Lansman tablosu bu satırları basmıyor.
Fast mode lansman sayfasında: hız en fazla 2,5 kat, fiyat $8 ve $40. Bu, standart Opus 5.5'in 2 katı. Opus 5'in $5/$25 kartının da üstünde.
Dokuz puanlanmış çağrı ve çıkardıkları fatura
Eşleşen 8 çağrının hepsi geçti. Opus 5.5 $0.010564 tuttu, Opus 5 $0.01269. Düşüş %16,8.
OpenRouter chat completions. Temperature yok. reasoning.effort değeri low idi. Bir kodlama çağrısı high idi.
İki görev, iki deneme. Puanlayıcılar tam eşleşme ve çalıştırılan testlerdi. Cache'lenen token: 0. Invoice prompt'ları: 104 token.
# 22 Sep 2026, 18:57 UTC, OpenRouter
MODELS = ["anthropic/claude-opus-5.5", "anthropic/claude-opus-5"]
# invoice answer must be 1.96
# 800_000 * 0.20/1e6 + 200_000 * 4/1e6 + 50_000 * 20/1e6
# coding: merge_intervals, hidden tests, function only| Küme | Opus 5.5 | Opus 5 |
|---|---|---|
| Invoice, 2 deneme | 2/2, $0.002652, 45 ve 46 çıktı, 3,089 sn ve 5,100 sn | 2/2, $0.00332, 46 ve 46 çıktı, 6,765 sn ve 3,997 sn |
| merge_intervals, 2 deneme | 2/2, $0.007912, 168 ve 168 çıktı, 3,597 sn ve 3,239 sn | 2/2, $0.00937, 161 ve 155 çıktı, 3,435 sn ve 3,582 sn |
| Eşleşen toplam | $0.010564, 8/8 | $0.01269, 8/8 |
| effort=high, 1 kod çağrısı | geçti, $0.003936, 167 çıktı, 0 reasoning token | çalıştırılmadı |
Invoice çifti temiz %20 örneği: %20,1 daha ucuz, completion sayısı neredeyse aynı. Fonksiyon çifti ıskalama. Opus 5.5, 316'ya karşı 336 completion token yazdı ve fatura yalnızca %15,6 düştü. Liste fiyatı %20 indi. Token sayısı arttı. Net tasarruf küçüldü. effort=high o fonksiyonu uzatmadı: 167 completion token, 0 reasoning token, $0.003936, testler geçti. Artificial Analysis öteki rejimi gördü. Max ayarda Intelligence Index görevi başına yaklaşık 119.000 çıktı token'ı, Opus 5'te yaklaşık 73.000. Görev başı maliyet aynı kaldı. Oraya %40 indirim yazmayın. Bizim 9 çağrımız o rejime girmedi.
Gecikme bu örnekte berabere. Kodlama ortalamaları 3,42 sn ve 3,51 sn. Invoice ortalamaları 4,09 sn ve 5,38 sn. Aralıklar çakışıyor: 5,100 sn ile 3,997 sn.
Anthropic, çıktının Opus 5'ten %30'dan fazla daha hızlı olduğunu söylüyor. Bu 9 çağrı bunu göstermiyor.
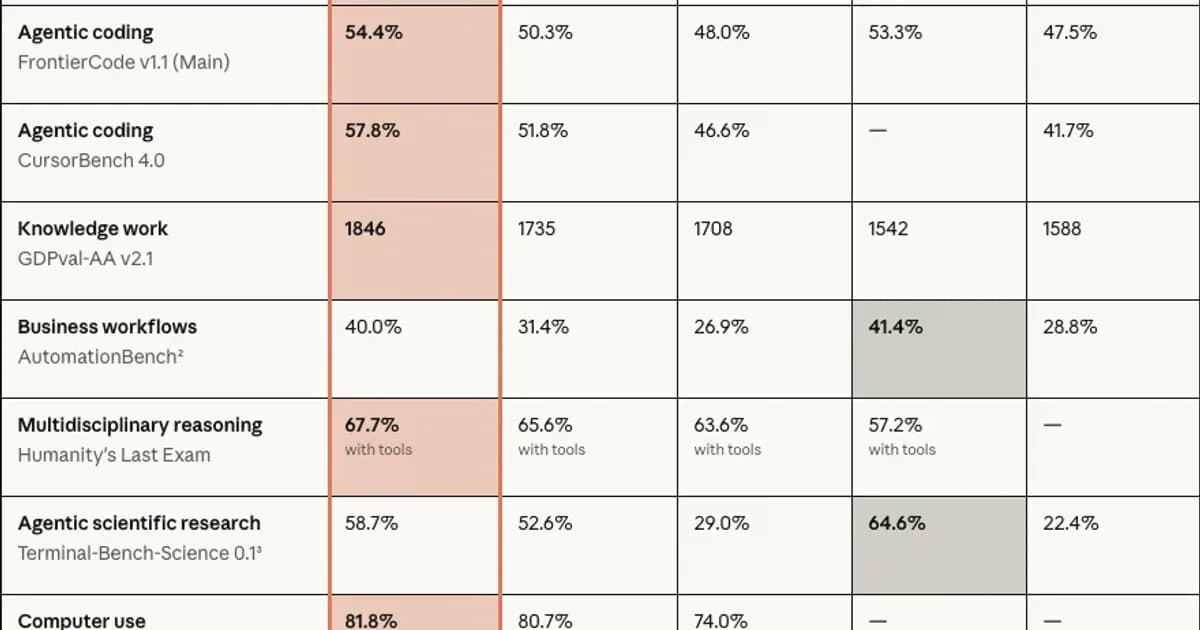
Anthropic grafiğinin önde olduğu yer ve olmadığı yer
Astra, sayısı olan iki satırda önde: AutomationBench %41,4, Terminal-Bench-Science %64,6.
22 Eylül grafiğindeki, sayısı olan diğer her hücrede Opus 5.5 önde. Kapak görseli bu grafik. Aşağıdaki hücreler oradan kopyalandı.
Anthropic, bu Opus 5.5 sayılarının max effort'ta adaptive thinking ile alındığını söylüyor. Tek uyarı: Terminal-Bench 4.0'da Opus 5.5 xhigh, GPT-6 Astra high. Astra rakamı OpenAI'nin bildirdiği değer.
| Benchmark | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | %66,4 | %55,8 | %52,3 | %57,9 | %37,3 |
| FrontierCode v1.1 (Main) | %54,4 | %50,3 | %48,0 | %53,3 | %47,5 |
| CursorBench 4.0 | %57,8 | %51,8 | %46,6 | yok | %41,7 |
| GDPval-AA v2.1 | 1846 | 1735 | 1708 | 1542 | 1588 |
| AutomationBench | %40,0 | %31,4 | %26,9 | %41,4 | %28,8 |
| Humanity's Last Exam, araçlarla | %67,7 | %65,6 | %63,6 | %57,2 | yok |
| Terminal-Bench-Science 0.1 | %58,7 | %52,6 | %29,0 | %64,6 | %22,4 |
| OSWorld 2.0, kısmi | %81,8 | %80,7 | %74,0 | yok | yok |
| Chartography, araçlarla | %89,0 | %88,4 | %83,4 | yok | yok |
Bir puanlık farka göre rota çizmeden önce dipnotları okuyun.
- Güvenlik önlemleri açık kaldı. Siber fallback Opus 4.8 idi. Biyoloji ve frontier-LLM fallback'i Opus 5 idi. Anthropic, bunun skoru büyük olasılıkla düşürdüğünü söylüyor.
- Zapier, AutomationBench'i fallback olmadan çalıştırdı. Müdahale ıskalama sayıldı. %40,0 erken erişim. Astra'nın %41,4 değeri kamu tablosu.
- Terminal-Bench 4.0 hata payı ±2,6 puan. %66,4 ile %57,9 arasındaki fark bu payı aşıyor. FrontierCode'da %54,4 ile %53,3 arasındaki fark bu payı aşmıyor.
- Anthropic, günlük kullanımdaki farkın Fable 5.1 karşısında bu grafikten daha dar olduğunu söylüyor.
- Artificial Analysis, aynı gün, başka kurulum: Terminal-Bench 4.0 %59,6, Astra'nın xhigh sonucuyla aynı seviyede. Humanity's Last Exam %61,4, Fable 5.1 için %59,1. %66,4 ile %59,6'yı ortalamayın.
Varsayılan effort ayrı bir satır. FrontierCode medium'da %54,6. CursorBench medium'da %52,5. Yukarıdaki %57,8 değil. Anthropic, bu medium FrontierCode skorunun Astra'nın en iyisini görev başına yaklaşık beşte bir maliyetle geçtiğini söylüyor.
$4 fiyatın kaldırmadığı limitler
Siber görevler Opus 4.8'e düşüyor. Thinking her API hesabında açık kalıyor.
Daha ucuz kart, son iki Claude lansmanını operasyonda zorlaştıran kısıtları silmedi. 22 Eylül'de değişen ve değişmeyen:
- Beş saatlik limitler Pro, Max, Team ve koltuk bazlı Enterprise'da yükseliyor. Kaydedebileceğiniz bir sıfırlama da var. Yayımlanmış yeni bir mesaj sayısı yok. Haftalık tavanın kalktığı yazılmıyor. Eski pencere kuralları kullanım limiti yazısında.
- Siber, biyoloji ve distillation önlemleri Fable sınıfıyla aynı. Rutin hata düzeltme duruyor. Siber görevlerin çoğu Opus 4.8'e yeniden yönleniyor. Biyoloji için Life Sciences Verification Program şart. Daha geniş siber program lansman günü açık değildi.
- Thinking kapatılamıyor. Lansman sayfası bu kısıt için model belgelerini gösteriyor. Fable 5.1'deki anti-distillation kontrolü olan preserved thinking, API kullanıcılarının önceki reasoning metnini düzenlemesini engelliyor. 31 Ağustos 2026 veya sonrasında açılan API hesaplarında Opus 5.5 için geçerli.
- Model, AB Yapay Zekâ Yasası için watermark taşıyor. Sıfır veri saklama hâlâ var. Önceki Opus modelleriyle aynı.
- Containment-boundary denemeleri Opus 5 ve Mythos 5.1'e göre yaklaşık %85 azaldı. Anthropic böyle diyor. Kalanlar düşük şiddetliydi ve kendi bildirimiydi. Model sık sık karşısında bir eval olduğunu sanıyor. Bu denetim üretimi kötü tahmin ediyor.
- Sonnet 5.5 ve Haiku 5.5 bugün API'de yok. Sayfa, önümüzdeki haftalarda geleceklerini söylüyor. Tarih yok.
İş yükünüz ofansif güvenlik ya da ıslak laboratuvar tasarımıysa, $4, kısıtsız bir Opus 5.5'in fiyatı değil. Sınıflandırıcı bu çağrıların bir kısmını daha eski bir modele harcıyor. İz kaydınız fallback'i göstermeli. Göstermezse yanlış id'yi faturalarsınız.
Erken test edenler Anthropic'e ne dedi
GitHub, Optiver ve Box, Opus 5'ten daha az token bildirdi. Bu satırlar Anthropic'in yayımladığı alıntılar.
İmzalı erken erişim notu. Bağımsız bir pano değil. @claudeai 16:31 UTC'de paylaştı. Aynı saat içindeki yanıtlar Pro'daki boş payı ve hata ayıklamayı övdü. Paylaşılan iz yok.
| Lansman sayfasında kim | Ne dedi | Neyi kanıtlamaz |
|---|---|---|
| Mario Rodriguez, GitHub | Ölçtükleri en düşük token. VS Code terminal görevleri, Opus 5'in adım sayısının yarısından az. | Kamuya açık log yok. |
| Noyan Tokgozoglu, Optiver | Opus 5 kalitesi; tur, süre ve çıktı token'ı yaklaşık yarıda. Maliyet %40 ile %50 düştü. | Kendi masası. Bizim düşüşümüz %16,8, cache 0. |
| Yashodha Bhavnani, Box | Token'ların üçte biri, %40 daha az söz, doğruluk aynı kaldı. | Kendi içerik eval'i. |
| Zimu Li, Factory | Medium, high ayardaki Opus 5 ile aynı işi gördü. Çıktı token'ı %20 ile %25 daha az. | Bizim high sabitlememiz token sayısını düşürmedi. |
| Fabian Hedin, Lovable | Adım sayısı üçte bir ile yarı arasında azaldı. Token da azaldı. | Onların builder döngüsü. API kartı değil. |
Alıntılar daha az adım ve daha az token anlatıyor. Kesinti, liste fiyatındaki %20 indirimden büyük. Bizim fonksiyon tersini yaptı: 336 completion token, karşıda 316.
İkisi birden doğru olabilir. Anthropic, 200.000 satırlık bir denetimin 3 saatin altında bittiğini söylüyor. Opus 5'te 20 saati geçiyordu. Token 2,5 kat daha azdı. Biz bunu yeniden çalıştırmadık.
Cache'i ağır bir tur faturayı nasıl değiştirir
500.000 token'lık bir cache yeniden okuması Opus 5'te $0.25, Opus 5.5'te $0.10.
Bu, yayımlanan tarifelerin hesabı. 9 çağrıdan biri değil. O çağrılar hiçbir token cache'lemedi. Gösterdikleri, %20 indirim eksi fazladan token. Kendi prefix uzunluğunuzu koyun. Karışım yüzdeyi değiştiriyor.
| İş yükü | Opus 5 | Opus 5.5 | Düşüş |
|---|---|---|---|
| 500.000 cache okuma token'ı | $0.25 | $0.10 | %60 |
| 20.000 taze girdi + 8.000 çıktı, cache yok | $0.30 | $0.24 | %20 |
| 500.000 cache + 20.000 girdi + 8.000 çıktı | $0.55 | $0.34 | %38 |
| Aynı 20.000 girdi + 8.000 çıktı, fast mode $8/$40 | yok | $0.48 | standart 5.5'e göre fiyat artışı |
Üçüncü satırdaki %38, %20'lik token indiriminin “tipik iş yükünde yaklaşık %40 daha az” sözüne dönüşme yolu. Cache'i ağır bir ajan, varsayılan ayar, bir de daha az token. Cache'i çıkarın. Model daha uzun konuşana kadar yine %20'desiniz. Fast mode ters yönde işler. Cache'siz dilimde $0.48, standartta $0.24. Fiyat tablosundaki batch satırı ($2/$10) katalog fiyatı. Batch işi göndermedik.
22 Eylül sonrası hangi id sabitlenir
Görev siber ya da biyoloji değilse, yeni ajan trafiğinde claude-opus-5-5 sabitleyin.
Temmuz'daki Opus 5 yazısı, Fable sınıfı bir modeli Fable token kartının yarısı diye fiyatlamıştı. Bu tarife 22 Eylül itibarıyla eski.
Opus 5.5, Opus 5'in girdi ve çıktısına göre bir %20 daha ucuz. Cache okumada %60. Önlemler artık gevşek Opus hattını değil, Fable 5.1'i izliyor. Aynı gün ölçülen Grok 4.7 başka bir kart.
- Bizim puanladığımız gibi cache'siz, kısa API çağrıları: bunları Opus 5.5'e alın. Geçme oranı 8/8 berabere. Bu sette fatura %16,8 düştü. Completion sayıları tutunca düşüş %20,1.
- Büyük bir prefix'i yeniden okuyan ajan döngüleri: onları da alın. Bütçeyi %16,8'lik invoice hesabına değil, %38'lik örneğe yakın kurun. Yanıtta
cached_tokenssıfırdan büyük mü, bakın. Değilse hâlâ %20 yolundasınız. - Max effort araştırma eval'leri: siz ölçene kadar eski Opus 5 bütçesini tutun. AA'nın Intelligence Index görev başı maliyeti, token fiyatıyla birlikte düşmedi.
- Siber saldırı, biyoloji Ar-Ge, distillation tarzı yoklama: Opus 5.5'in cevap vereceğini planlamayın. Opus 4.8, Opus 5 ya da ret bekleyin. Kapı, Anthropic'in adını verdiği doğrulama programları.
- Fast mode: $8/$40'ı ancak 2,5 kat hız, 2 kat token'a değiyorsa ödeyin. Ucuz katman değil.
- Fable 5.1'i yalnızca bu 9 çağrının görmediği bir kalite farkını ölçtüğünüz yerde sabit bırakın. Fable girdi ve çıktıda 2,5 kat. Cache okuma $0.25, Opus 5.5'te $0.20.
Sık sorulan sorular
Claude Opus 5.5 API model id'si nedir?
Claude Platform'da id claude-opus-5-5. OpenRouter'da anthropic/claude-opus-5.5, batch için anthropic/claude-opus-5.5:batch. Standart id'yi 22 Eylül 2026, 18:57 UTC'de çağırdık. Listelenen bağlam 1.000.000 token. Fast mode bir fiyat ($8/$40). Lansman sayfasında ikinci bir id değil.
Claude Opus 5.5 beş saatlik kullanım limitini kaldırıyor mu?
Hayır. Beş saatlik limit Pro, Max, Team ve koltuk bazlı Enterprise'da yükseliyor. Bir sıfırlama kaydedilebiliyor. Yayımlanmış bir mesaj sayısı yok. Haftalık tavanın kalktığı yazılmıyor. API'de dakika başı token limiti ayrı bir sayaç. Önce Settings, sonra Usage.
Opus 5.5'te thinking kapatılabiliyor mu?
Anthropic hayır diyor. 22 Eylül sayfası, thinking'in artık kapatılamadığını söylüyor. Preserved thinking, 31 Ağustos 2026 veya sonrasında açılan hesapların önceki reasoning metnini düzenlemesini de engelliyor. Bizim effort=high çağrımız normal bir fonksiyon döndürdü. OpenRouter usage nesnesinde 0 reasoning token vardı. High sabitlemek, görünen bir düşünce zinciri değil.
Her iş yükünde %40 maliyet düşüşü gerçek mi?
Bizde değil. Sekiz cache'siz çağrı %16,8 daha ucuza geldi. Invoice çifti tek başına %20,1 daha ucuzdu. 500.000 cache okuma token'ı artı kısa bir completion ile kurulan karışım %38'e iniyor. Artificial Analysis, max effort Intelligence Index görevlerinin Opus 5 ile yaklaşık aynı maliyette kaldığını söylüyor. Çıktı token'ı yaklaşık 1,6 kat artmış.
Claude Sonnet 5.5 ve Haiku 5.5 ne zaman çıkıyor?
Anthropic, 22 Eylül 2026 sayfasında ikisinin de önümüzdeki haftalarda geleceğini söyledi. Tarih yok. O akşam çağırabildiğimiz tek 5.5 id Opus 5.5'ti. Opus olmayan daha ucuz rota hâlâ bir önceki Sonnet ya da Haiku kartı.