Grok 4.7 vs Grok 4.6: aynı $2/$6, skor tablosu işe göre ayrılıyor
Grok 4.7, 21 Eylül 2026'da milyon input token başına $2 ve milyon output token başına $6 ile yayına girdi. Kart, Grok 4.6 ile aynı. SpaceXAI'nin skor tablosu 4.6'ya karşı her satırı 4.7'ye veriyor, sonra bu yedi satırın dördünü Fable 5.1 Max'a kaybediyor. İki grafiği de lansman sayfasından kaydettik. 22 Eylül'de, 14:51 ile 14:53 UTC arasında, OpenRouter üzerinden 12 puanlı çağrı gönderdik.
Grok 4.7, Grok 4.6'yı nerede gerçekten geçiyor
Elektrik, hukuk ajanı ve terminal işini Grok 4.7'ye yönlendirin. Klinik maddeleri Fable 5.1'de veya GPT-5.6 Sol'da bırakın.
Lider sütunundaki her rakam 21 Eylül lansman yazısından geliyor (erişim: 22 Eylül 2026). Son satır bizim.
| İş yükü | Satırın lideri | Grok 4.7 | Yönlendirme |
|---|---|---|---|
| EEBench | Grok 4.7 xHigh | %64,0 | Grok 4.7 |
| Harvey hukuk ajanı | Grok 4.7 xHigh | %19,6 | Grok 4.7. Kullanıcıya %80,4'ün hâlâ ıskalandığını söyleyin |
| Terminal-Bench 4.0 | Fable 5.1 Max, %57,9 | %38,0 | 4.6'dan çıkışta 4.7. Skor ürünün kendisiyse Fable |
| CursorBench 4.0 | Fable 5.1 Max, %51,8 | %46,3 | Fable. $6 output 5,5 puanlık farkı yeniyorsa 4.7 |
| DeepSWE v1.1 | GPT-5.6 Sol Max, %72,7 | high'da %71,0, xHigh değil | Sol. 1,7 puan $20 output'a değmiyorsa 4.7 |
| AA Briefcase v1.1 | Fable 5.1 Max, 1.678 | 1.657 | 21 Elo ile Fable. Output faturası baskınsa 4.7 |
| HealthBench Professional | Fable 5.1 Max, %62,1 | %56,7 | Fable veya Sol (%60,5). 4.7 değil |
| Dört kısa çağrı, bizim | Berabere | 4/4 | Elinizdeki istemci kalsın |
Grok 4.6 High, yayımlanan yedi satırın hepsinde 4.7'nin altında duruyor. Halihazırda çalıştırdığınız modele karşı bütün yükseltme gerekçesi bu. Editör işinde, ofis işinde, terminal işinde ve klinik maddelerde Fable'a karşı bir yükseltme gerekçesi değil. Grok 4.7 vs Fable 5.1 hesabında o dört satır Fable'da kalıyor.
SpaceXAI'nin iki grafiği neyi sayıyor
Turuncu sütun xHigh. API varsayılanı high. DeepSWE'deki %71,0, high diye işaretli.
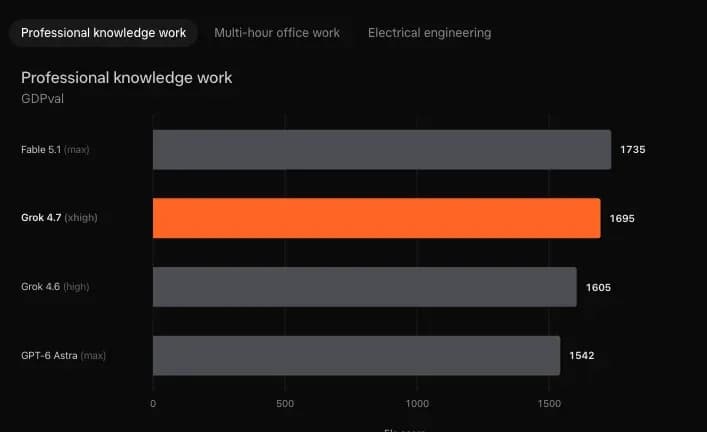
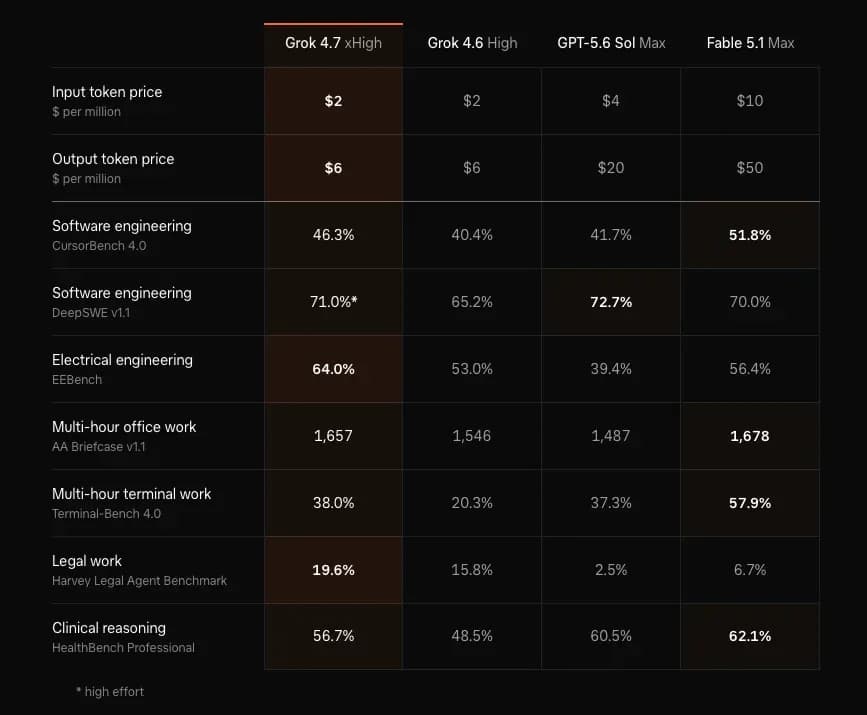
İki grafik de lansman sayfasındaki Grok 4.7 benchmark tablosundan geliyor. GDPval sırası şöyle: Fable 5.1 max 1.735 Elo, Grok 4.7 xhigh 1.695, Grok 4.6 high 1.605, GPT-6 Astra max 1.542. 4.6'ya göre +90 Elo. Fable'ın 40 Elo gerisinde. Astra'nın 153 Elo önünde. Bu grafikteki OpenAI adı Astra. Skor tablosundaki OpenAI adı GPT-5.6 Sol Max. İkisi ayrı modeller. Lansman sayfası ikisini de kullanıyor.
- Turuncu sütunu xHigh diye okuyun. xAI belgeleri varsayılan effort değerini high koyuyor.
- %71,0 değerini high effort diye okuyun. Yıldız o DeepSWE hücresinde duruyor. Başka hiçbir Grok 4.7 hücresinde yok.
- Astra'nın 1.542 Elo değerini grafikte tutun. Sol'un sütununa yapıştırmayın.
Artificial Analysis ofis işindeki kazancı ikiye ayırıyor. AA-Briefcase satırında analitik kalite, Grok 4.6 high'da 1.690 Elo'dan Grok 4.7'de 1.994 Elo'ya çıkmış. Sunum kalitesi 1.519 Elo'dan 1.499 Elo'ya inmiş. Analiz keskinleşmiş. Belge olarak biraz kötüleşmiş.
CursorBench, Cursor'ın kendi paketi. SpaceX, Cursor'ın yapımcısı Anysphere'i 16 Haziran 2026'da $60B'lik hisse karşılığında almayı kabul etti.
Grok 4.7 API'de grok-4.7 olarak, Cursor'da ve Grok Build'de varsayılan model olarak duruyor. 12 Ağustos tarihli Grok 4.6 ve Grok 4.5 yazısı, 4.7'nin henüz çıkmadığını söylüyordu. O cümle 12 Ağustos'ta doğruydu. 21 Eylül'de doğru olmaktan çıktı.
Grok 4.7 kartındaki $2 ve $6 neyi göstermiyor
250.000 token'lık bir prompt, istekteki her token için $4 ve $12 üzerinden faturalanıyor.
Grafik $2 ve $6 yazıyor. Modeller sayfası iki satır yazıyor. 200.000 prompt token'ının altında tarifeler $2 input, $0.50 cache'lenmiş input ve $6 output. 200.000 ve üstünde isteğin tamamı $4, $1 ve $12'ye çekiliyor.
prompt, output = 250_000, 2_000
chart_rate = prompt / 1e6 * 2 + output / 1e6 * 6     # $0.512
cliff_rate = prompt / 1e6 * 4 + output / 1e6 * 12    # $1.024
Uçurumu geçmek, grafiğin hiç göstermediği faturayı ikiye katlıyor. $0.512, $1.024 oluyor. 200.000'in altındaki token'lar ucuz tarifeyi korumuyor.
$2'lik input, GPT-5.6 Sol'un $4'ünün yarısı ve Fable 5.1'in $10'unun beşte biri. $6'lık output, Sol'un $20'sinden 3,3 kat, Fable'ın $50'sinden 8,3 kat ucuz. Output başına $1 ile Grok 166.667 token, Sol 50.000 token, Fable 20.000 token veriyor. “Yarı fiyat” Sol'a karşı input satırıyla örtüşüyor. İki output satırının hiçbiriyle örtüşmüyor.
Cache'lenmiş input, 200.000 token'ın altında milyon başına $0.50 kalıyor. Rakam Grok 4.6 ile aynı. Uçurumda $1. Bu cache satırının gerçek faturaya nasıl vurduğu, inference maliyet rehberinin konusu.
Grok 4.7 Fast ayrı bir anahtar. Çıktı hızı iki katına çıkıyor, token fiyatı da iki katına çıkıyor. Cursor ve Grok Build içinde çalışıyor. 200.000 token uçurumu bu değil. Herkese açık API bunu satmıyor.
Artificial Analysis uzun prompt'ları yaklaşık saniyede 188 token ve Intelligence Index görevi başına yaklaşık 7,1 dakika ölçmüş. Bizim kısa çağrı medyanımız Grok 4.7 high için 5,02 saniye, Grok 4.6 high için 8,12 saniye. İki rakam da Fable veya Sol karşısında 2 kat hız iddiası değil.
22 Eylül'de 12 Grok 4.7 çağrısı ne döndürdü
On iki çağrı 12/12 tuttu. xhigh, high ile aynı dört yanıtı döndürdü.
Aynı dört prompt, temperature 0, max_tokens 4000, her biri tek deneme, araç yok. Grok 4.6 high, Grok 4.7 high, Grok 4.7 xhigh. Gateway OpenRouter'dı. Kurulum, LLM gateway karşılaştırmamızdaki kurulumla aynı. Ham usage nesneleri bu yazının yanındaki benchmark-raw.json dosyasında. On iki çağrının OpenRouter usage.cost toplamı $0.029279 tuttu.
{
  "model": "x-ai/grok-4.7",
  "temperature": 0,
  "max_tokens": 4000,
  "reasoning": {"effort": "xhigh"},
  "messages": [{"role": "user", "content": "..."}]
}| Görev | Beklenen | 4.6 high | 4.7 high | 4.7 xhigh |
|---|---|---|---|---|
| 3, 1, 4, 1, 5, 9 medyanı | 3,5 | 3,5, 6,17 s, 348 tok | 3,5, 5,42 s, 359 tok | 3,5, 4,67 s, 300 tok |
| 5 mA'de 2,2 kΩ | 11 V | 11, 8,06 s, 511 tok | 11, 4,62 s, 273 tok | 11, 5,31 s, 348 tok |
| 429 ve 503 yeniden, 500 asla | 429,503 | 429,503, 78,30 s, 451 tok | 429,503, 3,37 s, 216 tok | 429,503, 2,07 s, 87 tok |
count_passed([59, 60, 100, 0]), döngü indeks 1'den başlıyor | 2 | 2, 8,18 s, 466 tok | 2, 6,10 s, 409 tok | 2, 5,16 s, 368 tok |
Completion token'ları Grok 4.6 high'da 1.776 iken Grok 4.7 high'da 1.257'ye, xhigh'da 1.103'e düştü. Bu completion sayımlarının içindeki reasoning token'ları 1.543, sonra 1.052, sonra 944. OpenRouter faturası onlarla birlikte gitti: $0.012258, sonra $0.008877, sonra $0.008144. İki modelin de 4/4 bitirdiği bir testte, high tarafında %29,2 daha az completion token ve %27,6 daha küçük bir fatura.
Grok 4.7'de prompt_tokens, high'daki eş Grok 4.6 çağrısının tam 1.036 üstünde döndü: 1.311'e karşı 275, 1.288'e karşı 252, 1.295'e karşı 259, 1.339'a karşı 303. xhigh her çağrıya bir token daha ekledi. Milyon başına $2 ile 1.036 token $0.002072 tutuyor. Medyan kalem 4.6'da $0.002446, 4.7 high'da $0.002438 faturalandı. Fark faturada görünmedi. Grok 4.6'nın dört faturası, dönen sayılarda $2 ve $6 ile tutuyor. Fazladan bin için satır kalemi yok.
78,30 saniyelik deneme tek prompt, tek deneme. Grok 4.7 high aynı yeniden deneme kümesini 3,37 saniyede, xhigh 2,07 saniyede yanıtladı. Üçü de 429,503 döndürdü. Dört prompt'ta medyan gecikme 8,12 s, 5,02 s ve 4,92 s. Tek yavaş denemeyi hız oranına çıkarmayın.
Uzun işte token hesabı tersine dönüyor. Artificial Analysis, Grok 4.7 xhigh için Intelligence Index görevi başına yaklaşık 81.000 output token, Grok 4.6 high için yaklaşık 36.000 bildirdi. 316 token'lık medyanımız dört kısa yanıtı anlatıyor. Çok saatlik bir AA Briefcase işini anlatmıyor.
%38'lik terminal skoru nereden geliyor
Yayımlanmış üç Terminal-Bench 4.0 rakamı uyuşmuyor: %38,0, %33 ve 4,5 puanlık bir artış.
- xAI lansman tablosu, yukarıdaki ekran görüntüsü: Grok 4.7 xHigh %38,0, Grok 4.6 High %20,3, GPT-5.6 Sol Max %37,3, Fable 5.1 Max %57,9. 4.6'ya karşı bu 1,87 kat, yani +17,7 puan. Sol'a karşı +0,7 puan. Fable 19,9 puan önde.
- Artificial Analysis, ajan olarak Grok Build, 21 Eylül 2026: Terminal-Bench 4.0 %18'den %33'e, DeepSWE v1.1 %65'ten %73'e çıkmış. Coding Agent Index 47'den 56'ya gelip dördüncü olmuş. Önünde Fable 5.1, GPT-6 Astra ve Claude Opus 5 var.
- Aynı laboratuvarın Intelligence Index'i, her model için tek paylaşılan runner: Terminal-Bench 4.0'da +4,5 puan, indeks 2 puan artarak 46. AA-LCR 3,7 puan düşmüş. AutomationBench-AA 1,1 puan düşmüş.
xAI, %38,0'ın arkasındaki ajanı adlandırmıyor. İstemcinizle uyuşan rakamı esas alın. Fable 5.1 incelemesi, Fable için Terminal-Bench 4.0'da %55,8 kaydediyor. Bu tabloda rakam %57,9. Astra'nın kodlama indeksi GPT-6 Astra yazısında. Bu sayfada gereken tek Astra rakamı, 1.542 Elo çubuğu.
Hangi iş yükü Grok 4.6'dan çıkmalı
Kısa yapılandırılmış çağrılar kalabilir. Terminal, elektrik ve hukuk ajanı işleri taşınmalı.
Fable, CursorBench 4.0'da hâlâ 5,5 puan önde: %51,8'e karşı %46,3. HealthBench Professional'da Fable %62,1, Sol %60,5, Grok 4.7 ise %56,7. “Her şeyi değiştirin” bu yüzden yanlış sıra.
| İş böyle görünüyorsa | Kalsın | Grok 4.7'ye ne zaman |
|---|---|---|
| Yukarıdaki dört prompt gibi kısa, puanlı bir işlem | Halihazırda bağlı model | Tek şikâyet completion token faturasıysa. Bizimki high'da %29,2 düştü |
| Terminal-Bench 4.0 biçiminde kabuk işi | Gereksinim %57,9 ise Fable 5.1 | Grok 4.6'nın %20,3 skorundan çıkıyorsanız ve %38,0 ile yaşayabiliyorsanız |
| EEBench biçiminde devre ve birim işi | Bu tabloda %64,0'ı geçen yok | Bu tabloda her zaman |
| Harvey biçiminde hukuk ajanı döngüsü | Bu tabloda %19,6'yı geçen yok | Bu tabloda her zaman. Sözleşmeye %80,4 ıskalama oranını yazın |
| Çok saatlik belgeler, AA Briefcase | Fable, 1.678 ile 21 Elo önde | Output fiyatı baskınsa: $6, Fable'ın $50'sine karşı |
| Editör işleri, CursorBench 4.0 | Fable, %51,8 | 5,5 puanlık fark, 8,3 kat output tarifesinden ucuz |
| Klinik maddeler, HealthBench Professional | Fable veya Sol | Skor için geçmeyin. %56,7 ikisinin de gerisinde |
Fable'ın $50 output tarifesi, Grok'un $6'sının 8,3 katı. Satır ürünün kendisiyse bu katı ödeyin. Aynı seçim, router yapılandırması olarak model yönlendirme rehberinde. Harvey bu tabloda %19,6 ile lider ve kümenin %80,4'ünü hâlâ ıskalıyor.
Bu ölçümün söyleyemediği şey
Dört prompt, her biri tek deneme. CursorBench 4.0 veya 7 dakikalık bir ofis görevi hakkında bir şey söylemiyor.
- Temperature 0'dı,
max_tokens4000 olarak ayarlıydı, araçlar kapalıydı ve yeniden deneme yoktu. 78,30 saniyelik çağrıda ikinci bir deneme sıradan çıkabilirdi. - Fable 5.1, GPT-5.6 Sol ve GPT-6 Astra çağrılmadı. Hücreler xAI'dan ve Artificial Analysis'ten alıntı.
- 1.036 token'lık prompt farkı bir muhasebe olgusu. Yanıt bu token'ları adlandırmıyor. Fatura, liste fiyatı olan $0.002072 tutarını eklemedi.
- Artificial Analysis kazancın yanında gerileme de kaydetmiş: AA-LCR 3,7 puan düşmüş, AutomationBench-AA 1,1 puan düşmüş, AA-Briefcase sunum kalitesi 1.519 Elo'dan 1.499 Elo'ya inmiş.
- AA-Omniscience doğruluğu Grok 4.7 için %47, Grok 4.6 high için %48. Aynı kümede halüsinasyon oranı %34'ten %29'a inmiş.
4.7'yi, satırı hareket etmiş ve mutlak oranı bir müşterinin adının yanına koyabildiğiniz yere alın. Klinik maddeleri Fable veya Sol'da bırakın. Puanlı bir görev yanıtını değiştirene kadar xhigh'ı kapalı tutun. Bu dört görev yanıtı değiştirmedi.
Sık sorulan sorular
Grok 4.7'nin bilgi kesim tarihi nedir?
docs.x.ai kesimi Mayıs 2026 diye tarihlendiriyor. 21 Eylül sürümü ağırlıklarda yok. Web araması ve X araması aynı sayfada ayrı araçlar. İkisi de kapalı bir istek Mayıs 2026'dan cevap verir. Olgu bundan yeniyse kaynağı prompt'a yazın.
ABD endpoint'i token fiyatını değiştiriyor mu?
ABD bölgesel taban URL'si https://us.api.x.ai/v1. docs.x.ai buna %10 prim koyuyor, inference ABD'de kalsın diye. $6'lık bir output token orada $6.60 oluyor, $2'lik bir input token $2.20. Model kimliği yine grok-4.7. 200.000 token uçurumu ve cache'lenmiş input tarifesi bu primin üstüne de biniyor.
API görsel kabul ediyor mu?
Evet. Model sayfası metin ve görsel girdisi, yalnız metin çıktısı, 500.000 token bağlam ve metin çıktısında tavan olmadığını yazıyor. Kabul edilen dosyalar jpg veya png, her biri en fazla 20 MiB, sayıda yazılı bir tavan yok. Gelen yanıt metin. Görsel üretim Imagine modellerinde ve onların kendi fiyat listesinde kalıyor.
Grok 4.7 Fast gerçekte nerede çalışıyor?
Fast, aynı ağırlıkların daha hızlı makinelerde ve iki kat token tarifesiyle çalışması demek. Standart kartın dışında fiyat $4 input ve $12 output. docs.x.ai bunu Cursor ve Grok Build'de satıyor, Grok Build ücretsiz katmanının dışında bırakıyor. Herkese açık API listede yok. API trafiği, uçurum dahil, $2 ve $6'da kalıyor.
SDK hangi model dizesini göndermeli?
xAI API'de dize grok-4.7. OpenRouter'da 22 Eylül 2026'da x-ai/grok-4.7 çağırdık. reasoning.effort için low, medium, high veya xhigh verin. Belgelerdeki varsayılan high. Turuncu sütun xhigh. Alanı boş bırakan istemci o sütun değil.