Grok 4.7 vs Grok 4.6: stessi $2/$6, e il tabellone si divide per lavoro
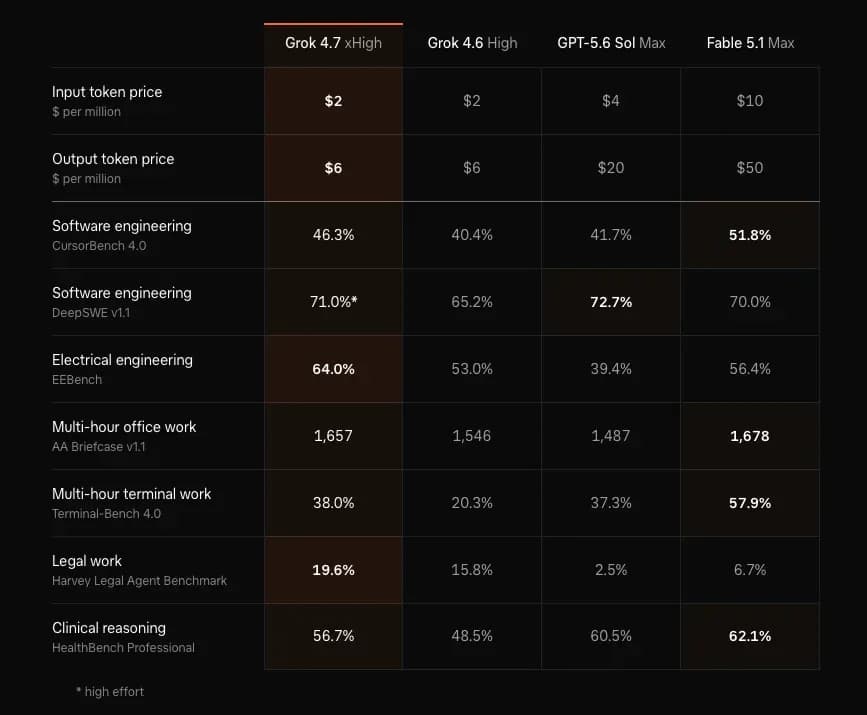
Grok 4.7 è uscito il 21 settembre 2026 a $2 per milione di token di input e $6 per milione di token di output, lo stesso cartellino di Grok 4.6. Il tabellone di SpaceXAI dà a 4.7 ogni riga contro 4.6, e su quelle sette righe 4.7 ne perde quattro contro Fable 5.1 Max. Abbiamo salvato entrambi i grafici dalla pagina di lancio e mandato 12 chiamate valutate tramite OpenRouter il 22 settembre, dalle 14:51 alle 14:53 UTC.
Dove Grok 4.7 batte davvero Grok 4.6
Manda su Grok 4.7 il lavoro elettrico, l'agente legale e il terminale, e lascia le voci cliniche su Fable 5.1 o GPT-5.6 Sol.
Ogni cifra nella colonna di chi sta in testa viene dal post di lancio del 21 settembre, recuperato il 22 settembre 2026. L'ultima riga è nostra.
| Carico | Leader della riga | Grok 4.7 | Scelta |
|---|---|---|---|
| EEBench | Grok 4.7 xHigh | 64,0% | Grok 4.7 |
| Agente legale Harvey | Grok 4.7 xHigh | 19,6% | Grok 4.7, e di' all'utente che l'80,4% fallisce ancora |
| Terminal-Bench 4.0 | Fable 5.1 Max, 57,9% | 38,0% | 4.7 se lasci 4.6; Fable se il punteggio è il prodotto |
| CursorBench 4.0 | Fable 5.1 Max, 51,8% | 46,3% | Fable, a meno che un output a $6 non valga più di un distacco di 5,5 punti |
| DeepSWE v1.1 | GPT-5.6 Sol Max, 72,7% | 71,0% a high, non a xHigh | Sol, o 4.7 se 1,7 punti non valgono un output a $20 |
| AA Briefcase v1.1 | Fable 5.1 Max, 1.678 | 1.657 | Fable per 21 Elo, o 4.7 quando pesa di più il conto dell'output |
| HealthBench Professional | Fable 5.1 Max, 62,1% | 56,7% | Fable o Sol (60,5%), non 4.7 |
| Quattro chiamate brevi, nostre | Pareggio | 4/4 | Tieni il client che hai già |
Grok 4.6 High sta sotto 4.7 su tutte e sette le righe pubblicate. È l'intero argomento per l'upgrade rispetto al modello che già fai girare. Non regge come argomento per l'upgrade contro Fable sui compiti da editor, sul lavoro d'ufficio, sul terminale o sulle voci cliniche.
Cosa contano i due grafici di SpaceXAI
La colonna arancione è xHigh, il default dell'API è high, e DeepSWE segna il 71,0% come high.
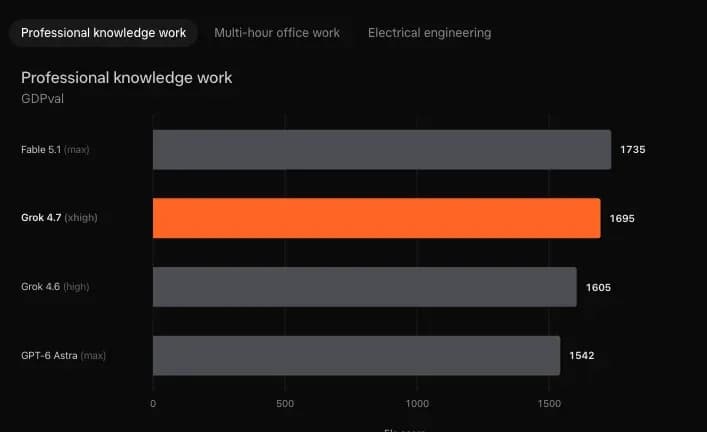
GDPval mette Fable 5.1 max a 1.735 Elo, Grok 4.7 xhigh a 1.695, Grok 4.6 high a 1.605 e GPT-6 Astra max a 1.542. Sono +90 Elo su 4.6, 40 Elo dietro Fable e 153 Elo davanti ad Astra. Su questo grafico il nome OpenAI è Astra. Sul tabellone il nome OpenAI è GPT-5.6 Sol Max. Sono modelli diversi, e la pagina di lancio li usa entrambi.
- Leggi la colonna arancione come xHigh. docs.x.ai imposta l'effort di default su high.
- Leggi il 71,0% come high. L'asterisco sta su quella cella di DeepSWE e su nessun'altra cella di Grok 4.7.
- Tieni 1.542 di Astra sul grafico Elo. Non incollarlo nella colonna di Sol.
Artificial Analysis separa il guadagno sul lavoro d'ufficio. Su AA-Briefcase la qualità analitica è passata da 1.690 Elo su Grok 4.6 high a 1.994 su Grok 4.7. La qualità di presentazione è passata da 1.519 a 1.499. I documenti sono diventati più precisi nell'analisi e un po' peggiori come documenti.
CursorBench è la suite di Cursor. SpaceX ha accettato di acquistare Anysphere, l'azienda dietro Cursor, per $60B in azioni il 16 giugno 2026.
Grok 4.7 è sull'API come grok-4.7, in Cursor e come modello di default in Grok Build. Se cerchi «grok 4.7 cos'è», la risposta è quell'id, non una data di uscita. Il pezzo del 12 agosto su Grok 4.6 vs Grok 4.5 diceva che 4.7 non era ancora uscito. Quella frase era vera il 12 agosto. Dal 21 settembre non lo è più.
Cosa $2 e $6 lasciano fuori dal cartellino
Un prompt da 250.000 token lo paghi a $4 e $12, e quella tariffa vale per ogni token della richiesta.
Il grafico stampa $2 e $6. La pagina dei modelli ne stampa due righe. Sotto i 200.000 token di prompt le tariffe sono $2 di input, $0.50 di input in cache e $6 di output. Da 200.000 in su, l'intera richiesta passa a $4, $1 e $12.
prompt, output = 250_000, 2_000
chart_rate = prompt / 1e6 * 2 + output / 1e6 * 6     # $0.512
cliff_rate = prompt / 1e6 * 4 + output / 1e6 * 12    # $1.024
Oltrepassare la linea raddoppia un conto che il grafico non mostra. $0.512 diventa $1.024. I token sotto i 200.000 non restano alla tariffa bassa.
L'input a $2 è la metà dei $4 di GPT-5.6 Sol e un quinto dei $10 di Fable 5.1. L'output a $6 costa 3,3× meno dei $20 di Sol e 8,3× meno dei $50 di Fable. Per ogni dollaro di output sono 166.667 token su Grok, 50.000 su Sol e 20.000 su Fable. «Metà del prezzo» combacia con la riga di input contro Sol. Non combacia con nessuna delle due righe di output.
L'input in cache resta a $0.50 per milione sotto i 200.000 token, la stessa cifra di Grok 4.6, poi $1 sulla soglia. Come quella riga di cache finisce su una fattura vera è il tema della guida ai costi di inferenza.
Grok 4.7 Fast è un interruttore a parte: il doppio della velocità in output al doppio del prezzo per token, dentro Cursor e Grok Build. Non è la soglia dei 200.000 token, e l'API pubblica non lo vende.
Artificial Analysis ha cronometrato i prompt lunghi a circa 188 token al secondo e circa 7,1 minuti per task dell'Intelligence Index. La mediana delle nostre chiamate brevi è stata di 5,02 secondi per Grok 4.7 high, contro 8,12 secondi per Grok 4.6 high. Nessuna delle due cifre sostiene una velocità 2× contro Fable o Sol.
Cosa hanno restituito 12 chiamate a Grok 4.7 il 22 settembre
Dodici chiamate hanno chiuso 12/12, e xhigh ha restituito le stesse quattro risposte di high.
Gli stessi quattro prompt, temperatura 0, max_tokens 4000, una prova per ciascuno, senza tool. Grok 4.6 a high, Grok 4.7 a high, Grok 4.7 a xhigh. Il gateway era OpenRouter, la stessa configurazione del nostro confronto tra LLM gateway. Gli oggetti usage grezzi stanno in benchmark-raw.json, accanto a questo post. Il usage.cost di OpenRouter per le dodici chiamate sommava $0.029279.
{
  "model": "x-ai/grok-4.7",
  "temperature": 0,
  "max_tokens": 4000,
  "reasoning": {"effort": "xhigh"},
  "messages": [{"role": "user", "content": "..."}]
}| Compito | Atteso | 4.6 high | 4.7 high | 4.7 xhigh |
|---|---|---|---|---|
| Mediana di 3, 1, 4, 1, 5, 9 | 3,5 | 3,5; 6,17 s; 348 tok | 3,5; 5,42 s; 359 tok | 3,5; 4,67 s; 300 tok |
| 2,2 kΩ a 5 mA | 11 V | 11; 8,06 s; 511 tok | 11; 4,62 s; 273 tok | 11; 5,31 s; 348 tok |
| Ritenta 429 e 503, mai 500 | 429,503 | 429,503; 78,30 s; 451 tok | 429,503; 3,37 s; 216 tok | 429,503; 2,07 s; 87 tok |
count_passed([59, 60, 100, 0]) con il ciclo che parte dall'indice 1 | 2 | 2; 8,18 s; 466 tok | 2; 6,10 s; 409 tok | 2; 5,16 s; 368 tok |
I token di completamento sono scesi da 1.776 su Grok 4.6 high a 1.257 su Grok 4.7 high, e a 1.103 con xhigh. I token di reasoning, inclusi in quei conteggi di completamento, erano 1.543, poi 1.052, poi 944. La fattura OpenRouter si è mossa con loro: $0.012258, poi $0.008877, poi $0.008144. A high sono il 29,2% di token di completamento in meno, e un conto più basso del 27,6%, su un test chiuso 4/4 da entrambi i modelli.
prompt_tokens su Grok 4.7 è più alto di 1.036 token esatti rispetto alla chiamata abbinata di Grok 4.6 a high: 1.311 contro 275, 1.288 contro 252, 1.295 contro 259, 1.339 contro 303. xhigh ne ha aggiunto uno in più a ogni chiamata. A $2 per milione, 1.036 token valgono $0.002072. La voce mediana ha fatturato $0.002446 su 4.6 e $0.002438 su 4.7 high, quindi quel divario non è arrivato in fattura. I quattro conti di Grok 4.6 combaciano con $2 e $6 sui conteggi restituiti. Non c'è una riga per quel migliaio in più.
La prova da 78,30 secondi è un prompt, un tentativo. Grok 4.7 high ha risposto a quello stesso prompt, quello su 429 e 503, in 3,37 secondi, xhigh in 2,07 secondi, tutti e tre con 429,503. La latenza mediana sui quattro prompt è stata 8,12 s, 5,02 s e 4,92 s. Non trasformare la singola prova lenta in un rapporto di velocità.
Sul lavoro lungo il quadro dei token si ribalta. Artificial Analysis ha riportato circa 81.000 token di output per task dell'Intelligence Index per Grok 4.7 a xhigh, contro circa 36.000 per Grok 4.6 a high. La nostra mediana da 316 token descrive quattro risposte brevi. Non descrive un compito AA Briefcase da più ore.
Da dove arriva il 38% sul terminale
Tre cifre pubblicate di Terminal-Bench 4.0 non vanno d'accordo: 38,0%, 33% e un aumento di 4,5 punti.
- La tabella di lancio di xAI, lo screenshot qui sopra: Grok 4.7 xHigh 38,0%, Grok 4.6 High 20,3%, GPT-5.6 Sol Max 37,3%, Fable 5.1 Max 57,9%. Contro 4.6 fa 1,87×, cioè +17,7 punti. Contro Sol fa +0,7 punti. Fable è avanti di 19,9 punti.
- Artificial Analysis, con Grok Build come agente, 21 settembre 2026: Terminal-Bench 4.0 dal 18% al 33%, e DeepSWE v1.1 dal 65% al 73%. Il Coding Agent Index è passato da 47 a 56 ed è arrivato quarto, dietro Fable 5.1, GPT-6 Astra e Claude Opus 5.
- L'Intelligence Index dello stesso laboratorio, lo stesso runner per ogni modello: Terminal-Bench 4.0 su di 4,5 punti, e l'indice su di 2 punti, a 46. AA-LCR è sceso di 3,7 punti. AutomationBench-AA è sceso di 1,1 punti.
xAI non nomina l'agente dietro il 38,0%. Per il budget prendi la cifra del client che fai girare. La recensione di Fable 5.1 registra il 55,8% di Fable su Terminal-Bench 4.0, contro il 57,9% su questo tabellone. Il Coding Agent Index di Astra sta nel pezzo su GPT-6 Astra. A questa pagina basta la barra da 1.542 Elo.
Quale carico deve lasciare Grok 4.6
Lascia le chiamate strutturate e brevi dove sono, e sposta terminale, elettricità e agente legale.
Fable è ancora avanti su CursorBench 4.0 di 5,5 punti, 51,8% contro 46,3%. HealthBench Professional tiene ancora Fable al 62,1% e Sol al 60,5%, con Grok 4.7 al 56,7%. Queste due righe spiegano perché «sposta tutto» è l'ordine sbagliato.
| Se il lavoro assomiglia a questo | Tieni | Passa a Grok 4.7 quando |
|---|---|---|
| Una trasformazione breve e valutata, come i quattro prompt sopra | Il modello già collegato | Il conto dei token di completamento è l'unica cosa che non ti torna. Il nostro è sceso del 29,2% a high |
| Lavoro di shell nella forma di Terminal-Bench 4.0 | Fable 5.1, se il 57,9% è il requisito | Lasci il 20,3% di Grok 4.6 e ti basta il 38,0% |
| Circuiti e unità nella forma di EEBench | Nessuno su questo tabellone batte il 64,0% | Sempre, su questa tabella |
| Un ciclo da agente legale nella forma di Harvey | Nessuno su questo tabellone batte il 19,6% | Sempre su questa tabella, con il tasso di fallimento dell'80,4% nel contratto |
| Documenti da più ore, AA Briefcase | Fable, 21 Elo avanti a 1.678 | Il prezzo dell'output pesa di più: $6 contro i $50 di Fable |
| Compiti da editor, CursorBench 4.0 | Fable al 51,8% | Un distacco di 5,5 punti costa meno di una tariffa di output 8,3× |
| Voci cliniche, HealthBench Professional | Fable o Sol | Non spostare per il punteggio. Il 56,7% sta dietro a entrambi |
La tariffa di output di Fable, $50, è 8,3× i $6 di Grok. Paga quel multiplo quando la riga è il prodotto. La stessa scelta, scritta come config di un router, sta nella guida al routing dei modelli. Il 19,6% di Harvey guida questo tabellone e manca comunque l'80,4% del set.
Cosa questa misura non può dirti
Quattro prompt, una prova ciascuno, non dicono nulla su CursorBench 4.0 né su un compito d'ufficio da 7 minuti.
- La temperatura era 0,
max_tokensera 4000, i tool erano spenti e non abbiamo ritentato nulla. Una seconda prova sulla chiamata da 78,30 secondi poteva essere ordinaria. - Fable 5.1, GPT-5.6 Sol e GPT-6 Astra non li abbiamo chiamati. Le loro celle le citiamo da xAI e da Artificial Analysis.
- Il divario di 1.036 token nel prompt è un fatto contabile. La risposta non dice a cosa corrispondono quei token, e la fattura non ha aggiunto il valore di listino di $0.002072.
- Artificial Analysis ha registrato anche regressioni: AA-LCR giù di 3,7 punti, AutomationBench-AA giù di 1,1, qualità di presentazione su AA-Briefcase giù da 1.519 Elo a 1.499.
- L'accuratezza di AA-Omniscience era il 47% per Grok 4.7, contro il 48% per Grok 4.6 high. Il tasso di allucinazione su quel set è sceso dal 34% al 29%.
Manda in produzione 4.7 dove la riga si è mossa e la tariffa assoluta può stare accanto al nome di un cliente. Lascia le voci cliniche su Fable o su Sol. Tieni xhigh spento finché un compito valutato non cambia la risposta. Questi quattro non l'hanno cambiata.
Domande frequenti
Qual è il cutoff di conoscenza di Grok 4.7?
docs.x.ai data il cutoff a maggio 2026. Questo rilascio del 21 settembre non è nei pesi. La ricerca sul web e la ricerca su X sono tool separati, sulla stessa pagina. Una richiesta senza quei tool risponde da maggio 2026. Passa la fonte nel prompt quando il fatto è più recente di quella data.
L'endpoint USA cambia il prezzo per token?
L'URL base della regione USA è https://us.api.x.ai/v1. docs.x.ai lo prezza con un sovrapprezzo del 10%, così l'inferenza resta negli Stati Uniti. Un token di output da $6 diventa $6.60, e un token di input da $2 diventa $2.20. L'id del modello resta grok-4.7. La soglia dei 200.000 token e la tariffa dell'input in cache si applicano ancora, sopra quel sovrapprezzo.
L'API accetta un'immagine?
Sì. La pagina del modello elenca input di testo e di immagine, con output solo testo, una finestra di contesto da 500.000 token e nessun tetto sull'output di testo. Le immagini accettate sono jpg o png, fino a 20 MiB l'una, senza un tetto dichiarato sul numero. La risposta è testo. La generazione di immagini resta sui modelli Imagine e sul loro listino.
Dove gira davvero Grok 4.7 Fast?
Fast ha gli stessi pesi su macchine più veloci, al doppio delle tariffe per token: $4 di input e $12 di output, fuori dal cartellino standard. docs.x.ai lo vende in Cursor e in Grok Build, e lo lascia fuori dal piano gratuito di Grok Build. L'API pubblica non lo elenca. Il traffico sull'API resta a $2 e $6, soglia compresa.
Quale stringa di modello deve mandare l'SDK?
Sull'API di xAI la stringa è grok-4.7. Su OpenRouter noi abbiamo chiamato x-ai/grok-4.7 il 22 settembre 2026. Imposta reasoning.effort su low, medium, high o xhigh. High è il default documentato. La colonna arancione è xhigh, quindi un client che omette il campo non sta su quella colonna.