Grok 4.7 vs Grok 4.6: hetzelfde $2/$6, en het scorebord splijt per taak
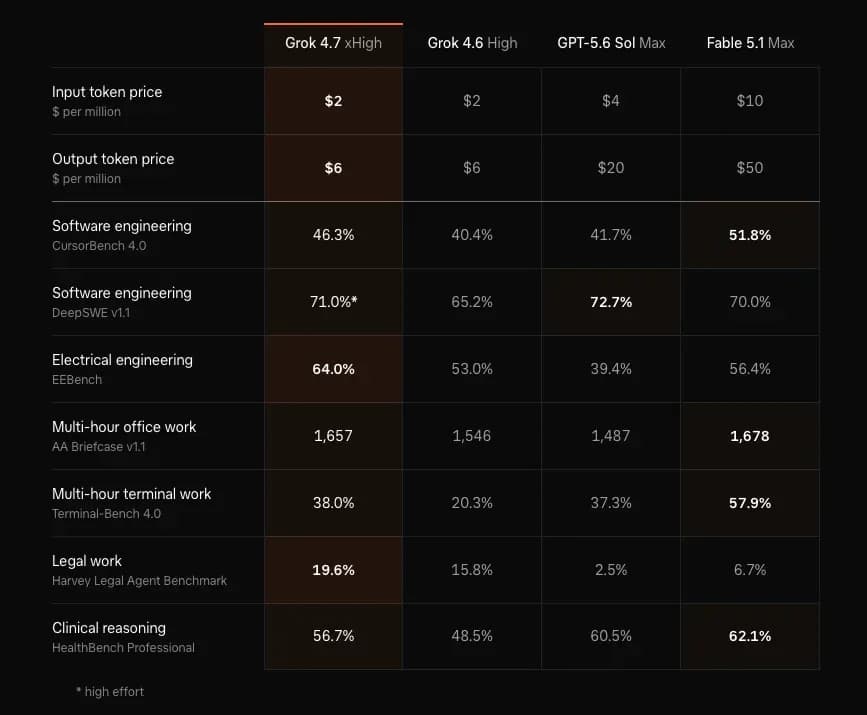
Grok 4.7 kwam op 21 september 2026 uit, op $2 per miljoen inputtokens en $6 per miljoen output, dezelfde kaart als Grok 4.6. Het eigen scorebord van SpaceXAI zet 4.7 op elke rij boven 4.6, en verliest daarna vier van die zeven rijen aan Fable 5.1 Max. We sloegen beide grafieken van de lanceerpagina op en stuurden 12 beoordeelde calls via OpenRouter op 22 september, van 14:51 tot 14:53 UTC.
Waar Grok 4.7 echt wint van Grok 4.6
Stuur elektrotechnisch werk, juridisch agentwerk en terminalwerk naar Grok 4.7, en laat klinische opgaven bij Fable 5.1 of GPT-5.6 Sol.
Elk cijfer in de leiderkolom komt uit het lanceerbericht van 21 september, opgehaald op 22 september 2026. De laatste rij is van ons.
| Werk | Leider op die rij | Grok 4.7 | Route |
|---|---|---|---|
| EEBench | Grok 4.7 xHigh | 64,0% | Grok 4.7 |
| Juridische agent van Harvey | Grok 4.7 xHigh | 19,6% | Grok 4.7, en vertel de gebruiker dat 80,4% van de set nog steeds misgaat |
| Terminal-Bench 4.0 | Fable 5.1 Max, 57,9% | 38,0% | 4.7 als je 4.6 verlaat; Fable als de score het product is |
| CursorBench 4.0 | Fable 5.1 Max, 51,8% | 46,3% | Fable, tenzij output van $6 een gat van 5,5 punt verslaat |
| DeepSWE v1.1 | GPT-5.6 Sol Max, 72,7% | 71,0% op high, niet xHigh | Sol, of 4.7 als 1,7 punt geen output van $20 waard is |
| AA Briefcase v1.1 | Fable 5.1 Max, 1.678 | 1.657 | Fable met 21 Elo voor, of 4.7 als de outputrekening de doorslag geeft |
| HealthBench Professional | Fable 5.1 Max, 62,1% | 56,7% | Fable of Sol (60,5%), niet 4.7 |
| Vier korte calls, van ons | Gelijkspel | 4/4 | Houd de client die je al hebt |
Grok 4.6 High staat op alle zeven gepubliceerde rijen onder 4.7. Dat is alles wat de overstap rechtvaardigt tegenover het model dat je al draait. Tegenover Fable rechtvaardigt het geen overstap op editortaken, kantoorwerk, terminalwerk of klinische opgaven.
Wat de twee grafieken van SpaceXAI tellen
De oranje kolom is xHigh, de API-standaard is high en de 71,0% van DeepSWE is als high gemarkeerd.
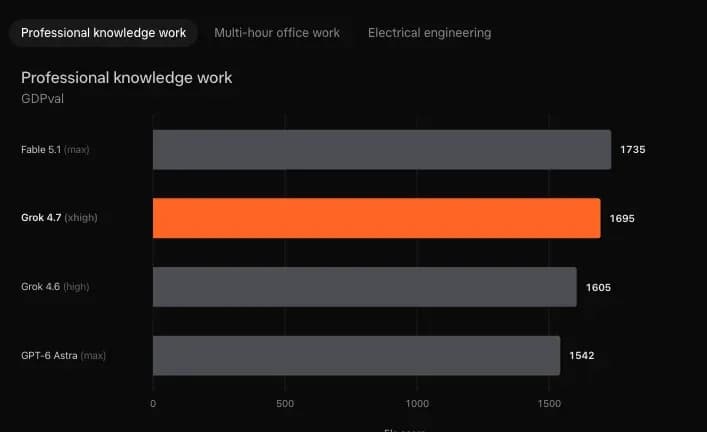
GDPval zet Fable 5.1 max op 1.735 Elo, Grok 4.7 xhigh op 1.695, Grok 4.6 high op 1.605 en GPT-6 Astra max op 1.542. Dat is +90 Elo op 4.6, 40 Elo achter Fable en 153 Elo voor op Astra. De OpenAI-naam op deze grafiek is Astra. De OpenAI-naam op het scorebord is GPT-5.6 Sol Max. Het zijn verschillende modellen, en de lanceerpagina gebruikt beide.
- Lees de oranje kolom als xHigh. docs.x.ai zet de standaard-effort op high.
- Lees 71,0% als high effort. Het sterretje staat op die DeepSWE-cel en op geen andere cel van Grok 4.7.
- Houd de 1.542 van Astra op de Elo-grafiek. Plak die niet in de kolom van Sol.
Artificial Analysis splijt de winst op kantoorwerk. Op AA-Briefcase ging de analytische kwaliteit van 1.690 Elo op Grok 4.6 high naar 1.994 op Grok 4.7. De presentatiekwaliteit ging van 1.519 naar 1.499. De documenten werden scherper in de analyse en iets slechter als documenten.
CursorBench is de suite van Cursor. SpaceX ging ermee akkoord de maker van Cursor, Anysphere, over te nemen voor $60 miljard in aandelen op 16 juni 2026.
Grok 4.7 staat op de API als grok-4.7, in Cursor en als het standaardmodel in Grok Build. Het stuk van 12 augustus over Grok 4.6 vs Grok 4.5 zei dat 4.7 nog niet was uitgebracht. Die zin klopte op 12 augustus. Op 21 september klopte hij niet meer.
Wat $2 en $6 buiten de kaart laten
Een prompt van 250.000 tokens wordt afgerekend tegen $4 en $12, op elke token in het verzoek.
De grafiek drukt $2 en $6 af. De modelpagina drukt twee rijen af. Onder 200.000 prompttokens zijn de tarieven $2 input, $0.50 gecachte input en $6 output. Bij 200.000 of meer wordt het hele verzoek herprijsd naar $4, $1 en $12.
prompt, output = 250_000, 2_000
chart_rate = prompt / 1e6 * 2 + output / 1e6 * 6     # $0.512
cliff_rate = prompt / 1e6 * 4 + output / 1e6 * 12    # $1.024
Overschrijd je de lijn, dan verdubbelt een rekening die de grafiek nooit toont. $0.512 wordt $1.024. De tokens onder 200.000 houden het goedkope tarief niet.
Input op $2 is de helft van de $4 van GPT-5.6 Sol en een vijfde van de $10 van Fable 5.1. Output op $6 is 3,3× goedkoper dan de $20 van Sol en 8,3× goedkoper dan de $50 van Fable. Per outputdollar is dat 166.667 tokens op Grok, 50.000 op Sol en 20.000 op Fable. "De helft van de prijs" klopt met de inputrij tegen Sol. Met geen van beide outputrijen klopt het.
Gecachte input blijft $0.50 per miljoen onder 200.000 tokens, hetzelfde cijfer als bij Grok 4.6, daarna $1 op de klif. Hoe die cacheregel op een echte factuur landt, staat in de gids voor inferencekosten.
Grok 4.7 Fast is een aparte schakelaar: twee keer de outputsnelheid tegen twee keer de tokenprijs, binnen Cursor en Grok Build. Het is niet de klif van 200.000 tokens, en de publieke API verkoopt het niet.
Artificial Analysis klokte lange prompts op ongeveer 188 tokens per seconde en ongeveer 7,1 minuten per taak op de Intelligence Index. Onze mediaan voor korte calls was 5,02 seconden voor Grok 4.7 high tegen 8,12 seconden voor Grok 4.6 high. Geen van beide cijfers is een reële 2×-snelheidsclaim tegen Fable of Sol.
Wat 12 calls van Grok 4.7 op 22 september teruggaven
Twaalf calls scoorden 12/12, en xhigh gaf dezelfde vier antwoorden terug als high.
Dezelfde vier prompts, temperature 0, max_tokens 4000, één proef per stuk, geen tools. Grok 4.6 op high, Grok 4.7 op high, Grok 4.7 op xhigh. De gateway was OpenRouter, dezelfde opzet als in onze vergelijking van LLM-gateways. Ruwe usage-objecten staan in benchmark-raw.json naast dit stuk. De usage.cost van OpenRouter voor de twaalf calls telde op tot $0.029279.
{
  "model": "x-ai/grok-4.7",
  "temperature": 0,
  "max_tokens": 4000,
  "reasoning": {"effort": "xhigh"},
  "messages": [{"role": "user", "content": "..."}]
}| Taak | Verwacht | 4.6 high | 4.7 high | 4.7 xhigh |
|---|---|---|---|---|
| Mediaan van 3, 1, 4, 1, 5, 9 | 3,5 | 3,5; 6,17 s; 348 tok | 3,5; 5,42 s; 359 tok | 3,5; 4,67 s; 300 tok |
| 2,2 kΩ bij 5 mA | 11 V | 11; 8,06 s; 511 tok | 11; 4,62 s; 273 tok | 11; 5,31 s; 348 tok |
| Opnieuw proberen bij 429 en 503, nooit bij 500 | 429,503 | 429,503; 78,30 s; 451 tok | 429,503; 3,37 s; 216 tok | 429,503; 2,07 s; 87 tok |
count_passed([59, 60, 100, 0]) met de lus die op index 1 start | 2 | 2; 8,18 s; 466 tok | 2; 6,10 s; 409 tok | 2; 5,16 s; 368 tok |
Completion-tokens daalden van 1.776 op Grok 4.6 high naar 1.257 op Grok 4.7 high en 1.103 op xhigh. Reasoning-tokens, meegeteld in die completion-aantallen, waren 1.543, daarna 1.052, daarna 944. De factuur van OpenRouter bewoog mee: $0.012258, daarna $0.008877, daarna $0.008144. Dat is 29,2% minder completion-tokens op high en een 27,6% lagere rekening, op een test die beide modellen met 4/4 afrondden.
prompt_tokens op Grok 4.7 lag exact 1.036 boven de gematchte call van Grok 4.6 op high: 1.311 tegen 275, 1.288 tegen 252, 1.295 tegen 259 en 1.339 tegen 303. Op xhigh kwam er op elke call nog één bij. Tegen $2 per miljoen zijn 1.036 tokens $0.002072. Het mediane item rekende $0.002446 op 4.6 en $0.002438 op 4.7 high, dus het gat kwam niet op de factuur. De vier rekeningen van Grok 4.6 kloppen wel met $2 en $6 op de teruggegeven aantallen. Er is geen factuurregel voor die extra duizend.
De proef van 78,30 seconden is één prompt, één poging. Grok 4.7 high beantwoordde diezelfde prompt voor de retry-set in 3,37 seconden, xhigh in 2,07 seconden, alle drie met 429,503. De mediane latency over de vier prompts was 8,12 s, 5,02 s en 4,92 s. Maak van die ene trage proef geen snelheidsverhouding.
Bij lang werk draait het tokenplaatje om. Artificial Analysis meldde ongeveer 81.000 outputtokens per taak op de Intelligence Index voor Grok 4.7 op xhigh, tegen ongeveer 36.000 voor Grok 4.6 op high. Onze mediaan van 316 tokens beschrijft vier korte antwoorden. Die beschrijft geen briefcase van meerdere uren.
Waar de terminalscore van 38% vandaan komt
Drie gepubliceerde cijfers voor Terminal-Bench 4.0 spreken elkaar tegen: 38,0%, 33% en een stijging van 4,5 punt.
- De lanceertabel van xAI, de schermafbeelding hierboven: Grok 4.7 xHigh 38,0%, Grok 4.6 High 20,3%, GPT-5.6 Sol Max 37,3%, Fable 5.1 Max 57,9%. Tegen 4.6 is dat 1,87×, of +17,7 punten. Tegen Sol is het +0,7 punt. Fable leidt met 19,9 punten.
- Artificial Analysis, met Grok Build als agent, 21 september 2026: Terminal-Bench 4.0 van 18% naar 33%, en DeepSWE v1.1 van 65% naar 73%. Hun Coding Agent Index ging van 47 naar 56 en eindigde als vierde, achter Fable 5.1, GPT-6 Astra en Claude Opus 5.
- De Intelligence Index van hetzelfde lab, één gedeelde runner voor elk model: Terminal-Bench 4.0 met 4,5 punten omhoog, en de index met 2 punten omhoog naar 46. AA-LCR daalde 3,7 punten. AutomationBench-AA daalde 1,1 punt.
xAI noemt de agent achter de 38,0% niet. Reken met het cijfer dat bij je client past. De bespreking van Fable 5.1 noteert 55,8% voor Fable op Terminal-Bench 4.0, tegen 57,9% op dit bord. De codingindex van Astra hoort in het GPT-6 Astra-stuk. Deze pagina heeft alleen de balk van 1.542 Elo nodig.
Welk werk moet weg bij Grok 4.6
Korte gestructureerde calls kunnen blijven. Terminalwerk, elektrotechnisch werk en juridisch agentwerk moeten overstappen.
Fable leidt CursorBench 4.0 nog met 5,5 punt, 51,8% tegen 46,3%. HealthBench Professional heeft Fable nog op 62,1% en Sol op 60,5%, met Grok 4.7 op 56,7%. Die twee rijen zijn waarom "alles omzetten" de verkeerde volgorde is.
| Als de taak er zo uitziet | Houden | Naar Grok 4.7 als |
|---|---|---|
| Een korte beoordeelde transformatie, zoals de vier prompts hierboven | Het model dat al is aangesloten | De rekening voor completion-tokens is de enige klacht. Die van ons daalde 29,2% op high |
| Shellwerk in de vorm van Terminal-Bench 4.0 | Fable 5.1, als 57,9% de eis is | Je verlaat de 20,3% van Grok 4.6 en kunt leven met 38,0% |
| Circuit- en eenhedenwerk in de vorm van EEBench | Niemand op dit bord verslaat 64,0% | Altijd, op deze tabel |
| Een lus van een juridische agent in de vorm van Harvey | Niemand op dit bord verslaat 19,6% | Altijd op deze tabel, met het mispercentage van 80,4% in het contract |
| Documenten van meerdere uren, AA Briefcase | Fable, 21 Elo voor op 1.678 | De outputprijs geeft de doorslag: $6 tegen de $50 van Fable |
| Editortaken, CursorBench 4.0 | Fable op 51,8% | Een gat van 5,5 punt is goedkoper dan een outputtarief van 8,3× |
| Klinische opgaven, HealthBench Professional | Fable of Sol | Verhuis niet voor de score. 56,7% blijft achter op beide |
Het outputtarief van $50 bij Fable is 8,3× de $6 van Grok. Betaal dat veelvoud als de rij het product is. Dezelfde keuze, geschreven als routerconfig, staat in de gids voor modelroutering. De 19,6% van Harvey leidt dit bord en mist nog steeds 80,4% van de set.
Wat deze meting je niet vertelt
Vier prompts, één proef per stuk, zeggen niets over CursorBench 4.0 of een kantoortaak van 7 minuten.
- temperature stond op 0,
max_tokensstond op 4000, tools stonden uit en er werd niets opnieuw geprobeerd. Een tweede proef op de call van 78,30 seconden had heel gewoon kunnen zijn. - Fable 5.1, GPT-5.6 Sol en GPT-6 Astra zijn niet aangeroepen. Hun cellen zijn geciteerd uit xAI en uit Artificial Analysis.
- Het promptgat van 1.036 tokens is een boekhoudfeit. Niets in het antwoord noemt die tokens, en de factuur telde de cataloguswaarde van $0.002072 niet op.
- Artificial Analysis noteerde dalingen naast de winst: AA-LCR 3,7 punten omlaag, AutomationBench-AA 1,1 punt omlaag en de presentatiekwaliteit op AA-Briefcase van 1.519 Elo naar 1.499.
- De nauwkeurigheid op AA-Omniscience was 47% voor Grok 4.7 tegen 48% voor Grok 4.6 high. Het hallucinatiepercentage op die set daalde van 34% naar 29%.
Zet 4.7 in waar de rij bewoog en het absolute cijfer naast de naam van een klant kan staan. Laat klinische opgaven op Fable of Sol. Laat xhigh uit tot een beoordeelde taak het antwoord verandert. Deze vier deden dat niet.
Veelgestelde vragen
Wat is de knowledge cutoff van Grok 4.7?
docs.x.ai zet de knowledge cutoff op mei 2026. Deze release van 21 september zit niet in de gewichten. Zoeken op het web en zoeken op X zijn aparte tools op diezelfde pagina. Een verzoek zonder die tools antwoordt vanuit mei 2026. Geef de bron mee in de prompt als het feit nieuwer is dan dat.
Verandert het Amerikaanse endpoint de tokenprijs?
De regionale basis-URL voor de VS is https://us.api.x.ai/v1. docs.x.ai rekent er een premie van 10% op, zodat inference in de Verenigde Staten blijft. Een outputtoken van $6 wordt daar $6.60, en een inputtoken van $2 wordt $2.20. De model-id blijft grok-4.7. De klif van 200.000 tokens en het tarief voor gecachte input gelden nog steeds bovenop die premie.
Kan de API een afbeelding als input nemen?
Ja. De modelpagina noemt tekst- en afbeeldingsinput met alleen tekst als output, een contextvenster van 500.000 tokens en geen limiet op tekstoutput. Toegelaten afbeeldingen zijn jpg of png, tot 20 MiB per stuk, zonder genoemde limiet op het aantal. Het antwoord is tekst. Het genereren van afbeeldingen blijft bij de Imagine-modellen en hun eigen prijslijst.
Waar draait Grok 4.7 Fast echt?
Fast is dezelfde set gewichten op snellere machines, tegen twee keer de tokentarieven: $4 input en $12 output, los van de standaardkaart. docs.x.ai verkoopt het in Cursor en Grok Build. Het zit niet in de gratis laag van Grok Build. De publieke API vermeldt het niet. API-verkeer blijft op $2 en $6, klif inbegrepen.
Welke modelstring moet de SDK sturen?
Op de xAI-API is de string grok-4.7. Op OpenRouter riepen we x-ai/grok-4.7 aan op 22 september 2026. Zet reasoning.effort op low, medium, high of xhigh. High is de gedocumenteerde standaard. De oranje kolom is xhigh, dus een client die het veld weglaat is die kolom niet.