Claude Sonnet 5.5: Samme $2/$10, men de 30 prosentene spares bare på lange jobber
Anthropic ga ut Claude Sonnet 5.5 28. september 2026 til nøyaktig samme pris som Sonnet 5: $2 per million input-tokens og $10 per million output. Dagen etter sendte vi 19 vurderte kall gjennom OpenRouter. På en lang HTML-fil falt regningen med 11.1%. På en liten fakturasum steg den med 12.8%.
Samme pris. Ulik regning.
Hva endret seg da Claude Sonnet 5.5 kom 28. september?
Bytter du modell-id til claude-sonnet-5-5, ligger prisen per token fast på $2 input og $10 output.
Anthropics prisside fører Sonnet 5.5 og Sonnet 5 på identiske rader, med cache og batch, så all kostnadsforskjell mellom dem er antall tokens.
| Punkt | Sonnet 5.5 ved lansering |
|---|---|
| API-modell-id | claude-sonnet-5-5 |
| Input / output, per 1M tokens | $2 / $10 |
| Cache read / cache write | $0.20 / $2.50 (5 min), $4 (1 time) |
| Batch input / output | $1 / $5 |
| Kontekst / maks output | 1M / 128K tokens |
| Standard effort | Medium i Claude Code og appene, High på API-et |
| Tilgjengelighet | Zero data retention; AWS, Google Cloud, Microsoft Azure |
| GitHub Copilot | Pro, Pro+, Max, Business, Enterprise, til listepris |
Kilder: Anthropics modellside for Sonnet 5.5, lanseringsinnlegg og GitHubs changelog. Bakgrunn: hva Sonnet 5 endret og priser per token hos ulike leverandører. Prisene er i USD; regn om selv, og husk 25 % mva hvis du kjøper som norsk virksomhet.
Hvor nær kommer Sonnet 5.5 Opus 5.5 på Anthropics tabell?
Sonnet 5.5 ligger under tre poeng bak Opus 5.5 på fire av seks prosentrader, og den ene seieren ligger innenfor feilmarginen.
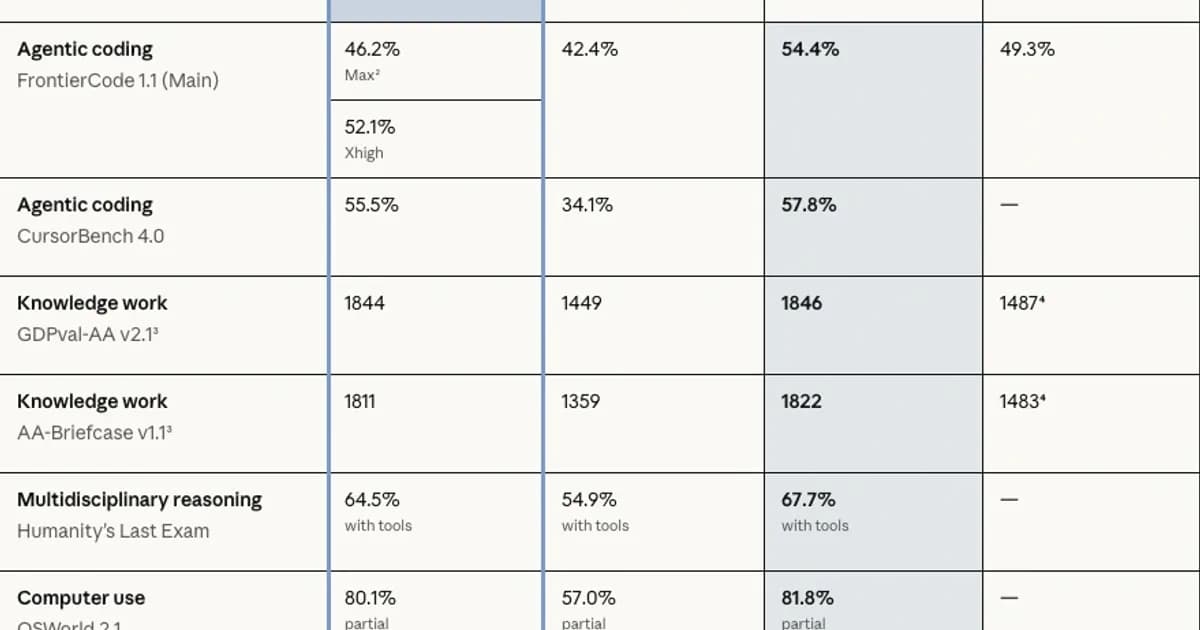
Cellene er skrevet av på nytt fra hero-bildet:
| Benchmark | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 10.3% | 66.4%¹ | n/a |
| FrontierCode 1.1 Main | 46.2% (Max)², 52.1% (Xhigh) | 42.4% | 54.4% | 49.3% |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% | n/a |
| GDPval-AA v2.1³ | 1844 | 1449 | 1846 | 1487⁴ |
| AA-Briefcase v1.1³ | 1811 | 1359 | 1822 | 1483⁴ |
| HLE (with tools) | 64.5% | 54.9% | 67.7% | n/a |
| OSWorld 2.1 (partial) | 80.1% | 57.0% | 81.8% | n/a |
| Chartography (no tools) | 61.6% | 15.6% | 64.4% | 53.6%⁴ |
¹ Opus på Xhigh effort. ² Max skåret lavere enn Xhigh: den kjørte flere code-review-subagenter, som ifølge Cognition ga timeouts eller redigeringer utenfor oppgaven i to tilfeller. ³ Kjørt av Artificial Analysis på en pre-release-deployment med en structured-output-feil, senere rettet. ⁴ En bildefeil i GPT-6 Sol er kanskje ikke reflektert. Anthropics diagrammer for Terminal-Bench og CursorBench viser GPT-5.6 Sol.
FrontierCode (Xhigh) og CursorBench ligger 2.3 bak, OSWorld 1.7, Chartography 2.8. HLE er unntaket med 3.2. Elo-radene ligger 2 og 11 fra hverandre.
Terminal-Bench-raden mater r/ClaudeCode-tråden «Sonnet 5.5 beats Opus 5.5 at coding and it's half the price??». System card oppgir standardfeil på ±2.5 og ±2.6 poeng, så gapet på 4.2 poeng er omtrent 1.2 samlede standardfeil, og Sonnet kjørte på max mens Opus kjørte på xhigh. Artificial Analysis målte Sonnet 5.5 til 64% på samme test. Opus' største ledelse står ikke på lanseringssiden: SWE-Bench Pro, 81.3 mot 89.9.
GPT-6 Sol er bare kolonnen Anthropic trykket. Hvordan GPT-6 Astra står mot Opus 5.5, finner du i vår tredelte test.
Overlever Anthropics 30 prosent 19 API-kall?
Bare på den lange jobben: 11.1% billigere på en HTML-oppgave med i snitt 2,564 output-tokens, og 10-13% dyrere på to bittesmå oppgaver.
- september klokka 14:25 UTC sendte vi 19 vurderte kall gjennom OpenRouter til Sonnet 5.5 og Sonnet 5: 3 oppgaver, 3 forsøk, 2 modeller, pluss ett ekstra kall med høy effort. Total regning: $0.183434. Alle 18 sammenlignbare kall besto.
# sonnet55_bench.py, 29 Sep 2026, POST https://openrouter.ai/api/v1/chat/completions
body = {
    "model": model,        # anthropic/claude-sonnet-5.5 or anthropic/claude-sonnet-5
    "messages": messages,
    "max_tokens": max_tokens,         # 12000 on the HTML task
    "reasoning": {"effort": effort},  # low: invoice, merge_intervals; medium: HTML
}
Ingen LLM vurderte noe. Fakturaen (800k cache-read, 200k input, 50k output tokens) måtte gi nøyaktig 1.06, merge_intervals kjørte 6 assert-er, og HTML-en krevde doctype, canvas, requestAnimationFrame og ingen eksternt script. Kostnadene er usage.cost summert over 3 forsøk.
| Oppgave (effort) | Sonnet 5.5 | Sonnet 5 | Delta | Snitt output-tokens | Snitt latens |
|---|---|---|---|---|---|
| Invoice (low) | $0.002754 | $0.002442 | +12.8% | 71 / 61 | 2.63 s / 4.49 s |
| merge_intervals (low) | $0.006054 | $0.005502 | +10.0% | 172 / 154 | 3.06 s / 3.68 s |
| 150-bird HTML (medium) | $0.077508 | $0.087156 | -11.1% | 2,564 / 2,886 | 15.54 s / 21.61 s |
| Sammenlignbar sum | $0.086316 | $0.0951 | -9.2% | n/a | n/a |
Anthropic lover «opptil 30 % lavere kostnad per oppgave enn forgjengeren». Matthias Bastian i The Decoder la til det riktige forbeholdet: «Independent testing still needs to confirm these claims.»
I vår måling med 19 kall på low og medium effort, med én lang oppgave, var besparelsen -11.1% på HTML-en, mens den snudde til +12.8% og +10.0% på de små oppgavene. Samme listepris betyr at hver besparelse er et antall tokens, og på våre to minste oppgaver skrev Sonnet 5.5 flere tokens, ikke færre.
Farten holdt bedre. HTML-latensen falt 28.1 %, og gjennomstrømmingen økte fra 133.5 til 165.0 tokens per sekund (+23.6%): riktig retning, litt under 30. Sonnet 5 logget også 54-63 reasoning-tokens per invoice-kall, mens Sonnet 5.5 logget 0 på alle 10 kall.
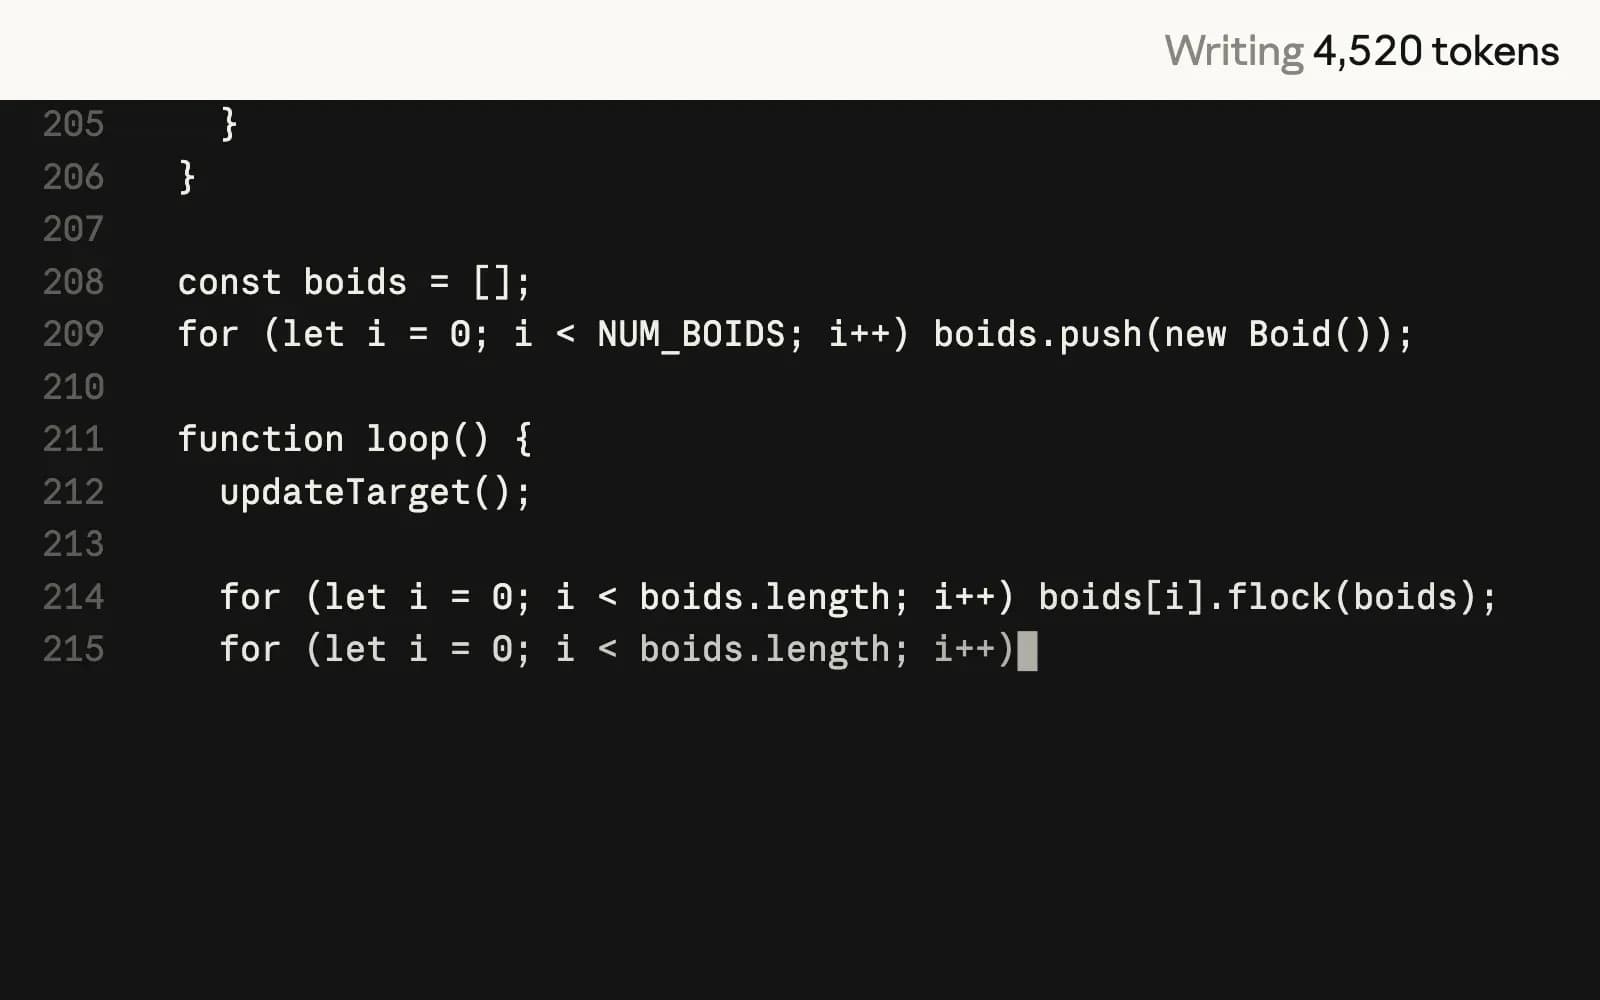
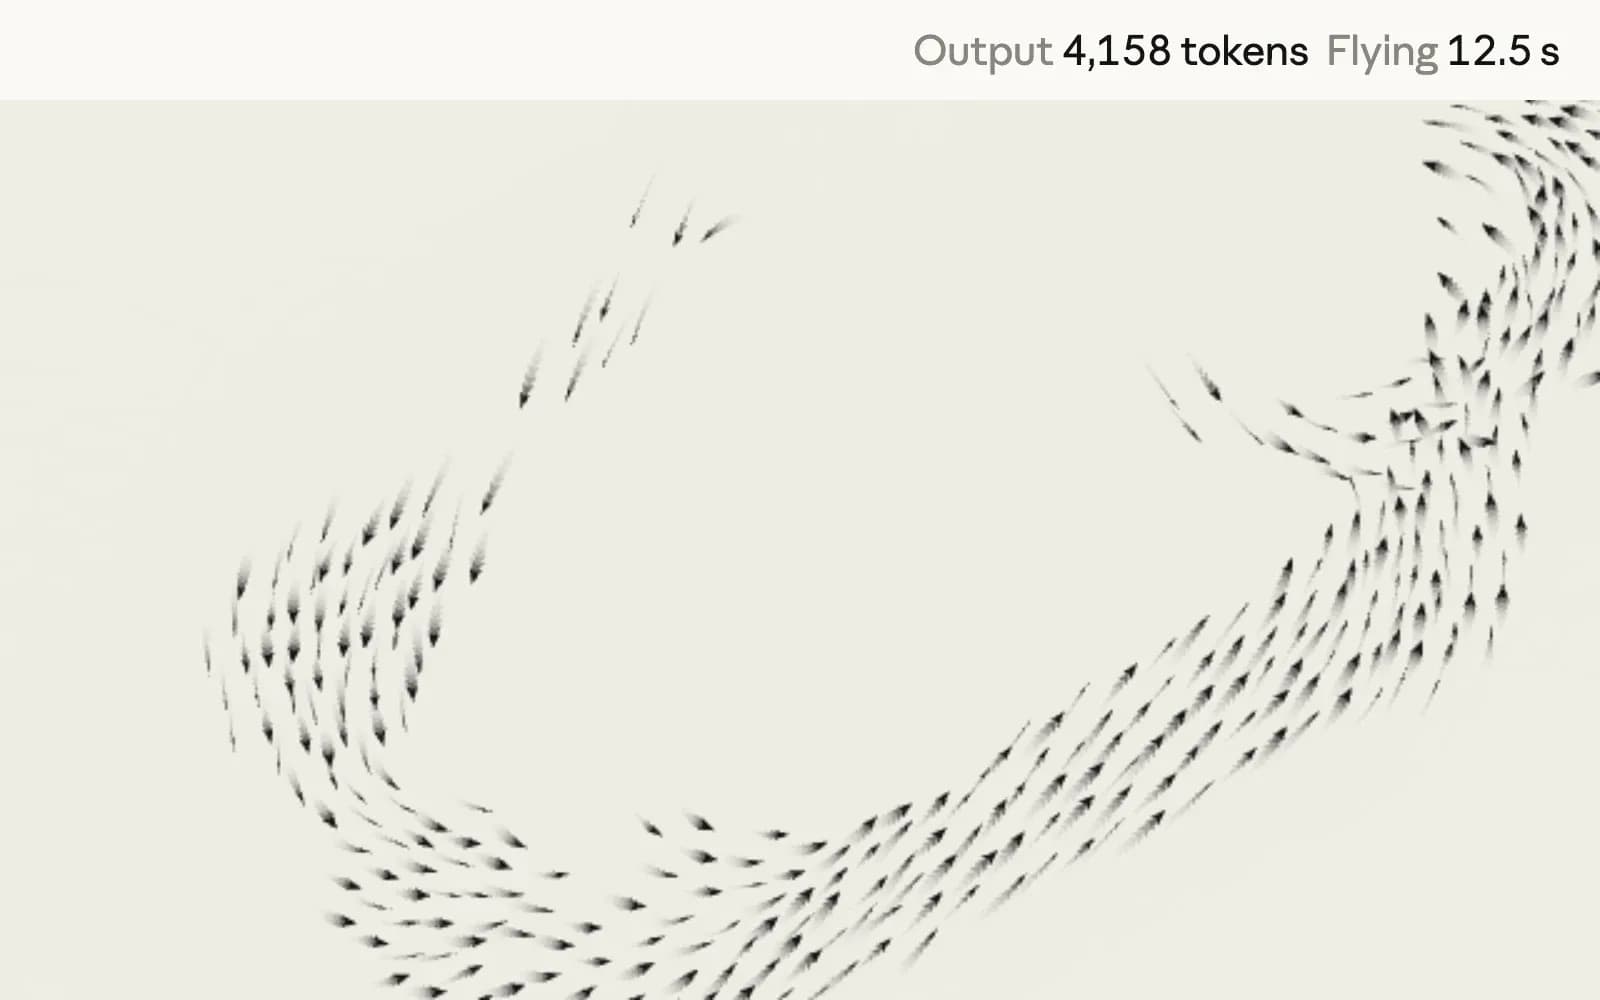
HTML-oppgaven er en 150-fugls versjon av Anthropics demo-prompt med 400 stær fra lanseringssiden. Bildene under er Anthropics opptak, ikke vår kjøring.
Hva Anthropics lanseringstestere rapporterte
«Without changing any of our prompts, Claude Sonnet 5.5 did better than Sonnet 5 on almost all of our offline Slackbot evals, in fewer steps and with about 14% fewer output tokens.» Curtis Allen, Principal Engineer, Slack
«The new model managed tens of thousands of lines of code for gameplay system architecture, kept responses snappy, handled multi-hour tasks, and delivered with less prescriptive prompting.» Daniel Vogel, Chief Operating Officer, Epic Games
Begge er innsamlet av leverandøren, og begge beskriver lange arbeidsøkter med mange steg. Våre bittesmå oppgaver gikk motsatt vei.
Ikke målt: agentisk arbeid, benchmarkene over, cyber-fallbacken. 3 forsøk er en stikkprøve. Vil du kjøre din egen, les usage på hvert kall.
Hvorfor flytter effort-nivået regningen mer enn modellen?
Artificial Analysis målte $0.59 per oppgave på medium og $7.60 på max, et hopp på 13 ganger for 15 indekspoeng.
På max talte de «~193k Output Tokens per Intelligence Index Task. This is the highest token use we have measured».
| Effort | AA-kostnad per oppgave | AA Intelligence Index | AA-rangering, 29. sep |
|---|---|---|---|
| Low | $0.41 | 36 | 63 av 216 |
| Medium | $0.59 | 41 | 44 av 216 |
| High | $1.08 | 47 | 23 av 216 |
| Max | $7.60 | 56 | 3 av 216 |
Radene kommer fra AAs modellsider per effort, hentet 29. september. AAs lanseringsartikkel sa at Sonnet 5.5 tok andreplassen på indeksen. Modellsiden viste 56, rang 3 av 216, samme dag. Max kostet også «~50% higher than Sonnet 5's Cost per Task».
Vårt eget kall med høy effort ignorerte innstillingen: merge_intervals med effort=high kostet $0.002018 for 172 output-tokens, identisk med low. Effort biter først på arbeid som er stort nok til å tenke over, og det er der kutt i LLM API-kostnader starter.
Hva gir 400-feil etter at du har byttet modell-id?
Alle forespørsler med thinking slått av feiler; bytt til between_tools og hold effort på high eller lavere.
Anthropics migreringsguide skriver ut feilen:
# Before (Sonnet 5 habit): 400 invalid_request_error on claude-sonnet-5-5
thinking = {"type": "disabled"}
# '"thinking.type.disabled" is not supported for this model. Use
#  "thinking.type.between_tools" for the lowest thinking setting, ...'

# After: accepted at low / medium / high effort, 400 at xhigh / max
thinking = {"type": "between_tools"}
output_config = {"effort": "medium"} # fixed for the conversation under between_toolstool_choicemedanyellertoolgir 400. Brukautoplussstrict: true(maks 20 strict-verktøy), eller bareautopå Amazon Bedrock.- Thinking-blokker fra Opus 5, Opus 5.5, Fable eller Mythos droppes stille. Kontoer opprettet 31. august 2026 eller senere får 400 hvis du spiller av en blokk etter å ha redigert historikken. Mekanikken tilsvarer thinking-blokk-bindingen i Fable 5.1.
- Computer use krever
computer_toolset_20260801på Claude API og Google Cloud. - Avslag oppgir en
stop_details-kategori, blant annetcyber,frontier_llm(«could assist the development of competing AI models») ogreasoning_extraction. - Server-side fallback (
fallbacks: "default", beta, kun Claude API) prøvercyber- ogfrontier_llm-avslag på nytt med Sonnet 5. System card sier at 1.2% av Terminal-Bench-forespørslene falt tilbake. - Minste cachebare prompt synker til 512 tokens fra 1,024 (minstegrenser for prompt caching), og
/claude-api migratei Claude Code gjør disse endringene for deg.
Sikkerhetsteam treffer punkt 4 først. En HN-kommentator, johnmlussier, sa at han til tross for at han er med i Cyber Verification Program «can't use Opus 5.5 or Sonnet 5.5 for any authorized bounty work». Anthropic sier at det utvidede programmet kommer «Soon».
Samme sjekkliste sier «Re-run your effort sweep, and re-baseline cost». Gjør det før du stoler på de 30 prosentene.
Sonnet 5.5 eller Opus 5.5: hvem får standardplassen?
Velg Sonnet 5.5 som standard for avgrenset koding og kall i høyt volum, og behold Opus 5.5 til åpen vurdering og alt som kjører på max effort.
Sonnet står oppført til halvparten av Opus 5.5s $4/$20, men Artificial Analysis målte Sonnet på max til $7.60 per oppgave mot $5.98 for Opus 5.5, omtrent 27% mer.
| Signal | Sonnet 5.5 | Opus 5.5 | Heller mot |
|---|---|---|---|
| Input / output per 1M | $2 / $10 | $4 / $20 | Sonnet, halv pris |
| Cache read / 5-min write | $0.20 / $2.50 | $0.20 / $5 | Uavgjort på reads |
| Cache-tung miks (under) | $1.06 | $1.96 | Sonnet, 1.85x ikke 2x |
| AA-kostnad per oppgave, max effort | $7.60 | $5.98 | Opus, 27% billigere |
| SWE-Bench Pro | 81.3% | 89.9% | Opus med 8.6 poeng |
Mix: 800k cache-read + 200k input + 50k output tokens
Sonnet 5.5: 0.8 x $0.20 + 0.2 x $2 + 0.05 x $10 = $0.16 + $0.40 + $0.50 = $1.06
Opus 5.5:   0.8 x $0.20 + 0.2 x $4 + 0.05 x $20 = $0.16 + $0.80 + $1.00 = $1.96
Ratio: 1.96 / 1.06 = 1.85x
Aleksei Aleinikovs «approximately 1.65×» bygger på en miks han ikke oppgir. Sett inn din egen: jo større cache-andel, desto mindre er Sonnets forsprang.
Anthropic sier selv «Opus 5.5 remains clearly stronger at complex, open-ended work requiring sustained judgment.» En HN-kommentator, datadrivenangel, gikk lenger: «Opus 5.5 on Low seems smarter, cheaper, and faster than sonnet on medium». Ikke testet av oss. Pris og grenser for Opus finner du i vår gjennomgang av Opus 5.5.
Vårt standardvalg fra 29. september: claude-sonnet-5-5 på medium effort. Jobber på max effort går til Opus 5.5, for på max er Sonnet ikke lenger den billige modellen.
Ofte stilte spørsmål
Når kom Claude Sonnet 5.5?
Anthropic ga ut Claude Sonnet 5.5 28. september 2026 som claude-sonnet-5-5, samme dag på Amazon Web Services, Google Cloud, Microsoft Azure og GitHub Copilot. Ifølge Anthropics dokumentasjon blir den ikke pensjonert før 28. september 2027.
Er Claude Sonnet 5.5 billigere enn Sonnet 5?
Ikke per token: begge står til $2 input og $10 output. I vår måling kostet en lang HTML-oppgave 11.1% mindre på Sonnet 5.5 og en liten faktura-oppgave 12.8% mer. På max effort målte Artificial Analysis omtrent 50% mer per oppgave.
Kan jeg bruke Sonnet 5.5 i Claude Code og GitHub Copilot?
Ja. Claude Code setter den til Medium effort som standard, mens API-et bruker High. I GitHub Copilot, fra Pro til Enterprise, er den «billed at provider list pricing under usage-based billing». Vil du låse modellen, se hvordan du bytter modell i Claude Code.
Hvor stort er kontekstvinduet til Sonnet 5.5, og hva er kunnskapsgrensen?
Den tar 1M tokens kontekst og returnerer opptil 128K output-tokens, med en pålitelig kunnskapsgrense på juni 2026 ifølge system card.
Finnes det en Haiku 5.5?
Ikke per 29. september 2026. Anthropic sa 28. september at Claude Haiku 5.5 «will join the Claude 5.5 family in the coming weeks.»