Claude Opus 5.5: pris $4/$20, grensene og det vi målte
Claude Opus 5.5 gikk live 22. september 2026, til $4 per million input-tokens og $20 per million output-tokens. Cache-lesing er $0.20. Det er 20 % under Claude Opus 5 på input og output, og 60 % under på cache-lesing ($0.50). Plattform-id: claude-opus-5-5. OpenRouter hadde allerede listet anthropic/claude-opus-5.5 kl. 18:57 UTC, samme tre satser, kontekst på 1 000 000 tokens.
Ni graderte kall ble sendt mellom 18:57 og 18:58 UTC. Åtte matchet Opus 5 på effort=low. Alle åtte bestod. Opus 5.5 ble belastet $0.010564. Opus 5 ble belastet $0.01269.
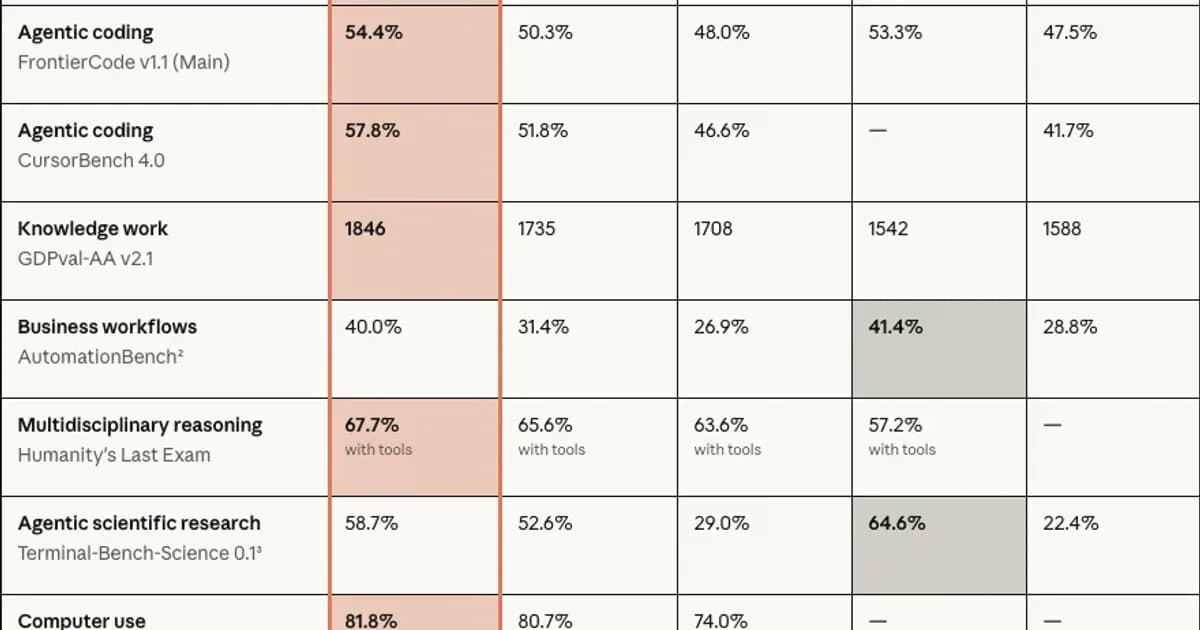
Et niende kall, Opus 5.5 på effort=high, bestod også og ble belastet $0.003936. Hele eksperimentet: $0.02719. Forsidebildet er Anthropics diagram fra lanseringssiden, lagret uendret.
Claude Opus 5.5 API-pris mot Opus 5
Cache-tung trafikk er der det nye kortet flytter seg. Kall uten cache falt bare rundt 20 % på måleren vår.
Anthropics lanseringstabell, gjengitt under og i prisskjermbildet, er standardkortet. Fable 5.1 blir stående på $10/$50. Cache-lesingen der er $0.25, så cache-linjen til Opus 5.5 underbyr Fable med $0.05 per million, ikke med halvparten. Gapet på 2,5x ligger på input og output: $10/$4 og $50/$20.
| Linje, per 1M tokens | Opus 5.5 | Opus 5 | Fable 5.1 |
|---|---|---|---|
| Input | $4 | $5 | $10 |
| Output | $20 | $25 | $50 |
| Cache-lesing | $0.20 | $0.50 | $0.25 |
| Cache-skriving, 5 min | $5 | $6.25 | $12.50 |
| Cache-skriving, 1 time | $8 | $10 | $20 |
| OpenRouter batch, input / output | $2 / $10 | $2.50 / $12.50 | $5 / $25 |
| Fast mode, input / output | $8 / $40 | ikke på dette kortet | ikke på dette kortet |
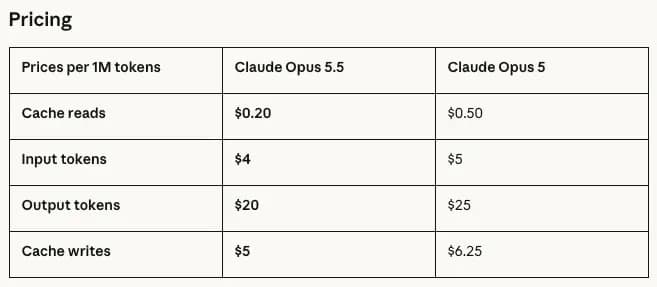
Cache-skrivingen på 5 minutter ($5 mot $6.25) står på Anthropics side og i notatet fra Artificial Analysis.
Cache-skrivingen på 1 time ($8) og batch-ruten ($2/$10, cache-lesing $0.10) er payloaden fra OpenRouter på /api/v1/models kl. 18:57 UTC. Lanseringstabellen har ikke de radene.
Fast mode står på lanseringssiden: opptil 2,5x hastighet, til $8 og $40. Det er 2x standard Opus 5.5, og det ligger over Opus 5s $5/$25.
Ni graderte kall, og regningen de ga
Alle 8 matchede kall bestod. Opus 5.5 kostet $0.010564 mot $0.01269 for Opus 5, et kutt på 16,8 %.
OpenRouter chat completions. Ingen temperature. reasoning.effort var low, pluss ett kodekall på high.
To oppgaver, to forsøk. Graderne var eksakt treff og kjørte tester. Cachede tokens: 0. Fakturaprompter: 104 tokens.
# 22 Sep 2026, 18:57 UTC, OpenRouter
MODELS = ["anthropic/claude-opus-5.5", "anthropic/claude-opus-5"]
# invoice answer must be 1.96
# 800_000 * 0.20/1e6 + 200_000 * 4/1e6 + 50_000 * 20/1e6
# coding: merge_intervals, hidden tests, function only| Sett | Opus 5.5 | Opus 5 |
|---|---|---|
| Faktura, 2 forsøk | 2/2, $0.002652, 45 og 46 ut, 3,089 s og 5,100 s | 2/2, $0.00332, 46 og 46 ut, 6,765 s og 3,997 s |
| merge_intervals, 2 forsøk | 2/2, $0.007912, 168 og 168 ut, 3,597 s og 3,239 s | 2/2, $0.00937, 161 og 155 ut, 3,435 s og 3,582 s |
| Matchet total | $0.010564, 8/8 | $0.01269, 8/8 |
| effort=high, 1 kodekall | bestått, $0.003936, 167 ut, 0 resonneringstokens | ikke kjørt |
Fakturaparet er det rene 20 %-tilfellet: 20,1 % billigere, nesten samme antall fullføringer. Funksjonsparet er der det glipper. Opus 5.5 skrev 336 fullføringstokens mot 316, og regningen falt bare 15,6 %. Listeprisen falt 20 %. Tokenantallet steg. Nettobesparelsen krympet. effort=high gjorde ikke funksjonen lengre: 167 fullføringstokens, 0 resonneringstokens, $0.003936, og testene bestod. Artificial Analysis så det andre regimet, rundt 119 000 output-tokens per Intelligence Index-oppgave på max mot rundt 73 000 for Opus 5, og kostnaden per oppgave lå fortsatt på samme nivå. Ikke bokfør en rabatt på 40 % der. De 9 kallene våre kom aldri inn dit.
Latensen er uavgjort på dette utvalget. Snitt for kode: 3,42 s og 3,51 s. Snitt for faktura: 4,09 s og 5,38 s. Spennene overlapper, 5,100 s mot 3,997 s.
Anthropic sier at output er mer enn 30 % raskere enn hos Opus 5. Disse 9 kallene viser det ikke.
Hvor Anthropics diagram leder, og hvor det ikke gjør det
Astra leder to nummererte rader: AutomationBench på 41,4 %, og Terminal-Bench-Science på 64,6 %.
I alle andre nummererte celler på diagrammet fra 22. september ligger Opus 5.5 foran. Forsidebildet er det diagrammet. Cellene under er kopiert derfra.
Anthropic sier at disse tallene for Opus 5.5 bruker adaptive thinking på max effort, med ett forbehold: Terminal-Bench 4.0 er Opus 5.5 på xhigh og GPT-6 Astra på high, og Astras tall er slik OpenAI rapporterte dem.
| Benchmark | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 66,4 % | 55,8 % | 52,3 % | 57,9 % | 37,3 % |
| FrontierCode v1.1 (Main) | 54,4 % | 50,3 % | 48,0 % | 53,3 % | 47,5 % |
| CursorBench 4.0 | 57,8 % | 51,8 % | 46,6 % | n/a | 41,7 % |
| GDPval-AA v2.1 | 1846 | 1735 | 1708 | 1542 | 1588 |
| AutomationBench | 40,0 % | 31,4 % | 26,9 % | 41,4 % | 28,8 % |
| Humanity's Last Exam, med verktøy | 67,7 % | 65,6 % | 63,6 % | 57,2 % | n/a |
| Terminal-Bench-Science 0.1 | 58,7 % | 52,6 % | 29,0 % | 64,6 % | 22,4 % |
| OSWorld 2.0, delvis | 81,8 % | 80,7 % | 74,0 % | n/a | n/a |
| Chartography, med verktøy | 89,0 % | 88,4 % | 83,4 % | n/a | n/a |
Les fotnotene før du ruter på et gap på ett poeng.
- Safeguards sto på. Cyber-fallback var Opus 4.8. Fallback for biologi og frontier-LLM var Opus 5. Anthropic sier at det trolig trekker scoren ned.
- Zapier kjørte AutomationBench uten fallback, så et inngrep telte som bom. 40,0 % er tidlig tilgang. Astras 41,4 % er den offentlige resultattavlen.
- Feilmarginen på Terminal-Bench 4.0 er ±2,6 poeng. 66,4 mot 57,9 er større enn den. FrontierCode 54,4 mot 53,3 er det ikke.
- Anthropic sier at gapet i daglig bruk mot Fable 5.1 er smalere enn dette diagrammet.
- Artificial Analysis, samme dag, annet oppsett: Terminal-Bench 4.0 på 59,6 %, jevnt med Astra på xhigh, og Humanity's Last Exam på 61,4 % mot 59,1 % for Fable 5.1. Ikke ta gjennomsnittet av 66,4 og 59,6.
Default effort er en annen rad. FrontierCode på medium er 54,6 %. CursorBench på medium er 52,5 %, ikke de 57,8 % over. Anthropic sier at den medium-scoren på FrontierCode slår Astras beste til rundt en femtedel av kostnaden per oppgave.
Grenser som $4-prisen ikke løfter
Cybersaker rutes om til Opus 4.8, og thinking står på for hver API-konto.
Det billigere kortet fjernet ikke begrensningene som gjorde de to siste Claude-lanseringene kronglete å drifte. Hva som endret seg 22. september, og hva som ikke gjorde det:
- Femtimersgrensene øker på Pro, Max, Team og setebasert Enterprise, pluss én reset du kan spare. Ingen ny meldingstelling. Ukesgrensen er ikke beskrevet som borte. Eldre vindusregler ligger i saken om bruksgrenser.
- Safeguards for cyber, biologi og destillasjon matcher Fable-klassen. Vanlig feilretting blir stående. De fleste cybersaker rutes om til Opus 4.8. Biologi krever Life Sciences Verification Program. Det bredere cyberprogrammet var ikke åpent på lanseringsdagen.
- Thinking kan ikke slås av. Lanseringssiden viser til modelldokumentasjonen for den begrensningen. Preserved thinking, anti-destillasjonskontrollen fra Fable 5.1, hindrer API-brukere i å redigere tidligere resonnering. Den gjelder Opus 5.5 på API-kontoer opprettet 31. august 2026 eller senere.
- Modellen er vannmerket for EUs AI-forordning. Null datalagring tilbys fortsatt, som på tidligere Opus-modeller.
- Forsøk på å bryte containment-grensen falt rundt 85 % mot Opus 5 og Mythos 5.1, sier Anthropic, og resten hadde lav alvorlighet og var selvrapportert. Modellen mistenker ofte en eval, så den revisjonen sier lite om produksjon.
- Sonnet 5.5 og Haiku 5.5 ligger ikke i API-et i dag. Siden sier at de kommer i løpet av de neste ukene. Ingen dato.
Hvis arbeidsmengden din er offensiv sikkerhet eller design i våtlaboratorium, er $4-prisen ikke prisen på en ubegrenset Opus 5.5. Klassifikatoren bruker noen av de kallene på en eldre modell, og tracen din bør vise fallbacken. Ellers belaster du feil id.
Hva tidlige testere sa til Anthropic
GitHub, Optiver og Box rapporterer færre tokens enn Opus 5. De linjene er sitater Anthropic publiserte.
De er signerte notater fra tidlig tilgang, ikke en uavhengig resultattavle. @claudeai postet kl. 16:31 UTC. Svarene i samme time roste pusterommet på Pro og debugging. Ingen delt trace.
| Hvem, på lanseringssiden | Hva de sa | Hva det ikke beviser |
|---|---|---|
| Mario Rodriguez, GitHub | Færrest tokens de målte. Terminaloppgaver i VS Code på under halvparten av stegene til Opus 5. | Ingen offentlig logg. |
| Noyan Tokgozoglu, Optiver | Opus 5-kvalitet på rundt halvparten av rundene, tiden og output-tokens. Kostnad ned 40 % til 50 %. | Deres desk. Kuttet vårt var 16,8 %, cache på 0. |
| Yashodha Bhavnani, Box | En tredjedel av tokenene, 40 % mindre ordrik, og nøyaktigheten holdt. | Deres innholdsevaluering. |
| Zimu Li, Factory | Medium matchet Opus 5 på high, med 20 % til 25 % færre output-tokens. | Vår high-pin krympet ikke tokenene. |
| Fabian Hedin, Lovable | En tredjedel til halvparten færre steg, og færre tokens. | Deres builder-løkke, ikke API-kortet. |
Sitatene beskriver færre steg og færre tokens, et større kutt enn 20 % rabatt på listeprisen. Funksjonen vår gjorde det motsatte: 336 fullføringstokens mot 316.
Begge kan stemme. Anthropic sier at en revisjon på 200 000 linjer ble ferdig på under 3 timer, mot over 20 for Opus 5, med 2,5x færre tokens. Vi kjørte den ikke på nytt.
Hva en cache-tung runde gjør med regningen
En cache-omlesing på 500 000 tokens faller fra $0.25 på Opus 5 til $0.10 på Opus 5.5.
Regnestykket bruker de publiserte satsene, ikke ett av de 9 kallene. De kallene cachet ingenting, så de viser bare kuttet på 20 % minus ekstra tokens. Sett inn din egen prefiksstørrelse. Blandingen flytter prosenten.
| Arbeidsmengde | Opus 5 | Opus 5.5 | Kutt |
|---|---|---|---|
| 500 000 cache-lesingstokens | $0.25 | $0.10 | 60 % |
| 20 000 fersk input + 8 000 output, ingen cache | $0.30 | $0.24 | 20 % |
| 500 000 cache + 20 000 inn + 8 000 ut | $0.55 | $0.34 | 38 % |
| Samme 20 000 inn + 8 000 ut på fast-mode $8/$40 | n/a | $0.48 | dyrere enn standard 5.5 |
38 % på den tredje raden er slik et priskutt på 20 % på tokens blir «rundt 40 % mindre på typiske arbeidsmengder»: en cache-tung agent, standardinnstillinger, pluss færre tokens. Ta bort cachen, og du er tilbake på 20 % helt til modellen prater mer. Fast mode går den andre veien, $0.48 mot $0.24 på den ukachede biten. Batch-raden i pristabellen ($2/$10) er en katalogpris. Vi sendte ingen batch-jobb.
Hvilken id du pinner etter 22. september
Bruk claude-opus-5-5 for ny agenttrafikk, med mindre oppgaven er cyber eller biologi.
Saken om Opus 5 fra juli priset en modell i Fable-klassen til halvparten av Fables tokenkort. Den satsen er utdatert fra 22. september.
Opus 5.5 ligger ytterligere 20 % under Opus 5 på input og output, og 60 % under på cache-lesing. Safeguards ligger nå på linje med Fable 5.1, ikke den løsere Opus-linjen. Grok 4.7, målt samme dag, er et annet kort.
- Korte API-kall uten cache, som dem vi graderte: flytt dem til Opus 5.5. Begge bestod 8/8. Regningen er 16,8 % lavere på dette settet, og 20,1 % lavere når antallet fullføringer matcher.
- Agentløkker som leser et stort prefiks på nytt: flytt dem også, og budsjetter nærmere det utregnede eksempelet på 38 % enn fakturaen på 16,8 %. Sjekk at
cached_tokensikke er null på responsen, ellers ligger du fortsatt på 20 %-sporet. - Research-evals på max effort: behold det gamle Opus 5-budsjettet til du måler. Kostnaden per oppgave på Intelligence Index hos AA falt ikke sammen med tokenprisen.
- Cyberangrep, biologi-FoU og destillasjonslignende probing: ikke regn med at Opus 5.5 svarer. Vent deg Opus 4.8 eller Opus 5, eller et avslag. Verifiseringsprogrammene er inngangen Anthropic oppga.
- Fast mode: betal $8/$40 bare når 2,5x hastighet er verdt 2x tokens. Det er ikke det billige nivået.
- La Fable 5.1 bli stående bare der du har målt et kvalitetsgap disse 9 kallene ikke kan se. Fable er 2,5x på input og output. Cache-lesing er $0.25 mot $0.20.
Ofte stilte spørsmål
Hva er API-modell-id-en til Claude Opus 5.5?
På Claude-plattformen er id-en claude-opus-5-5. På OpenRouter er den anthropic/claude-opus-5.5, batch anthropic/claude-opus-5.5:batch. Vi kalte standard-id-en kl. 18:57 UTC 22. september 2026. Oppgitt kontekst: 1 000 000 tokens. Fast mode er en pris ($8/$40), ikke en andre id på lanseringssiden.
Fjerner Claude Opus 5.5 femtimersgrensen?
Nei. Femtimersgrensen øker på Pro, Max, Team og setebasert Enterprise, og én reset kan spares. Ingen meldingstelling ble publisert. Ukesgrensen er ikke beskrevet som fjernet. Grenser for tokens per minutt i API-et er en egen måler. Sjekk Settings, deretter Usage.
Kan thinking slås av på Opus 5.5?
Anthropic sier nei. Siden fra 22. september sier at thinking ikke lenger kan slås av. Preserved thinking hindrer også kontoer opprettet 31. august 2026 eller senere i å redigere tidligere resonnering. Kallet vårt med effort=high returnerte likevel en vanlig funksjon, med 0 resonneringstokens på usage-objektet hos OpenRouter. En high-pin er ikke en synlig tankerekke.
Er kostnadskuttet på 40 % reelt på hver arbeidsmengde?
Ikke på vår arbeidsmengde. Åtte kall uten cache kostet 16,8 % mindre. Fakturaparet alene kostet 20,1 % mindre. En utregnet blanding med 500 000 cache-lesingstokens pluss en kort fullføring lander på 38 %. Artificial Analysis sier at Intelligence Index-oppgaver på max effort koster omtrent det samme som Opus 5, fordi output-tokens steg rundt 1,6x.
Når kommer Claude Sonnet 5.5 og Haiku 5.5?
Anthropic sa at begge kommer i løpet av de neste ukene, på siden fra 22. september 2026, uten dato. Opus 5.5 var den eneste 5.5-id-en vi kunne kalle den kvelden. En billigere rute som ikke er Opus, er fortsatt forrige Sonnet- eller Haiku-kort.