GPT-6 Astra vs Claude Opus 5.5 vs Grok 4.7: regning, GDPval og seks kall
GPT-6 Astra, Claude Opus 5.5 og Grok 4.7 var alle kallbare på OpenRouter kl. 22:34 UTC 22. september 2026. Seks graderte kall, to oppgaver, ett forsøk hver. Alle bestod. Gateway-regningen ble $0.01626.
Lanseringsdiagrammene ligger ikke på linje.
Anthropics tavle har Astra, men ikke Grok. xAIs tavle har Fable 5.1 og Sol, pluss Astra på ett Elo-diagram. Denne siden beholder de felles ankrene og stopper der linjalene deler seg.
Kuttet mellom Opus og Opus 5 blir stående i Opus 5.5-innlegget. Oppgraderingen fra 4.6 til 4.7 blir stående i Grok 4.7-innlegget. Astra mot Fable blir stående i GPT-6 Astra-innlegget.
GPT-6 Astra, Opus 5.5 og Grok: tre kort og promptstørrelsen
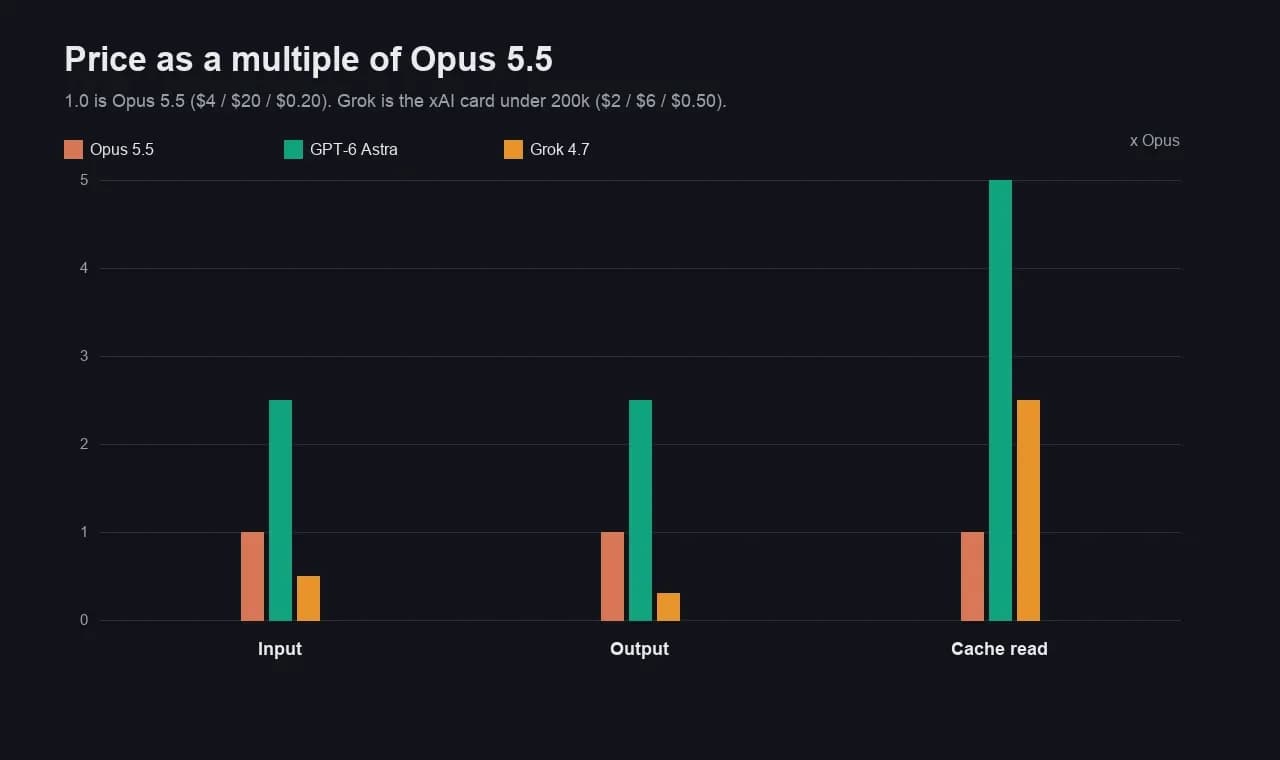
Astras token koster 2,5× Opus 5.5 på input og output, og 5× på cache-lesing. xAI-kortet til Grok er halvparten på input og 0,3× på output, helt til prompten krysser 200 000 tokens.
Opus 5.5 er linjen på 1,0: $4, $20 og $0.20 per million.
Modellkortet til Astra ligger på $10, $50 og $1.00. Kortet til Grok fra 21. september ligger på $2, $6 og $0.50 under 200 000 prompt-tokens.
| Linje, per 1M tokens, under knekken | Opus 5.5 | GPT-6 Astra | Grok 4.7, xAI-kort |
|---|---|---|---|
| Input | $4 | $10 | $2 |
| Output | $20 | $50 | $6 |
| Cache-lesing | $0.20 | $1.00 | $0.50 |
| Kontekst | 1 000 000 | 1 050 000 | 500 000 |
| Knekk | Ingen på dette kortet | 272 000 prompt-tokens: input og cache 2×, output 1,5× | 200 000 prompt-tokens: hele forespørselen går til $4 / $12 / $1 |
OpenRouter kl. 22:34 UTC matchet Opus og Astra. Grok gjorde det ikke.
Listingen lå på $1.60, $4.80 og $0.40, og deretter $3.20, $9.60 og $0.80 ved 200 000 prompt-tokens. Det er 0,8× xAI-kortet. Tallene våre i usage.cost bruker den katalogen. Grok 4.7-innlegget priser fortsatt xAIs eget kort til $2 og $6.
En cache-omlesing på 500 000 tokens, bare regnestykket: Opus $0.10, Astra $0.25, cache-linjen på xAI-kortet til Grok $0.25. Astra er dyr på cache, ikke på output. På output er gapet mellom Groks $6 og Astras $50 på 8,3×, og mot $20 hos Opus på 3,3×.
Seks graderte kall, og regningen hver modell faktisk sendte
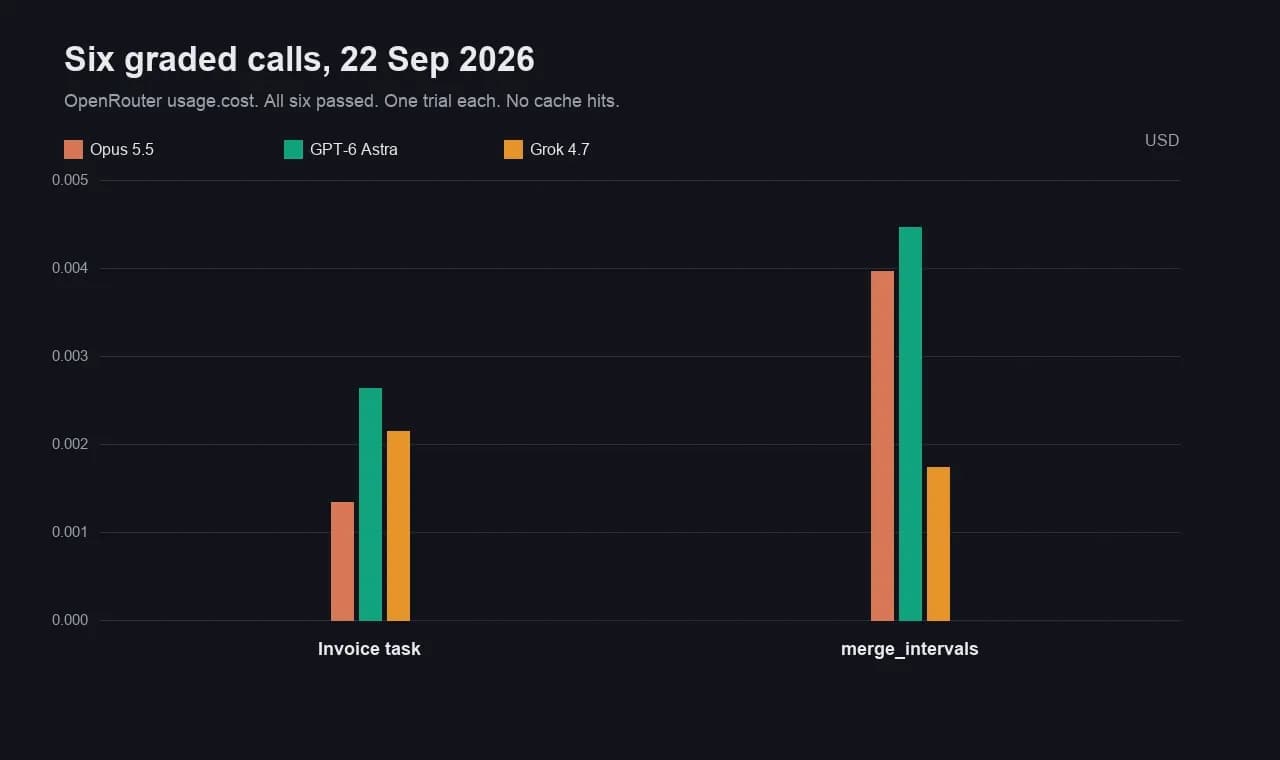
Alle seks bestod. Groks to kall kostet $0.0038784, Opus 5.5 kostet $0.005292, og Astra kostet $0.00709.
Svaret på fakturaen måtte være 1,96. merge_intervals måtte bestå skjulte tester, inkludert intervaller som ligger kant i kant.
Cachede tokens var 0 på Opus og Astra. Grok rapporterte 1 152 cachede tokens på begge kallene, innenfor prompter på 1 310 og 1 336 tokens. 295 av de 298 tokenene på fakturaen var resonnering.
# 22 Sep 2026, 22:34 UTC, OpenRouter, one trial, max_tokens 1800
MODELS = [
    "anthropic/claude-opus-5.5",
    "openai/gpt-6-astra",
    "x-ai/grok-4.7",
]| Oppgave | Opus 5.5 | GPT-6 Astra | Grok 4.7 |
|---|---|---|---|
| Faktura, må være 1,96 | bestått, $0.001336, 46 ut, 4,277 s | bestått, $0.00263, 38 ut, 2,116 s | bestått, $0.002144, 298 ut, 5,292 s |
| merge_intervals | bestått, $0.003956, 168 ut, 3,307 s | bestått, $0.00446, 69 ut, 2,588 s | bestått, $0.0017344, 204 ut, 4,217 s |
| Sum for to oppgaver | $0.005292 | $0.00709 | $0.0038784 |
Astra skrev færrest tokens og sendte den største regningen.
38 og 69 fullføringstokens, mot 46 og 168 hos Opus. Kortet på $10/$50 spiste besparelsen. De to tallene i usage.cost stemmer med $10 og $50 på øret. Opus stemmer med $4 og $20.
Grok tapte fakturaen og vant funksjonen. 204 tokens til $4.80 landet på $0.0017344.
Astra var raskest på begge kjøringene, 2,116 s og 2,588 s. Ett forsøk er ingen hastighetsrangering.
Astra-innlegget fra 4. september sa at openai/gpt-6-astra returnerte HTTP 400. Det stemte kl. 14:40 UTC den dagen. Det stemmer ikke for denne kjøringen. Id-en gikk gjennom, kallet returnerte 1,96, og testene bestod.
GDPval er raden begge labene faktisk deler
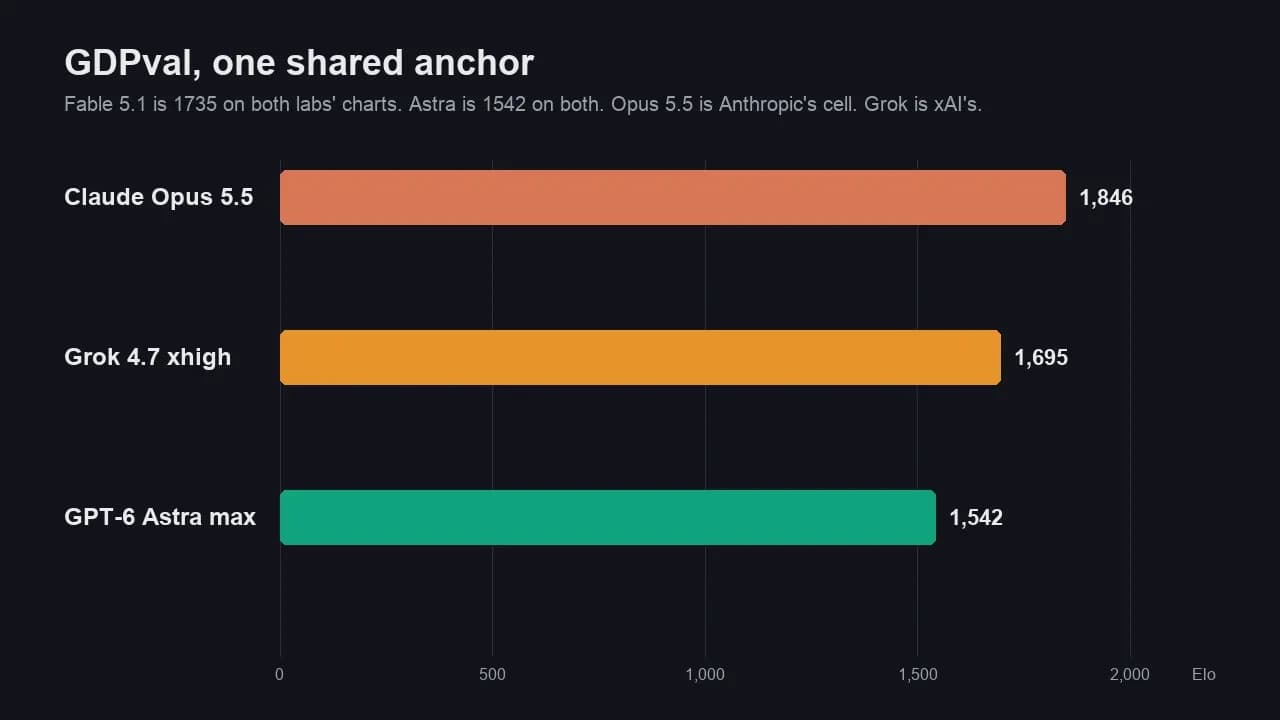
Opus 5.5 leder den delte raden med 1 846. Grok 4.7 xhigh ligger på 1 695. Astra max ligger på 1 542.
Fable 5.1 på 1 735 er ankeret, ikke et fjerdevalg.
Anthropic oppgir 1 735, Astra på 1 542 og Opus 5.5 på 1 846. xAI oppgir de samme 1 735 og 1 542, og Grok 4.7 xhigh på 1 695. To like tall er grunnen til at søylene står på samme akse.
| Celle | Score | Hvem som oppgav den |
|---|---|---|
| Claude Opus 5.5 | 1 846 | Anthropic, 22. september 2026, GDPval-AA v2.1 |
| Grok 4.7 xhigh | 1 695 | Lanseringsdiagrammet hos xAI, 21. september 2026, GDPval |
| GPT-6 Astra max | 1 542 | Begge diagrammene |
| Fable 5.1 max, bare anker | 1 735 | Begge diagrammene |
Opus ligger 151 Elo over Grok og 304 over Astra. Grok ligger 153 over Astra og 40 bak Fable-ankeret. Ingen av delene er vår måling. De seks kallene våre var en faktura med to desimaler og en merge-funksjon. De måler ikke kontorarbeid.
Artificial Analysis satte Opus 5.5 til 58 på Intelligence Index ved max effort, og skrev at kostnaden per oppgave holdt seg på nivå med Opus 5 fordi output-tokens steg rundt 1,6×. Notatet deres om Grok 4.7 satte den modellen til 46 på samme indeks. Annen linjal, samme retning: Opus foran Grok, og ikke en grunn til å overse tokenregningen.
Terminal-Bench og CursorBench er ikke én linjal
Ikke ta gjennomsnittet av Anthropics 66,4 % og xAIs 38,0 %. Det er ikke samme celle på Terminal-Bench.
- Anthropic, Opus 5.5 på xhigh, Astra på high slik OpenAI rapporterte det: Terminal-Bench 4.0 er 66,4 % for Opus 5.5 og 57,9 % for Astra. Fable 5.1 er 55,8 % på den siden. CursorBench 4.0 er 57,8 % for Opus 5.5 og 51,8 % for Fable. Cellen til Astra på CursorBench er tom.
- Resultattavlen hos xAI: Terminal-Bench 4.0 er 38,0 % for Grok 4.7 xhigh og 57,9 % for Fable 5.1 Max. CursorBench er 46,3 % for Grok og 51,8 % for Fable. Astra står ikke på den tavlen. Fable-cellen på CursorBench, 51,8 %, matcher Anthropic. Fable-cellen på Terminal-Bench gjør det ikke: 57,9 % der, 55,8 % på siden til Anthropic.
- Artificial Analysis, et tredje oppsett: Opus 5.5 fikk 59,6 % på Terminal-Bench 4.0, på nivå med Astra på xhigh. Groks endring på den labens agentkjøring var fra 18 % til 33 %, ikke 38,0 %.
CursorBench kan settes ved siden av seg selv, fordi 51,8 % står der to ganger. Opus 5.5 på 57,8 % leder Fable med 6,0 poeng på Anthropics tall med høyere effort. Grok på 46,3 % ligger 5,5 poeng bak den Fable-cellen. Astra har ingen celle. Oppgi laben ved siden av prosenten. Uten det blir rangeringen en kollasj.
EEBench, Harvey og HealthBench er rader hos xAI. Opus 5.5 og Astra mangler. De blir stående i Grok-innlegget. AutomationBench og Terminal-Bench-Science er rader hos Anthropic og OpenAI. Grok mangler. De blir stående i innleggene om Opus og Astra.
Hva hvert eksisterende innlegg fortsatt eier
Denne siden erstatter ikke de tre innleggene den lenker til. Den rangerer bare de tre modellene mot hverandre.
- Opus 5.5-innlegget beholder kuttet til $4/$20, måleren på $0.02719, femtimersgrensen og cyber-fallbacken til Opus 4.8. Forsidebildet der er fortsatt Anthropics diagram. Astra-kolonnene leses her.
- Grok 4.7-innlegget beholder 4.7 mot 4.6: tolv kall, 12/12, og knekken på $2/$6. Søylen på 1 695 hører hjemme der. Opus 5.5 gjør det ikke.
- Astra-innlegget beholder Astra mot Fable 5.1, inkludert HTTP 400 fra 4. september og skillet mellom 99,9 % og 62,7 %. Kallbarheten endret seg 22. september. Avgjørelsen om Fable gjorde det ikke.
Hvilken av GPT-6 Astra, Opus 5.5 og Grok 4.7 du pinner
Du pinner Grok 4.7 når output-regningen er det som teller og jobben får plass i 500 000 tokens. Opus 5.5 pinner du når den delte GDPval-raden er det som teller. Astra pinner du når du allerede har målt en computer-use- eller mattejobb som de to andre innleggene dokumenterer, og du kan betale $10/$50.
- Korte kall uten cache, som disse seks: Grok var billigst samlet, $0.0038784 mot $0.005292 og $0.00709, og den var den dyre på fakturaen fordi resonneringen løp til 295 tokens. Ligner de korte kallene dine på
merge_intervals, er det funksjonsraden du kopierer. Ligner de på et tall på én linje, brukte Opus 46 tokens og vant den raden. - Cache-tunge agenter under 200 000 prompt-tokens: Opus på $0.20 per million cachede tokens slår begge. Astra på $1.00 er 5× den linjen. Cache-linjen på xAI-kortet til Grok er $0.50, altså 2,5× Opus.
- Prompter som krysser 200 000 tokens: Grok priser om hele forespørselen. En prompt på 250 000 tokens på xAI-kortet koster $4 og $12, ikke $2 og $6. Astras knekk starter senere, ved 272 000, og den setter ikke tokens under streken til ny pris slik dokumentasjonen til Grok beskriver.
- Kontorarbeid du vil overlate til GDPval: Opus 1 846, så Grok 1 695, så Astra 1 542, med Fables 1 735 mellom Opus og Grok. Den rekkefølgen tilhører labene. Den er ikke en score fra de seks kallene.
- Terminalarbeid: hold det utenfor denne rangeringen. Velg laben med den runneren du faktisk shipper, og bruk tallet derfra. Blander du 66,4 % og 38,0 %, får du ikke vite hvilken binær du skal kalle.
Ofte stilte spørsmål
Kan du kalle GPT-6 Astra på OpenRouter nå?
Ja, fra kl. 22:34 UTC 22. september 2026. Id-en openai/gpt-6-astra returnerte 1,96 på fakturaen og en merge_intervals som bestod de skjulte testene. 4. september returnerte samme id HTTP 400. Det tidligere innlegget noterer den 400-en. Dette noterer kallet som virket. Konteksten på listingen var 1 050 000 tokens.
Kuttet xAI prisen på Grok 4.7 fra $2 og $6?
Ikke på lanseringskortet denne siden siterer. Tabellen hos xAI er fortsatt $2 og $6 under 200 000 prompt-tokens, deretter $4 og $12. Katalogen hos OpenRouter under denne kjøringen var $1.60 og $4.80, deretter $3.20 og $9.60, altså 0,8× de linjene. Regningen for de seks kallene bruker tallet fra OpenRouter. Betaler du xAI direkte, følger regningen fortsatt xAIs kort til de endrer det.
Hvorfor mangler Grok på Anthropics benchmark-diagram?
Grok er ikke en kolonne på diagrammet hos Anthropic fra 22. september. Det sammenligner Opus 5.5 med Fable 5.1, Opus 5, GPT-6 Astra og GPT-5.6 Sol. Diagrammet hos xAI sammenligner Grok 4.7 med Grok 4.6, Sol og Fable. Opus 5.5 er ikke en kolonne der. GDPval er overlappen, fordi begge sidene oppgir Fable på 1 735 og Astra på 1 542.
Sier måleren på seks kall at Opus 5.5 er smartere?
Nei. Alle tre bestod begge oppgavene. Måleren er en regning og et tokenantall. GDPval er scoren fra labene, og den setter Opus 5.5 først av disse tre, på 1 846 mot 1 695 og 1 542. En bestått merge-funksjon bekrefter ikke 1 846, og 1 846 sier ikke hva fakturaen på $0.005292 blir.
Hvilken modell har det korteste kontekstvinduet?
Grok 4.7, med 500 000 tokens på listingen hos OpenRouter. Opus 5.5 har 1 000 000. Astra har 1 050 000. Grok priser også om ved 200 000 prompt-tokens, så det billige vinduet du faktisk kan bruke, er mindre enn 500 000. Astras høyere sats starter ved 272 000 og gjelder tokenene over den linjen, pluss en output-multiplikator på 1,5×.