Grok 4.7 مقابل Grok 4.6: نفس $2/$6 ، واللوحة تنقسم حسب المهمة
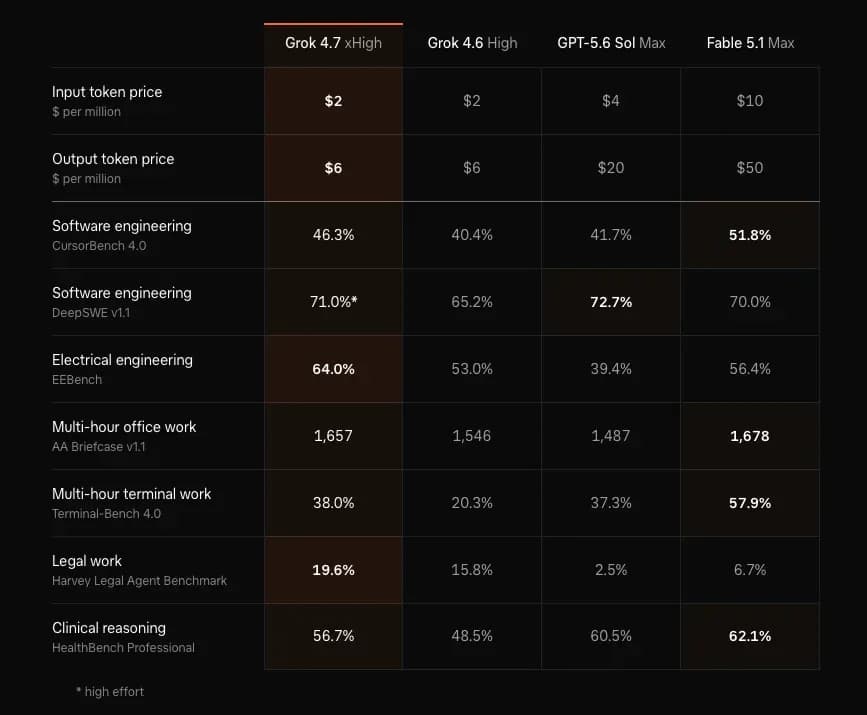
صدر Grok 4.7 في 21 سبتمبر 2026 بسعر $2 لكل مليون رمز إدخال و$6 لكل مليون رمز إخراج، وهي البطاقة نفسها لدى Grok 4.6. لوحة SpaceXAI نفسها تعطي 4.7 كل صف مقابل 4.6 ، ثم تخسر أربعة من تلك الصفوف السبعة أمام Fable 5.1 Max. حفظتُ المخططين من صفحة الإطلاق، وأرسلتُ 12 استدعاءً مُقيَّمًا عبر OpenRouter في 22 سبتمبر، من 14:51 إلى 14:53 بتوقيت UTC.
أين يتفوّق Grok 4.7 فعلًا على Grok 4.6
وجّه عمل الكهرباء والوكيل القانوني والطرفية إلى Grok 4.7 ، واترك البنود السريرية على Fable 5.1 أو GPT-5.6 Sol.
كل رقم في عمود المتصدر مأخوذ من منشور الإطلاق في 21 سبتمبر ، وتاريخ الجلب 22 سبتمبر 2026. الصف الأخير من هذا القياس.
| عبء العمل | المتصدر في الصف | Grok 4.7 | التوجيه |
|---|---|---|---|
| EEBench | Grok 4.7 xHigh | 64.0% | Grok 4.7 |
| الوكيل القانوني Harvey | Grok 4.7 xHigh | 19.6% | Grok 4.7 ، وقل للمستخدم إن 80.4% ما زالت تفوت |
| Terminal-Bench 4.0 | Fable 5.1 Max ، 57.9% | 38.0% | 4.7 عند مغادرة 4.6 ؛ وFable حين تكون الدرجة هي المنتج |
| CursorBench 4.0 | Fable 5.1 Max ، 51.8% | 46.3% | Fable ، إلا إذا كان إخراج $6 أهم من فجوة 5.5 نقطة |
| DeepSWE v1.1 | GPT-5.6 Sol Max ، 72.7% | 71.0% عند high لا عند xHigh | Sol ، أو 4.7 إن لم تكن 1.7 نقطة تستحق إخراج $20 |
| AA Briefcase v1.1 | Fable 5.1 Max ، 1,678 | 1,657 | Fable بفارق 21 Elo ، أو 4.7 حين تسيطر فاتورة الإخراج |
| HealthBench Professional | Fable 5.1 Max ، 62.1% | 56.7% | Fable أو Sol (60.5%) ، لا 4.7 |
| أربع استدعاءات قصيرة، من القياس | تعادل | 4/4 | أبقِ العميل الذي لديك |
يقع Grok 4.6 High تحت 4.7 في الصفوف السبعة المنشورة كلها. هذا كل ما يبرر الترقية مقابل النموذج الذي تشغّله أصلًا. ليست تبريرًا للترقية مقابل Fable في مهام المحرر، ولا في العمل المكتبي، ولا في عمل الطرفية، ولا في البنود السريرية.
ما الذي تعدّه لوحتا SpaceXAI
العمود البرتقالي هو xHigh ، والافتراضي في API هو high ، ورقم 71.0% في DeepSWE موسوم بأنه high.
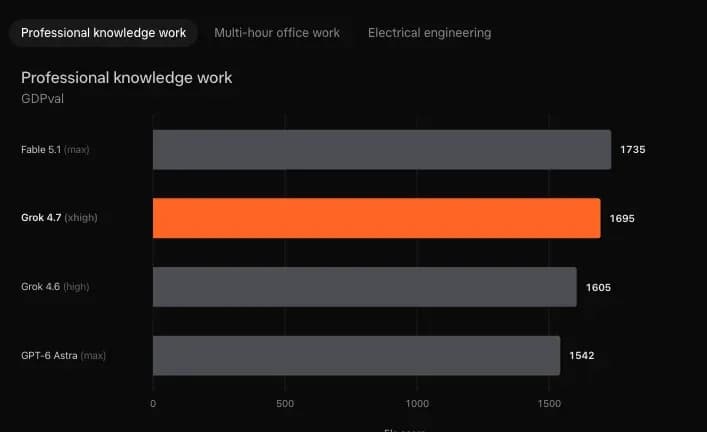
يضع GDPval نموذج Fable 5.1 max عند 1,735 Elo ، وGrok 4.7 xhigh عند 1,695 ، وGrok 4.6 high عند 1,605 ، وGPT-6 Astra max عند 1,542. هذا +90 Elo فوق 4.6 ، و40 Elo خلف Fable ، و153 Elo أمام Astra. اسم OpenAI على هذا المخطط هو Astra. اسم OpenAI على لوحة النتائج هو GPT-5.6 Sol Max. النموذجان مختلفان، وصفحة الإطلاق تستخدمهما معًا.
- اقرأ العمود البرتقالي بوصفه xHigh. تضبط وثائق docs.x.ai الجهد الافتراضي على high.
- اقرأ 71.0% بوصفها جهد high. النجمة على خلية DeepSWE هذه، ولا نجمة على أي خلية أخرى لـ Grok 4.7.
- أبقِ 1,542 الخاصة بـ Astra على مخطط Elo. لا تلصق الرقم في عمود Sol.
تفصل Artificial Analysis مكسب العمل المكتبي. على AA-Briefcase انتقلت جودة التحليل من 1,690 Elo على Grok 4.6 high إلى 1,994 على Grok 4.7. انتقلت جودة العرض من 1,519 إلى 1,499. ازدادت حدّة الوثائق في التحليل، وتراجعت قليلًا بوصفها وثائق.
CursorBench هي حزمة Cursor. وافقت SpaceX على شراء الشركة المطوّرة لـ Cursor ، وهي Anysphere ، مقابل $60B من الأسهم في 16 يونيو 2026.
يتوفر Grok 4.7 على API باسم grok-4.7 ، وداخل Cursor ، وهو النموذج الافتراضي في Grok Build. قال مقال 12 أغسطس عن Grok 4.6 مقابل Grok 4.5 إن 4.7 لم يكن قد صدر. صحّت تلك الجملة في 12 أغسطس. لم تعد صحيحة في 21 سبتمبر.
ما الذي تتركه أسعار $2 و$6 خارج البطاقة
فاتورة موجِّه (Prompt) من 250,000 رمز هي $4 و$12 ، وتسري على كل رمز داخل الطلب.
يطبع المخطط $2 و$6. تطبع صفحة النماذج صفين. تحت 200,000 رمز في الموجِّه تكون الأسعار $2 للإدخال، و$0.50 للإدخال المخزَّن مؤقتًا، و$6 للإخراج. عند 200,000 أو أكثر ينتقل الطلب كله إلى $4 و$1 و$12.
prompt, output = 250_000, 2_000
chart_rate = prompt / 1e6 * 2 + output / 1e6 * 6     # $0.512
cliff_rate = prompt / 1e6 * 4 + output / 1e6 * 12    # $1.024
عبور الخط يضاعف فاتورة لا يطبعها المخطط. يصير $0.512 مبلغ $1.024. الرموز التي تقع تحت 200,000 لا تحتفظ بالسعر الرخيص.
إدخال $2 يساوي نصف $4 لدى GPT-5.6 Sol ، وخُمس $10 لدى Fable 5.1. إخراج $6 أرخص بـ 3.3× من $20 لدى Sol ، وأرخص بـ 8.3× من $50 لدى Fable. مقابل كل دولار إخراج تحصل على 166,667 رمزًا مع Grok ، و50,000 مع Sol ، و20,000 مع Fable. عبارة «نصف السعر» تطابق صف الإدخال مقابل Sol. لا تطابق صف الإخراج لدى أي منهما.
يبقى الإدخال المخزَّن مؤقتًا $0.50 لكل مليون تحت 200,000 رمز، وهو رقم Grok 4.6 نفسه، ثم يصير $1 عند العتبة. أثر هذا السطر على فاتورة حقيقية هو موضوع دليل تكلفة الاستدلال.
Grok 4.7 Fast مفتاح منفصل: ضعف سرعة الإخراج بضعف سعر الرمز، داخل Cursor وGrok Build. ليس عتبة 200,000 رمز، وواجهة API العامة لا تبيعه.
قاست Artificial Analysis الموجِّهات الطويلة عند نحو 188 رمزًا في الثانية، ونحو 7.1 دقيقة لكل مهمة على Intelligence Index. وسيط الاستدعاءات القصيرة في هذا القياس كان 5.02 ثانية لـ Grok 4.7 high مقابل 8.12 ثانية لـ Grok 4.6 high. لا يعني أي الرقمين أن السرعة 2× مقابل Fable أو Sol.
ماذا أعادت 12 استدعاءً من Grok 4.7 في 22 سبتمبر
النتيجة 12/12 عبر 12 استدعاءً ، وأعاد xhigh الإجابات الأربع نفسها التي أعادها high.
الموجِّهات الأربعة نفسها، وtemperature عند 0 ، وmax_tokens عند 4000 ، ومحاولة واحدة لكل موجِّه، ومن دون أدوات. Grok 4.6 عند high ، وGrok 4.7 عند high ، وGrok 4.7 عند xhigh. البوابة كانت OpenRouter ، وهو الإعداد الوارد في مقارنة بوابات LLM. كائنات usage الخام موجودة في benchmark-raw.json إلى جانب هذا المقال. بلغ مجموع usage.cost لدى OpenRouter للاستدعاءات الاثني عشر $0.029279.
{
  "model": "x-ai/grok-4.7",
  "temperature": 0,
  "max_tokens": 4000,
  "reasoning": {"effort": "xhigh"},
  "messages": [{"role": "user", "content": "..."}]
}| المهمة | المتوقع | 4.6 high | 4.7 high | 4.7 xhigh |
|---|---|---|---|---|
| وسيط الأعداد 3, 1, 4, 1, 5, 9 | 3.5 | 3.5 ، 6.17 ثانية ، 348 رمز | 3.5 ، 5.42 ثانية ، 359 رمز | 3.5 ، 4.67 ثانية ، 300 رمز |
| 2.2 kΩ عند 5 mA | 11 V | 11 ، 8.06 ثانية ، 511 رمز | 11 ، 4.62 ثانية ، 273 رمز | 11 ، 5.31 ثانية ، 348 رمز |
| أعد المحاولة عند 429 و503 ، ولا تُعدها أبدًا عند 500 | 429,503 | 429,503 ، 78.30 ثانية ، 451 رمز | 429,503 ، 3.37 ثانية ، 216 رمز | 429,503 ، 2.07 ثانية ، 87 رمز |
count_passed([59, 60, 100, 0]) والحلقة تبدأ عند الفهرس 1 | 2 | 2 ، 8.18 ثانية ، 466 رمز | 2 ، 6.10 ثانية ، 409 رمز | 2 ، 5.16 ثانية ، 368 رمز |
هبطت رموز الإكمال من 1,776 على Grok 4.6 high إلى 1,257 على Grok 4.7 high ثم إلى 1,103 عند xhigh. رموز الاستدلال، وهي داخلة في أعداد الإكمال تلك، كانت 1,543 ثم 1,052 ثم 944. تحركت فاتورة OpenRouter معها: $0.012258 ثم $0.008877 ثم $0.008144. هذا أقل بـ 29.2% من رموز الإكمال عند high ، وفاتورة أصغر بـ 27.6% ، على اختبار أنهاه النموذجان بنتيجة 4/4.
عاد prompt_tokens لدى Grok 4.7 أعلى بـ 1,036 بالضبط من استدعاء Grok 4.6 المطابق عند high: 1,311 مقابل 275 ، و1,288 مقابل 252 ، و1,295 مقابل 259 ، و1,339 مقابل 303. أضاف xhigh رمزًا واحدًا في كل استدعاء. عند $2 لكل مليون يساوي 1,036 رمزًا مبلغ $0.002072. وسيط البند المفوتر كان $0.002446 على 4.6 و$0.002438 على 4.7 high ، فلم تظهر الفجوة على الفاتورة. فواتير Grok 4.6 الأربع تطابق $2 و$6 على الأعداد المُعادة. لا بند للألف الزائدة.
تجربة 78.30 ثانية هي موجِّه واحد ومحاولة واحدة. أجاب Grok 4.7 high عن موجِّه مجموعة إعادة المحاولة نفسه في 3.37 ثانية، وأجاب xhigh في 2.07 ثانية، والثلاثة أعادت 429,503. وسيط زمن الاستجابة عبر الموجِّهات الأربعة كان 8.12 ثانية، ثم 5.02 ثانية، ثم 4.92 ثانية. لا تحوّل المحاولة البطيئة الوحيدة إلى نسبة سرعة.
تنقلب صورة الرموز في العمل الطويل. أفادت Artificial Analysis بنحو 81,000 رمز إخراج لكل مهمة على Intelligence Index لدى Grok 4.7 عند xhigh ، مقابل نحو 36,000 لدى Grok 4.6 عند high. وسيط 316 رمز يصف أربع إجابات قصيرة. لا يصف حقيبة AA Briefcase تمتد عدة ساعات.
من أين تأتي نسبة الطرفية 38%
ثلاثة أرقام منشورة لـ Terminal-Bench 4.0 تختلف: 38.0% ، و33% ، وارتفاع بمقدار 4.5 نقطة.
- جدول إطلاق xAI ، وهو لقطة الشاشة أعلاه: Grok 4.7 xHigh عند 38.0% ، وGrok 4.6 High عند 20.3% ، وGPT-5.6 Sol Max عند 37.3% ، وFable 5.1 Max عند 57.9%. مقابل 4.6 هذا 1.87× ، أو +17.7 نقطة. مقابل Sol هذا +0.7 نقطة. يتقدّم Fable بـ 19.9 نقطة.
- Artificial Analysis ، وGrok Build بوصفه الوكيل، في 21 سبتمبر 2026: ارتفع Terminal-Bench 4.0 من 18% إلى 33% ، وارتفع DeepSWE v1.1 من 65% إلى 73%. تحرّك مؤشر Coding Agent Index من 47 إلى 56 وحلّ رابعًا، خلف Fable 5.1 وGPT-6 Astra وClaude Opus 5.
- مؤشر Intelligence Index في المختبر نفسه، بمشغّل واحد مشترك لكل نموذج: ارتفع Terminal-Bench 4.0 بمقدار 4.5 نقطة، وارتفع المؤشر نقطتين إلى 46. هبط AA-LCR بمقدار 3.7 نقطة. هبط AutomationBench-AA بمقدار 1.1 نقطة.
لا تسمّي xAI الوكيل خلف 38.0%. ضع في الميزانية الرقم الذي يطابق عميلك. تسجّل مراجعة Fable 5.1 نسبة 55.8% لـ Fable على Terminal-Bench 4.0 ، مقابل 57.9% على هذه اللوحة. مؤشر البرمجة لدى Astra مكانه في مقال GPT-6 Astra. هذه الصفحة لا تحتاج إلا عمود 1,542 Elo.
أي عبء عمل ينبغي أن يغادر Grok 4.6
الاستدعاءات المُهيكلة القصيرة يمكن أن تبقى. أعمال الطرفية والكهرباء والوكيل القانوني ينبغي أن تنتقل.
ما زال Fable يتقدّم في CursorBench 4.0 بـ 5.5 نقطة: 51.8% مقابل 46.3%. ما زال HealthBench Professional يضع Fable عند 62.1% وSol عند 60.5% ، وGrok 4.7 عند 56.7%. هذان الصفان هما سبب أن «بدّل كل شيء» ترتيب خاطئ.
| إذا كانت المهمة بهذا الشكل | أبقِ | انتقل إلى Grok 4.7 حين |
|---|---|---|
| تحويل مُقيَّم قصير، مثل الموجِّهات الأربعة أعلاه | النموذج الموصول أصلًا | فاتورة رموز الإكمال هي الشكوى الوحيدة. هبطت في القياس 29.2% عند high |
| عمل سطر أوامر بشكل Terminal-Bench 4.0 | Fable 5.1 ، إن كان 57.9% هو المطلوب | تغادر 20.3% لدى Grok 4.6 وتقبل البقاء عند 38.0% |
| عمل دوائر ووحدات بشكل EEBench | لا أحد على هذه اللوحة يهزم 64.0% | دائمًا، على هذا الجدول |
| حلقة وكيل قانوني بشكل Harvey | لا أحد على هذه اللوحة يهزم 19.6% | دائمًا على هذا الجدول، مع نسبة تفويت 80.4% في العقد |
| مستندات لساعات، AA Briefcase | Fable ، متقدمة بـ 21 Elo عند 1,678 | سعر الإخراج يسيطر: $6 مقابل $50 لدى Fable |
| مهام المحرر، CursorBench 4.0 | Fable عند 51.8% | فجوة 5.5 نقطة أرخص من معدل إخراج 8.3× |
| بنود سريرية، HealthBench Professional | Fable أو Sol | لا تنتقل من أجل الدرجة. 56.7% تتأخر عن الاثنين |
سعر إخراج Fable البالغ $50 يساوي 8.3× سعر $6 لدى Grok. ادفع هذا المضاعف حين يكون الصف هو المنتج. الخيار نفسه، إن كتبته إعداد توجيه، موجود في دليل توجيه النماذج. نسبة Harvey البالغة 19.6% تتصدّر هذه اللوحة، وتفوّت 80.4% من المجموعة رغم ذلك.
ما الذي لا يخبرك به هذا القياس
أربعة موجِّهات، محاولة واحدة لكل منها، لا تقول شيئًا عن CursorBench 4.0 ولا عن مهمة مكتبية من 7 دقائق.
- ضبطتُ temperature عند 0 ، و
max_tokensعند 4000 ، وأغلقتُ الأدوات، ولم أُعد أي محاولة. محاولة ثانية على استدعاء 78.30 ثانية ربما خرجت عادية. - لم أستدعِ Fable 5.1 ولا GPT-5.6 Sol ولا GPT-6 Astra. خلاياها منقولة عن xAI وعن Artificial Analysis.
- فجوة 1,036 رمز في الموجِّه حقيقة محاسبية. لا شيء في الرد يسمّي تلك الرموز، والفاتورة لم تضف قيمة السعر المعلن البالغة $0.002072.
- سجّلت Artificial Analysis تراجعات، لا مكاسب فقط: هبط AA-LCR بمقدار 3.7 نقطة، وهبط AutomationBench-AA بمقدار 1.1 نقطة، وهبطت جودة العرض على AA-Briefcase من 1,519 Elo إلى 1,499.
- دقة AA-Omniscience كانت 47% لدى Grok 4.7 مقابل 48% لدى Grok 4.6 high. هبط معدل الهلوسة على تلك المجموعة من 34% إلى 29%.
اعتمد 4.7 حيث تحرّك الصف، وحيث يحتمل المعدل المطلق أن يُذكر إلى جانب اسم عميل. اترك البنود السريرية على Fable أو Sol. اترك xhigh مغلقًا إلى أن تغيّر مهمة مُقيَّمة جوابها. هذه الموجِّهات الأربعة لم تغيّر جوابها.
الأسئلة الشائعة
ما قطع المعرفة لدى Grok 4.7 ؟
يؤرّخ docs.x.ai القطع في مايو 2026. إصدار 21 سبتمبر هذا ليس داخل الأوزان. بحث الويب وبحث X أداتان منفصلتان على الصفحة نفسها. طلب من دون هاتين الأداتين يجيب من مايو 2026. مرّر المصدر داخل الموجِّه حين يكون الواقع أحدث من ذلك.
هل تغيّر نقطة النهاية الأمريكية سعر الرمز؟
عنوان الأساس الإقليمي للولايات المتحدة هو https://us.api.x.ai/v1. يسعّر docs.x.ai هذا المسار بعلاوة 10% كي يبقى الاستدلال داخل الولايات المتحدة. يصير رمز الإخراج من $6 إلى $6.60 هناك، ويصير رمز الإدخال من $2 إلى $2.20. معرّف النموذج يبقى grok-4.7. عتبة 200,000 رمز ومعدل الإدخال المخزَّن مؤقتًا يسريان فوق تلك العلاوة.
هل يقبل API صورة؟
نعم. تسرد صفحة النموذج إدخال نص وصورة مع إخراج نص فقط، وسياقًا من 500,000 رمز، وبلا سقف على إخراج النص. الصور المقبولة jpg أو png ، حتى 20 ميبيبايت لكل صورة، وبلا سقف معلن على العدد. الرد نص. توليد الصور يبقى على نماذج Imagine وعلى قائمة أسعارها.
أين يعمل Grok 4.7 Fast فعلًا؟
Fast هو الأوزان نفسها على آلات أسرع، وبضعفي سعر الرمز: $4 للإدخال و$12 للإخراج خارج البطاقة القياسية. يبيعه docs.x.ai داخل Cursor وGrok Build ، ويُخرجه من الطبقة المجانية في Grok Build. واجهة API العامة لا تدرجه. حركة API تبقى على $2 و$6 ، والعتبة داخلة في الحساب.
أي سلسلة نموذج يرسلها SDK ؟
على واجهة xAI API السلسلة هي grok-4.7. على OpenRouter استدعيتُ x-ai/grok-4.7 في 22 سبتمبر 2026. اضبط reasoning.effort على low أو medium أو high أو xhigh. High هو الافتراضي الموثّق. العمود البرتقالي هو xhigh ، فالعميل الذي يحذف الحقل ليس ذلك العمود.