Grok 4.7 vs Grok 4.6: gleiche $2/$6, und das Board teilt sich nach Job
Grok 4.7 ging am 21. September 2026 zu $2 je Million Input-Token und $6 je Million Output-Token live, dieselbe Karte wie bei Grok 4.6. Auf der Tabelle von SpaceXAI liegt 4.7 in jeder Zeile vor 4.6 und verliert danach vier dieser sieben Zeilen an Fable 5.1 Max. Beide Charts von der Launch-Seite haben wir gespeichert. Am 22. September, 14:51 bis 14:53 UTC, haben wir 12 benotete Calls über OpenRouter geschickt.
Wo Grok 4.7 Grok 4.6 wirklich schlägt
Schick Elektrik, Legal-Agent und Terminal an Grok 4.7. Klinische Fälle bleiben bei Fable 5.1 oder bei GPT-5.6 Sol.
Jede Zahl in der Führungsspalte stammt aus dem Launch-Post vom 21. September, abgerufen am 22. September 2026. Die letzte Zeile ist unsere.
| Arbeitslast | Führend in der Zeile | Grok 4.7 | Routing |
|---|---|---|---|
| EEBench | Grok 4.7 xHigh | 64,0 % | Grok 4.7 |
| Harvey Legal-Agent | Grok 4.7 xHigh | 19,6 % | Grok 4.7, und sag dem Nutzer, dass 80,4 % weiter danebenliegen |
| Terminal-Bench 4.0 | Fable 5.1 Max, 57,9 % | 38,0 % | 4.7, wenn du 4.6 verlässt; Fable, wenn der Score das Produkt ist |
| CursorBench 4.0 | Fable 5.1 Max, 51,8 % | 46,3 % | Fable, außer wenn $6 Output eine Lücke von 5,5 Punkten aufwiegt |
| DeepSWE v1.1 | GPT-5.6 Sol Max, 72,7 % | 71,0 % bei high, nicht bei xHigh | Sol, oder 4.7, wenn 1,7 Punkte den Output zu $20 nicht wert sind |
| AA Briefcase v1.1 | Fable 5.1 Max, 1.678 | 1.657 | Fable mit 21 Elo Vorsprung, oder 4.7, wenn die Output-Rechnung dominiert |
| HealthBench Professional | Fable 5.1 Max, 62,1 % | 56,7 % | Fable oder Sol (60,5 %), nicht 4.7 |
| Vier kurze Calls, unsere | Gleichstand | 4/4 | Behalte den Client, den du hast |
Grok 4.6 High liegt auf allen sieben veröffentlichten Zeilen unter 4.7. Das ist das ganze Upgrade-Argument gegen das Modell, das bei dir schon läuft. Gegen Fable trägt es bei Editor-Aufgaben, Büroarbeit, Terminal-Arbeit und klinischen Fällen nicht.
Was die zwei Charts von SpaceXAI zählen
Die orange Säule ist xHigh, der API-Default ist high, und die 71,0 % bei DeepSWE sind als high markiert.
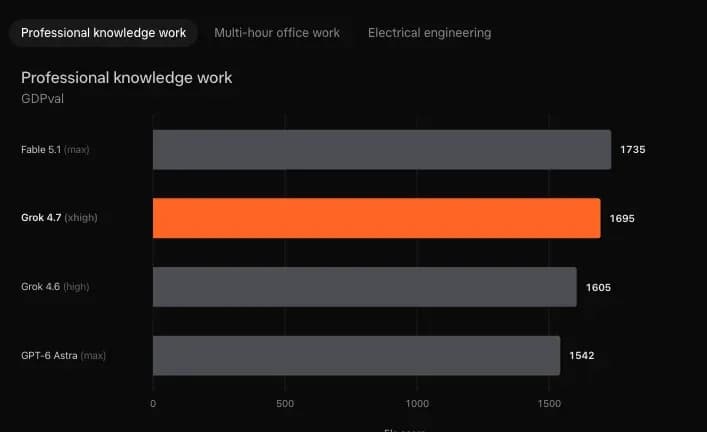
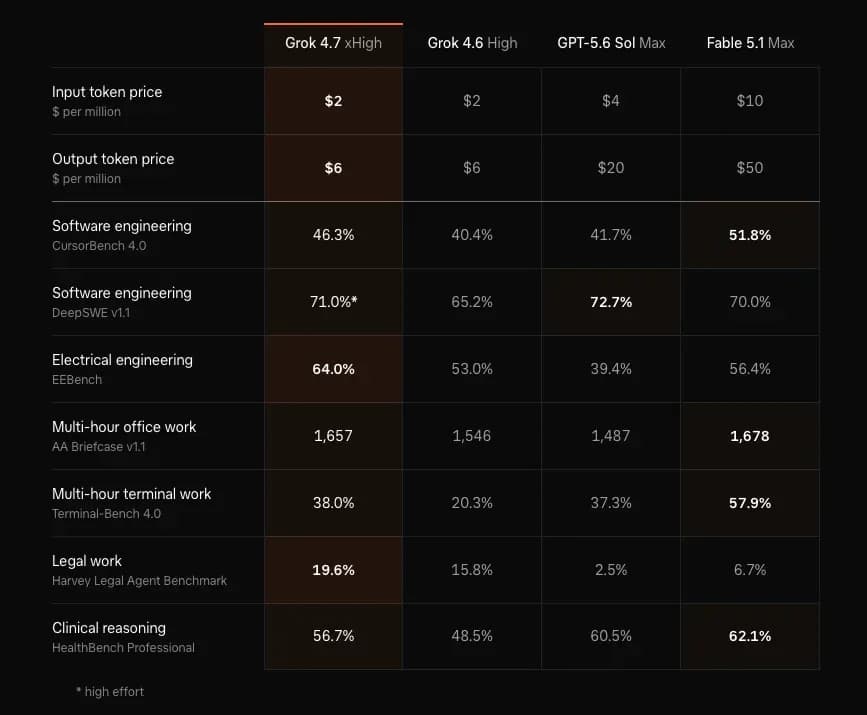
GDPval setzt Fable 5.1 max auf 1.735 Elo, Grok 4.7 xhigh auf 1.695, Grok 4.6 high auf 1.605 und GPT-6 Astra max auf 1.542. Das sind +90 Elo gegenüber 4.6, 40 Elo hinter Fable und 153 Elo vor Astra. Auf diesem Chart heißt das OpenAI-Modell Astra. Auf dem Scoreboard heißt es GPT-5.6 Sol Max. Das sind verschiedene Modelle, und die Launch-Seite nutzt beide.
- Lies die orange Säule als xHigh. docs.x.ai setzt den Default-Effort auf high.
- Lies 71,0 % als Effort high. Das Sternchen sitzt auf dieser DeepSWE-Zelle und auf keiner anderen Zelle von Grok 4.7.
- Lass die 1.542 von Astra auf dem Elo-Chart. Trag sie nicht in die Spalte von Sol ein.
Artificial Analysis teilt den Zugewinn bei der Büroarbeit auf. Auf AA-Briefcase stieg die analytische Qualität von 1.690 Elo bei Grok 4.6 high auf 1.994 bei Grok 4.7. Die Präsentationsqualität ging von 1.519 auf 1.499. In der Analyse wurden sie schärfer. Als Dokumente fielen sie etwas ab.
CursorBench ist die Suite von Cursor. SpaceX hat am 16. Juni 2026 zugestimmt, Anysphere, den Hersteller von Cursor, für $60B in Aktien zu kaufen.
Grok 4.7 liegt als grok-4.7 auf der API, in Cursor und als Default-Modell in Grok Build. Im Text vom 12. August über Grok 4.6 im Vergleich mit Grok 4.5 stand, 4.7 sei noch nicht erschienen. Am 12. August stimmte der Satz. Am 21. September nicht mehr.
Was die Karte mit $2 und $6 verschweigt
Ein Prompt mit 250.000 Token wird mit $4 und $12 berechnet, auf jedem Token in der Anfrage.
Auf dem Chart stehen $2 und $6. Die Modellseite führt zwei Zeilen. Unter 200.000 Prompt-Token gelten $2 Input, $0.50 für gecachten Input und $6 Output. Ab 200.000 wird die ganze Anfrage auf $4, $1 und $12 umgestellt.
prompt, output = 250_000, 2_000
chart_rate = prompt / 1e6 * 2 + output / 1e6 * 6     # $0.512
cliff_rate = prompt / 1e6 * 4 + output / 1e6 * 12    # $1.024
Über der Linie verdoppelt sich eine Rechnung, die das Chart nie zeigt. Aus $0.512 werden $1.024. Die Token unter 200.000 behalten den günstigen Satz nicht.
Input zu $2 ist die Hälfte der $4 von GPT-5.6 Sol und ein Fünftel der $10 von Fable 5.1. Output zu $6 ist um den Faktor 3,3 günstiger als die $20 von Sol und um den Faktor 8,3 günstiger als die $50 von Fable. Pro Output-Dollar sind das 166.667 Token bei Grok, 50.000 bei Sol und 20.000 bei Fable. „Halber Preis“ passt auf die Input-Zeile gegen Sol. Auf keine der beiden Output-Zeilen passt der Satz.
Gecachter Input bleibt unter 200.000 Token bei $0.50 je Million, dieselbe Zahl wie bei Grok 4.6, und springt an der Kante auf $1. Wie diese Cache-Zeile auf einer echten Rechnung landet, steht in der Anleitung zu den Inferenzkosten.
Grok 4.7 Fast ist ein eigener Schalter: die doppelte Output-Geschwindigkeit zum doppelten Token-Preis, in Cursor und in Grok Build. Das ist nicht die Kante bei 200.000 Token, und die öffentliche API verkauft den Modus nicht.
Artificial Analysis hat lange Prompts mit etwa 188 Token pro Sekunde gemessen und etwa 7,1 Minuten je Aufgabe im Intelligence Index. Unser Median bei den kurzen Calls lag für Grok 4.7 high bei 5,02 Sekunden und für Grok 4.6 high bei 8,12 Sekunden. Keine der beiden Zahlen ist ein Beleg für 2-fache Geschwindigkeit gegen Fable oder Sol.
Was 12 Calls von Grok 4.7 am 22. September zurückgaben
Zwölf Calls trafen 12/12, und xhigh lieferte dieselben vier Antworten wie high.
Dieselben vier Prompts, temperature 0, max_tokens 4000, ein Durchgang je Prompt, keine Tools. Grok 4.6 auf high, Grok 4.7 auf high, Grok 4.7 auf xhigh. Das Gateway war OpenRouter, dasselbe Setup wie in unserem Vergleich der LLM-Gateways. Die rohen usage-Objekte liegen in benchmark-raw.json neben diesem Beitrag. usage.cost von OpenRouter über die zwölf Calls lag in der Summe bei $0.029279.
{
  "model": "x-ai/grok-4.7",
  "temperature": 0,
  "max_tokens": 4000,
  "reasoning": {"effort": "xhigh"},
  "messages": [{"role": "user", "content": "..."}]
}| Aufgabe | Erwartet | 4.6 high | 4.7 high | 4.7 xhigh |
|---|---|---|---|---|
| Median von 3, 1, 4, 1, 5, 9 | 3,5 | 3,5; 6,17 s; 348 tok | 3,5; 5,42 s; 359 tok | 3,5; 4,67 s; 300 tok |
| 2,2 kΩ bei 5 mA | 11 V | 11; 8,06 s; 511 tok | 11; 4,62 s; 273 tok | 11; 5,31 s; 348 tok |
| 429 und 503 wiederholen, 500 nie | 429, 503 | 429, 503; 78,30 s; 451 tok | 429, 503; 3,37 s; 216 tok | 429, 503; 2,07 s; 87 tok |
count_passed([59, 60, 100, 0]), Schleife startet bei Index 1 | 2 | 2; 8,18 s; 466 tok | 2; 6,10 s; 409 tok | 2; 5,16 s; 368 tok |
Die Completion-Token fielen von 1.776 bei Grok 4.6 high auf 1.257 bei Grok 4.7 high und auf 1.103 bei xhigh. Die Reasoning-Token stecken in diesen Completion-Zählern und lagen bei 1.543, dann bei 1.052, dann bei 944. Die Rechnung von OpenRouter zog mit: $0.012258, dann $0.008877, dann $0.008144. Das sind bei high 29,2 % weniger Completion-Token und eine um 27,6 % kleinere Rechnung, auf einem Test, den beide Modelle mit 4/4 beendet haben.
Die prompt_tokens von Grok 4.7 lagen auf high exakt 1.036 über dem jeweils passenden Call von Grok 4.6: 1.311 zu 275, 1.288 zu 252, 1.295 zu 259, 1.339 zu 303. Bei xhigh kam auf jedem Call ein Token dazu. Bei $2 je Million kosten 1.036 Token $0.002072. Der Median-Posten kostete auf 4.6 $0.002446 und auf 4.7 high $0.002438. Die Lücke hat die Rechnung verfehlt. Die vier Rechnungen von Grok 4.6 entsprechen $2 und $6 auf den gemeldeten Zählern. Für die zusätzlichen Tausend steht keine eigene Zeile auf der Rechnung.
Der Durchgang mit 78,30 Sekunden ist ein Prompt, ein Versuch. Grok 4.7 high hat denselben Retry-Prompt in 3,37 Sekunden beantwortet, xhigh in 2,07 Sekunden, alle drei mit 429,503. Die Median-Latenz über die vier Prompts lag bei 8,12 s, 5,02 s und 4,92 s. Mach aus dem einzelnen langsamen Durchgang kein Geschwindigkeitsverhältnis.
Bei langer Arbeit kippt das Token-Bild. Artificial Analysis meldete für Grok 4.7 auf xhigh etwa 81.000 Output-Token je Aufgabe im Intelligence Index, gegen etwa 36.000 für Grok 4.6 auf high. Unser Median von 316 Token beschreibt vier kurze Antworten. Einen mehrstündigen Briefcase beschreibt er nicht.
Woher die 38 % im Terminal-Score kommen
Drei veröffentlichte Werte zu Terminal-Bench 4.0 passen nicht zusammen: 38,0 %, 33 % und ein Anstieg um 4,5 Punkte.
- Die Launch-Tabelle von xAI, der Screenshot oben: Grok 4.7 xHigh 38,0 %, Grok 4.6 High 20,3 %, GPT-5.6 Sol Max 37,3 %, Fable 5.1 Max 57,9 %. Gegen 4.6 liegt der Faktor bei 1,87. Das sind +17,7 Punkte. Gegen Sol sind es +0,7 Punkte. Fable liegt 19,9 Punkte vorn.
- Artificial Analysis, Grok Build als Agent, 21. September 2026: Terminal-Bench 4.0 von 18 % auf 33 %, DeepSWE v1.1 von 65 % auf 73 %. Deren Coding Agent Index ging von 47 auf 56 und landete auf Platz vier, hinter Fable 5.1, GPT-6 Astra und Claude Opus 5.
- Der Intelligence Index desselben Labors, ein gemeinsamer Runner für jedes Modell: Terminal-Bench 4.0 um 4,5 Punkte nach oben, der Index um 2 Punkte auf 46. AA-LCR fiel um 3,7 Punkte. AutomationBench-AA fiel um 1,1 Punkte.
xAI nennt den Agenten hinter den 38,0 % nicht. Rechne mit der Zahl, die zu deinem Client passt. Die Messung zu Fable 5.1 notiert für Fable 55,8 % auf Terminal-Bench 4.0. Auf diesem Board stehen 57,9 %. Der Coding-Index von Astra gehört in den Beitrag zu GPT-6 Astra. Diese Seite braucht nur den Balken bei 1.542 Elo.
Welche Arbeitslast Grok 4.6 verlassen sollte
Kurze, strukturierte Calls können bleiben. Terminal, Elektrik und Legal-Agent sollten wechseln.
Fable führt CursorBench 4.0 weiter mit 5,5 Punkten an, 51,8 % gegen 46,3 %. Auf HealthBench Professional steht Fable weiter bei 62,1 % und Sol bei 60,5 %, Grok 4.7 bei 56,7 %. Wegen dieser zwei Zeilen ist „alles umstellen“ die falsche Reihenfolge.
| Wenn der Job so aussieht | Behalten | Wechsel zu Grok 4.7, wenn |
|---|---|---|
| Ein kurzer benoteter Transform wie die vier Prompts oben | Das Modell, das schon angebunden ist | Einziger Einwand ist die Completion-Token-Rechnung. Unsere Token fielen auf high um 29,2 % |
| Shell-Arbeit in der Form von Terminal-Bench 4.0 | Fable 5.1, wenn 57,9 % die Anforderung ist | Du verlässt die 20,3 % von Grok 4.6 und kannst mit 38,0 % leben |
| Schaltungs- und Einheitenarbeit in der Form von EEBench | Niemand auf diesem Board schlägt 64,0 % | Immer, auf dieser Tabelle |
| Eine Legal-Agent-Schleife in der Form von Harvey | Niemand auf diesem Board schlägt 19,6 % | Immer auf dieser Tabelle, mit der Fehlquote von 80,4 % im Vertrag |
| Mehrstündige Dokumente, AA Briefcase | Fable, 21 Elo voraus bei 1.678 | Der Output-Preis dominiert: $6 gegen $50 bei Fable |
| Editor-Aufgaben, CursorBench 4.0 | Fable bei 51,8 % | Eine Lücke von 5,5 Punkten ist billiger als die 8,3-fache Output-Rate |
| Klinische Fälle, HealthBench Professional | Fable oder Sol | Nicht wegen des Scores wechseln. 56,7 % liegen hinter beiden |
Der Output-Satz von Fable, $50, ist das 8,3-Fache der $6 von Grok. Den Faktor zahlst du, wenn die Zeile das Produkt ist. Dieselbe Wahl, aufgeschrieben als Router-Config, steht in der Anleitung zum Modell-Routing. Die 19,6 % von Harvey führen dieses Board an und verfehlen trotzdem 80,4 % des Sets.
Was dir diese Messung nicht sagen kann
Vier Prompts mit je einem Durchgang sagen nichts über CursorBench 4.0 und nichts über eine Büroaufgabe von 7 Minuten.
- Temperature war 0,
max_tokenswar 4000, die Tools waren aus, und einen zweiten Versuch gab es nicht. Ein zweiter Durchgang auf dem Call mit 78,30 Sekunden kann ganz gewöhnlich ausfallen. - Fable 5.1, GPT-5.6 Sol und GPT-6 Astra haben wir nicht aufgerufen. Deren Zellen zitieren wir aus xAI und aus Artificial Analysis.
- Die Prompt-Lücke von 1.036 Token ist eine Tatsache der Abrechnung. Die Antwort benennt diese Token nicht, und die Rechnung hat den Listenpreis von $0.002072 nicht aufgeschlagen.
- Artificial Analysis hat Rückgänge festgehalten. Die Zugewinne sind nicht das ganze Bild: AA-LCR um 3,7 Punkte nach unten, AutomationBench-AA um 1,1 Punkte, die Präsentationsqualität auf AA-Briefcase von 1.519 Elo auf 1.499.
- Die Trefferquote auf AA-Omniscience lag bei 47 % für Grok 4.7 und bei 48 % für Grok 4.6 high. Die Halluzinationsrate auf diesem Set fiel von 34 % auf 29 %.
Schick 4.7 dorthin, wo sich die Zeile bewegt hat und die absolute Rate neben einem Kundennamen stehen kann. Klinische Fälle bleiben bei Fable oder Sol. Lass xhigh aus, bis eine benotete Aufgabe ihre Antwort ändert. Diese vier haben das nicht getan.
Häufig gestellte Fragen
Bis wann reicht das Wissen von Grok 4.7?
docs.x.ai nennt als Cutoff den Mai 2026. Dieses Release vom 21. September steckt nicht in den Gewichten. Websuche und die Suche auf X sind auf derselben Seite eigene Tools. Eine Anfrage ohne diese Tools antwortet aus dem Wissensstand von Mai 2026. Gib die Quelle im Prompt mit, wenn der Fakt jünger ist als dieser Stand.
Ändert der US-Endpunkt den Token-Preis?
Die regionale Basis-URL für die USA lautet https://us.api.x.ai/v1. docs.x.ai verlangt dafür einen Aufschlag von 10 %, damit die Inferenz in den USA bleibt. Ein Output-Token zu $6 wird dort $6.60, ein Input-Token zu $2 wird $2.20. Die Modell-ID bleibt grok-4.7. Die Kante bei 200.000 Token und der Satz für gecachten Input gelten zusätzlich zu diesem Aufschlag.
Nimmt die API ein Bild an?
Ja. Die Modellseite nennt Text und Bild als Input und nur Text als Output, dazu ein Kontextfenster von 500.000 Token und keine Obergrenze beim Text-Output. Angenommen werden jpg und png, bis 20 MiB je Bild, ohne genannte Obergrenze für die Anzahl. Die Antwort ist Text. Die Bildgenerierung bleibt bei den Imagine-Modellen und bei deren eigener Preisliste.
Wo läuft Grok 4.7 Fast tatsächlich?
Grok 4.7 Fast nutzt dieselben Gewichte auf schnelleren Maschinen, zum doppelten Token-Satz: $4 Input und $12 Output, abseits der Standardkarte. docs.x.ai verkauft den Modus in Cursor und in Grok Build. Im Gratis-Tarif von Grok Build fehlt er. Die öffentliche API führt ihn nicht auf. Der API-Verkehr bleibt bei $2 und $6, Kante inklusive.
Welchen Modell-String soll das SDK senden?
Auf der xAI-API lautet der String grok-4.7. Auf OpenRouter haben wir am 22. September 2026 x-ai/grok-4.7 aufgerufen. Setze reasoning.effort auf low, medium, high oder xhigh. High ist der dokumentierte Default. Die orange Säule ist xhigh. Ein Client, der das Feld weglässt, liegt nicht auf dieser Säule.