Claude Sonnet 5.5: mismo precio de $2/$10, pero el ahorro del 30 % solo aparece en tareas largas
Anthropic lanzó Claude Sonnet 5.5 el 28 de septiembre de 2026 exactamente al precio de Sonnet 5: $2 por millón de tokens de entrada y $10 por millón de salida. Un día después pasamos 19 llamadas evaluadas por OpenRouter. En un archivo HTML largo la factura bajó un 11,1 %. En una suma de factura diminuta subió un 12,8 %.
Mismo precio. Distinta factura.
¿Qué cambia con Claude Sonnet 5.5, lanzado el 28 de septiembre?
Cambia el id del modelo a claude-sonnet-5-5 y tu tarifa por token sigue en $2 de entrada y $10 de salida.
La página de precios de Anthropic lista Sonnet 5.5 y Sonnet 5 en filas idénticas, con caché y batch incluidos, así que toda diferencia de coste entre ambos es una diferencia de tokens.
| Elemento | Sonnet 5.5 en el lanzamiento |
|---|---|
| Id del modelo en la API | claude-sonnet-5-5 |
| Entrada / salida, por 1M de tokens | $2 / $10 |
| Lectura de caché / escritura de caché | $0.20 / $2.50 (5 min), $4 (1 hora) |
| Batch entrada / salida | $1 / $5 |
| Contexto / salida máxima | 1M / 128K tokens |
| Esfuerzo por defecto | Medium en Claude Code y las apps, High en la API |
| Disponibilidad | Zero data retention; AWS, Google Cloud, Microsoft Azure |
| GitHub Copilot | Pro, Pro+, Max, Business, Enterprise, a precio de lista |
Fuentes: la página del modelo Sonnet 5.5, el anuncio de lanzamiento de Anthropic y el changelog de GitHub. Contexto: qué cambió con Sonnet 5 y los precios por token en distintos proveedores.
Si facturas en euros, $2/$10 son unos 1,7 y 8,5 euros por millón de tokens al cambio de esta semana, y en España la factura suma un 21 % de IVA, salvo inversión del sujeto pasivo para empresas con NIF-IVA intracomunitario. Sonnet 5.5 está en Amazon Bedrock, Google Cloud y Microsoft Foundry, y con zero data retention, algo que pesa en proyectos con datos europeos.
¿Qué tan cerca está Sonnet 5.5 de Opus 5.5 en la tabla de Anthropic?
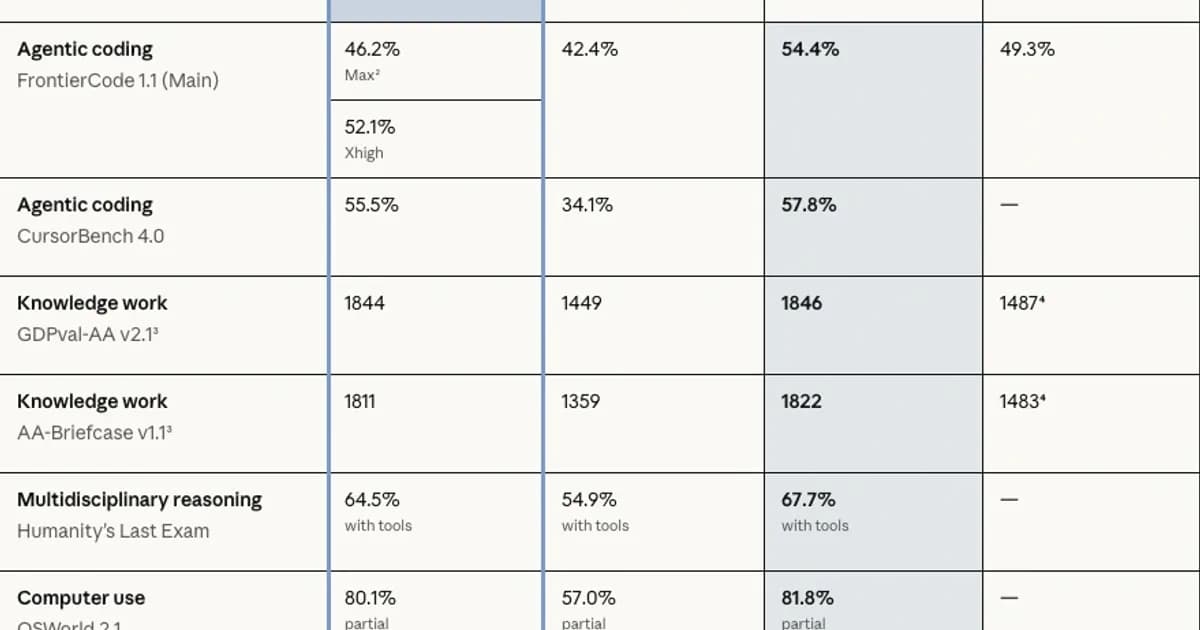
Sonnet 5.5 queda a menos de tres puntos de Opus 5.5 en cuatro de las seis filas en porcentaje, y su única victoria cae dentro del margen de error.
Celdas transcritas de la imagen de portada:
| Benchmark | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70,6 % | 10,3 % | 66,4 %¹ | n/a |
| FrontierCode 1.1 Main | 46,2 % (Max)², 52,1 % (Xhigh) | 42,4 % | 54,4 % | 49,3 % |
| CursorBench 4.0 | 55,5 % | 34,1 % | 57,8 % | n/a |
| GDPval-AA v2.1³ | 1844 | 1449 | 1846 | 1487⁴ |
| AA-Briefcase v1.1³ | 1811 | 1359 | 1822 | 1483⁴ |
| HLE (con herramientas) | 64,5 % | 54,9 % | 67,7 % | n/a |
| OSWorld 2.1 (parcial) | 80,1 % | 57,0 % | 81,8 % | n/a |
| Chartography (sin herramientas) | 61,6 % | 15,6 % | 64,4 % | 53,6 %⁴ |
¹ Opus con esfuerzo Xhigh. ² Max puntuó por debajo de Xhigh: lanzó más subagentes de revisión de código, que según Cognition provocaron timeouts o ediciones fuera de alcance en dos casos. ³ Ejecutado por Artificial Analysis sobre un despliegue previo al lanzamiento con un bug de salida estructurada, ya corregido. ⁴ Puede que no refleje un bug de imagen de GPT-6 Sol. Los gráficos de Terminal-Bench y CursorBench de Anthropic muestran GPT-5.6 Sol.
FrontierCode (Xhigh) y CursorBench quedan 2,3 puntos por detrás, OSWorld 1,7 y Chartography 2,8. HLE es la excepción, con 3,2. Las filas de Elo están separadas por 2 y 11 puntos.
Esa fila de Terminal-Bench alimenta el hilo de r/ClaudeCode «Sonnet 5.5 beats Opus 5.5 at coding and it's half the price??». La system card da errores estándar de ±2,5 y ±2,6 puntos, así que la brecha de 4,2 puntos son unos 1,2 errores estándar combinados, y además Sonnet corrió en max mientras Opus lo hizo en xhigh. Artificial Analysis midió a Sonnet 5.5 en un 64 % en la misma prueba. La mayor ventaja de Opus no está en la página de lanzamiento: SWE-Bench Pro, 81,3 frente a 89,9.
GPT-6 Sol es solo la columna que imprimió Anthropic; para ver cómo se compara GPT-6 Astra con Opus 5.5, mira nuestra prueba a tres bandas.
¿Sobrevive el ahorro del 30 % de Anthropic a 19 llamadas a la API?
Solo en la tarea larga: un 11,1 % más barato en una tarea de HTML con una media de 2.564 tokens de salida, y entre un 10 % y un 13 % más caro en dos tareas mínimas.
El 29 de septiembre a las 14:25 UTC enviamos 19 llamadas evaluadas por OpenRouter a Sonnet 5.5 y a Sonnet 5: 3 tareas, 3 pruebas, 2 modelos, más una llamada extra con esfuerzo alto. Factura total: $0.183434. Las 18 llamadas emparejadas pasaron.
# sonnet55_bench.py, 29 Sep 2026, POST https://openrouter.ai/api/v1/chat/completions
body = {
    "model": model,        # anthropic/claude-sonnet-5.5 or anthropic/claude-sonnet-5
    "messages": messages,
    "max_tokens": max_tokens,         # 12000 on the HTML task
    "reasoning": {"effort": effort},  # low: invoice, merge_intervals; medium: HTML
}
Ningún LLM calificó nada. La factura (800k tokens de lectura de caché, 200k de entrada, 50k de salida) tenía que devolver exactamente 1.06, merge_intervals ejecutó 6 asserts, y el HTML necesitaba doctype, canvas, requestAnimationFrame y ningún script externo. Los costes son usage.cost sumado en 3 pruebas.
| Tarea (esfuerzo) | Sonnet 5.5 | Sonnet 5 | Diferencia | Tokens de salida (media) | Latencia (media) |
|---|---|---|---|---|---|
| Factura (low) | $0.002754 | $0.002442 | +12,8 % | 71 / 61 | 2,63 s / 4,49 s |
| merge_intervals (low) | $0.006054 | $0.005502 | +10,0 % | 172 / 154 | 3,06 s / 3,68 s |
| HTML de 150 pájaros (medium) | $0.077508 | $0.087156 | -11,1 % | 2.564 / 2.886 | 15,54 s / 21,61 s |
| Total emparejado | $0.086316 | $0.0951 | -9,2 % | n/a | n/a |
Anthropic promete «hasta un 30 % menos por tarea que su predecesor». Matthias Bastian, de The Decoder, añadió la advertencia adecuada: «Las pruebas independientes aún tienen que confirmar estas afirmaciones».
En nuestro medidor de 19 llamadas con esfuerzo low y medium, con una sola tarea larga, el ahorro fue del -11,1 % en el HTML y se invirtió a +12,8 % y +10,0 % en las tareas mínimas. Con el mismo precio de lista, todo ahorro es una cuestión de tokens, y en nuestras dos tareas más pequeñas Sonnet 5.5 escribió más tokens, no menos.
La velocidad aguantó mejor. La latencia del HTML bajó un 28,1 %, y el throughput subió de 133,5 a 165,0 tokens por segundo (+23,6 %): en la dirección correcta, algo por debajo del 30 %. Sonnet 5 además registró entre 54 y 63 tokens de razonamiento por llamada de factura; Sonnet 5.5 registró 0 en las 10 llamadas.
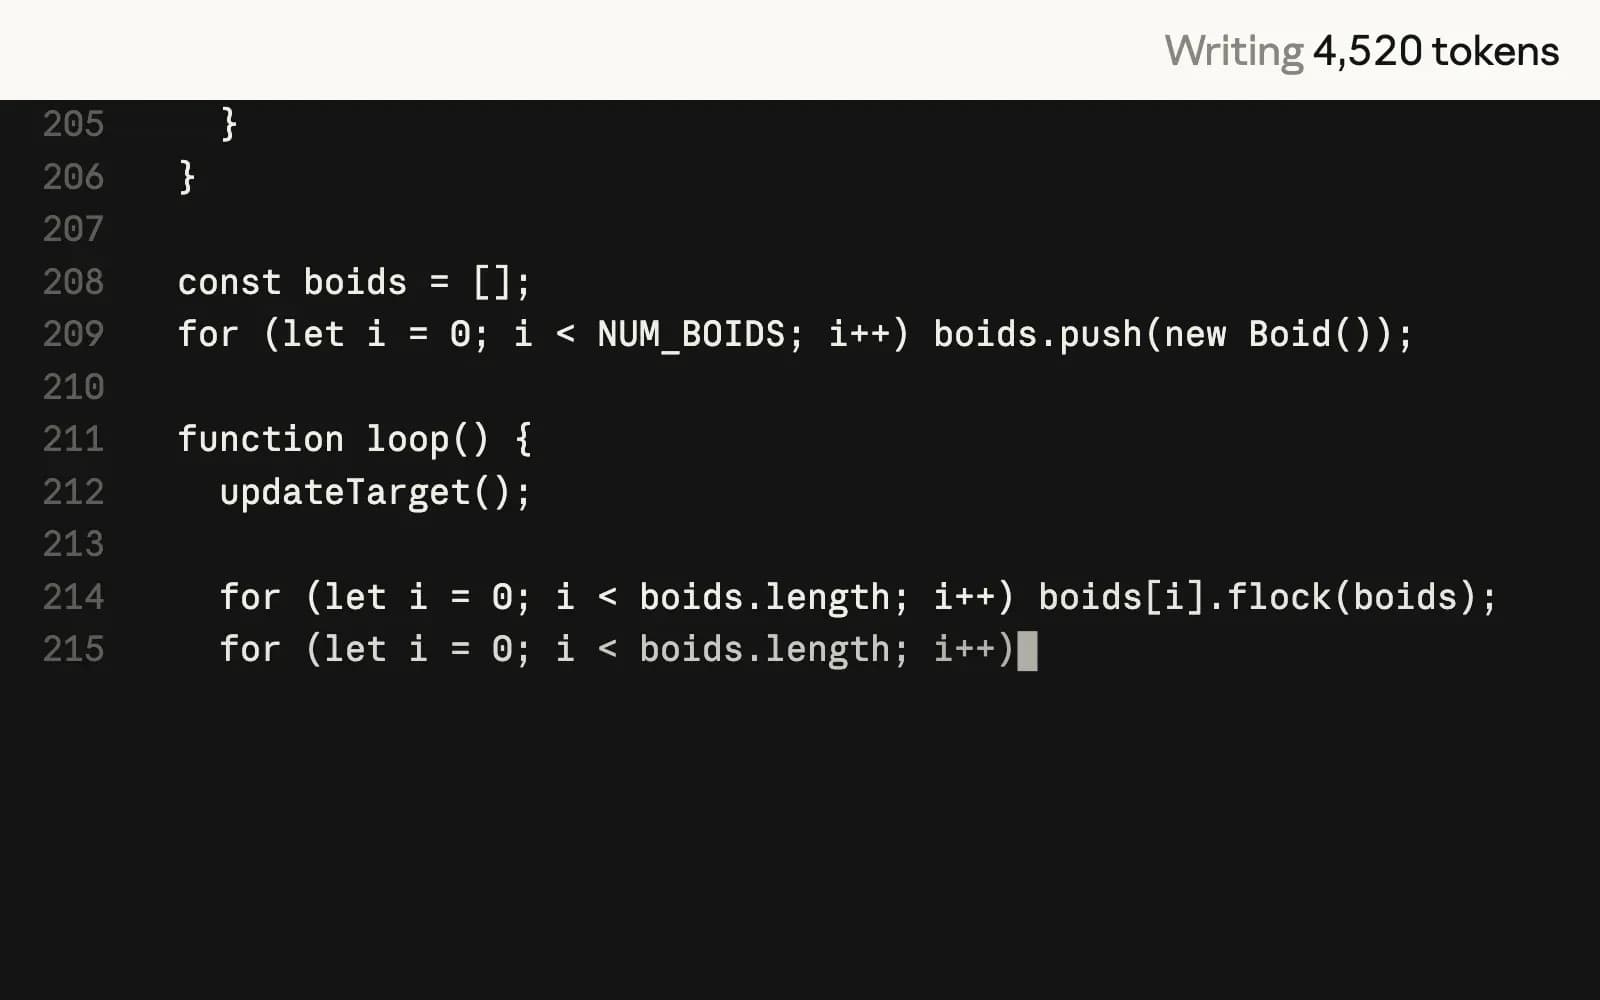
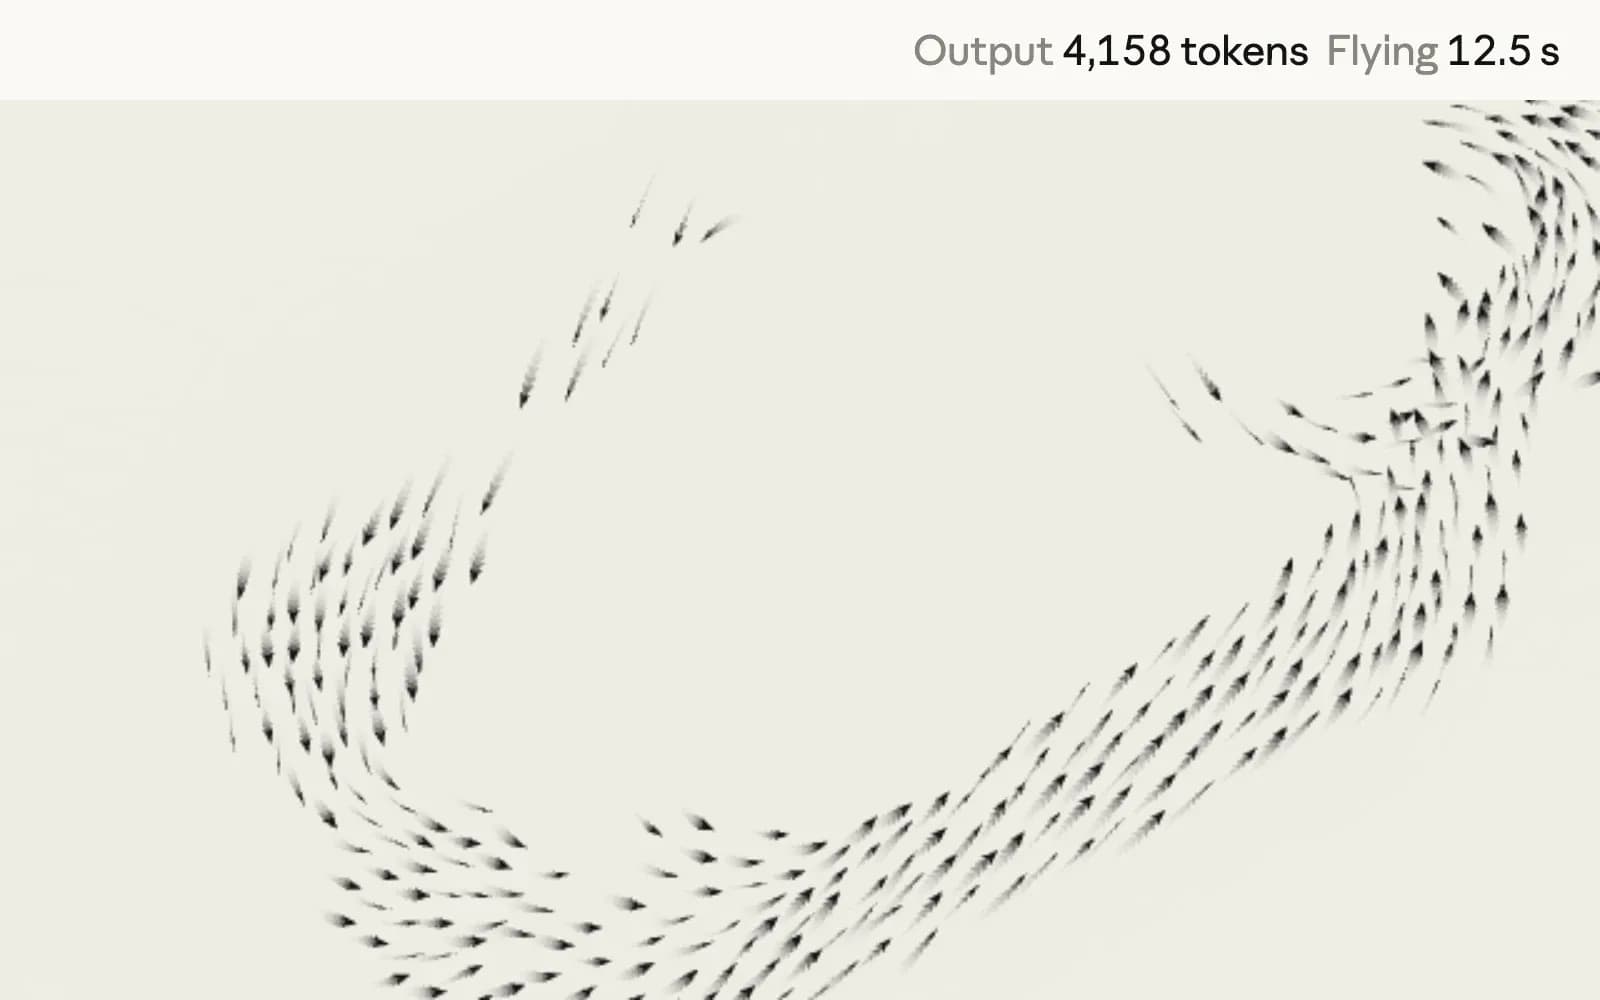
Esa tarea de HTML es una versión de 150 pájaros del prompt de demostración de 400 estorninos de la página de lanzamiento de Anthropic. Los fotogramas de abajo son la grabación de Anthropic, no nuestra ejecución.
Qué contaron los testers del lanzamiento de Anthropic
«Sin cambiar ninguno de nuestros prompts, Claude Sonnet 5.5 rindió mejor que Sonnet 5 en casi todas nuestras evaluaciones offline de Slackbot, en menos pasos y con un 14 % menos de tokens de salida.» Curtis Allen, Principal Engineer, Slack
«El nuevo modelo gestionó decenas de miles de líneas de código para la arquitectura de los sistemas de juego, mantuvo respuestas ágiles, resolvió tareas de varias horas y entregó con instrucciones menos prescriptivas.» Daniel Vogel, Chief Operating Officer, Epic Games
Ambos testimonios los recopiló el proveedor y ambos describen trabajo largo y de varios pasos. Nuestras tareas mínimas fueron en sentido contrario.
Lo que no medimos: trabajo agéntico, los benchmarks de arriba, el fallback de ciberseguridad. Con 3 pruebas esto es una medición puntual; para hacer la tuya, lee usage en cada llamada.
¿Por qué el nivel de esfuerzo mueve la factura más que el modelo?
Artificial Analysis midió $0.59 por tarea en medium y $7.60 en max, un salto de 13x para 15 puntos de índice.
En max contó «~193k Output Tokens per Intelligence Index Task. This is the highest token use we have measured» (unos 193k tokens de salida por tarea del índice, el mayor uso de tokens que han medido).
| Esfuerzo | Coste por tarea (AA) | AA Intelligence Index | Puesto en AA, 29 sep |
|---|---|---|---|
| Low | $0.41 | 36 | 63 de 216 |
| Medium | $0.59 | 41 | 44 de 216 |
| High | $1.08 | 47 | 23 de 216 |
| Max | $7.60 | 56 | 3 de 216 |
Las filas salen de las páginas por nivel de esfuerzo de AA, consultadas el 29 de septiembre. El artículo de lanzamiento de AA decía que Sonnet 5.5 ocupaba el segundo puesto del índice; la página del modelo mostraba 56, puesto 3 de 216, ese mismo día. Max además costó «~50 % más que el Cost per Task de Sonnet 5».
Nuestra propia llamada con esfuerzo alto ignoró el ajuste: merge_intervals con effort=high costó $0.002018 por 172 tokens de salida, idéntico a low. El esfuerzo solo pesa en trabajos lo bastante grandes como para pensarlos, y ahí es donde empieza reducir el gasto en la API de LLM.
¿Qué devuelve un 400 tras cambiar el id del modelo?
Cualquier petición con el thinking desactivado falla; cámbialo a between_tools y mantén el esfuerzo en high o menos.
La guía de migración de Anthropic detalla el error:
# Before (Sonnet 5 habit): 400 invalid_request_error on claude-sonnet-5-5
thinking = {"type": "disabled"}
# '"thinking.type.disabled" is not supported for this model. Use
#  "thinking.type.between_tools" for the lowest thinking setting, ...'

# After: accepted at low / medium / high effort, 400 at xhigh / max
thinking = {"type": "between_tools"}
output_config = {"effort": "medium"} # fixed for the conversation under between_toolstool_choiceconanyotooldevuelve 400. Usaautomásstrict: true(máximo 20 herramientas strict), o soloautoen Amazon Bedrock.- Los bloques de thinking de Opus 5, Opus 5.5, Fable o Mythos se descartan en silencio; las cuentas creadas a partir del 31 de agosto de 2026 reciben un 400 si reenvían un bloque tras editar el historial. La mecánica coincide con el enlace de los bloques de thinking de Fable 5.1.
- Computer use requiere
computer_toolset_20260801en la API de Claude y en Google Cloud. - Las negativas indican una categoría de
stop_details, entre ellascyber,frontier_llm(«podría ayudar al desarrollo de modelos de IA competidores») yreasoning_extraction. - El fallback en el servidor (
fallbacks: "default", beta, solo en la API de Claude) reintenta con Sonnet 5 las negativascyberyfrontier_llm; según la system card, el 1,2 % de las peticiones de Terminal-Bench pasaron por fallback. - El mínimo de prompt cacheable baja a 512 tokens desde 1.024 (mínimos del prompt caching), y
/claude-api migrateen Claude Code aplica estos cambios.
Los equipos de seguridad se topan primero con el punto 4. Un comentarista de HN, johnmlussier, contó que, pese a estar en el Cyber Verification Program, «no puede usar Opus 5.5 ni Sonnet 5.5 para ningún trabajo de bounty autorizado». Anthropic dice que el programa ampliado llegará «pronto».
La misma lista de migración dice: «Vuelve a ejecutar tu barrido de esfuerzo y recalcula la línea base de costes». Hazlo antes de fiarte del 30 %.
Claude Sonnet 5.5 vs Opus 5.5: ¿cuál va como modelo por defecto?
Usa Sonnet 5.5 por defecto para programación acotada y llamadas de alto volumen; deja Opus 5.5 para el juicio abierto y para cualquier trabajo en esfuerzo max.
Sonnet cuesta en lista la mitad que Opus 5.5 ($4/$20), pero Artificial Analysis midió a Sonnet en max a $7.60 por tarea frente a $5.98 de Opus 5.5, un 27 % más.
| Señal | Sonnet 5.5 | Opus 5.5 | Gana |
|---|---|---|---|
| Entrada / salida por 1M | $2 / $10 | $4 / $20 | Sonnet, la mitad de precio |
| Lectura de caché / escritura de 5 min | $0.20 / $2.50 | $0.20 / $5 | Empate en lecturas |
| Mezcla con mucha caché (abajo) | $1.06 | $1.96 | Sonnet, 1,85x y no 2x |
| Coste por tarea en AA, esfuerzo max | $7.60 | $5.98 | Opus, un 27 % más barato |
| SWE-Bench Pro | 81,3 % | 89,9 % | Opus por 8,6 puntos |
Mix: 800k cache-read + 200k input + 50k output tokens
Sonnet 5.5: 0.8 x $0.20 + 0.2 x $2 + 0.05 x $10 = $0.16 + $0.40 + $0.50 = $1.06
Opus 5.5:   0.8 x $0.20 + 0.2 x $4 + 0.05 x $20 = $0.16 + $0.80 + $1.00 = $1.96
Ratio: 1.96 / 1.06 = 1.85x
El «aproximadamente 1,65×» de Aleksei Aleinikov depende de una mezcla que no detalla. Pon la tuya: cuanto mayor sea tu proporción de caché, menor será la ventaja de Sonnet.
La propia Anthropic dice: «Opus 5.5 sigue siendo claramente más fuerte en trabajo complejo y abierto que exige un juicio sostenido». Un comentarista de HN, datadrivenangel, fue más allá: «Opus 5.5 en Low parece más listo, más barato y más rápido que Sonnet en medium». Nosotros no lo probamos. Los precios y límites de Opus están en nuestro análisis de Opus 5.5.
Nuestro modelo por defecto desde el 29 de septiembre: claude-sonnet-5-5 con esfuerzo medium. Los trabajos en max van a Opus 5.5, porque en max Sonnet deja de ser el modelo barato.
Preguntas frecuentes
¿Cuándo salió Claude Sonnet 5.5?
Anthropic lanzó Claude Sonnet 5.5 el 28 de septiembre de 2026 como claude-sonnet-5-5, el mismo día en Amazon Web Services, Google Cloud, Microsoft Azure y GitHub Copilot. Según la documentación de Anthropic, no se retirará antes del 28 de septiembre de 2027.
¿Es Claude Sonnet 5.5 más barato que Sonnet 5?
No por token: ambos cuestan en lista $2 de entrada y $10 de salida. En nuestro medidor, una tarea larga de HTML costó un 11,1 % menos con Sonnet 5.5 y una tarea mínima de factura un 12,8 % más; en esfuerzo max, Artificial Analysis midió cerca de un 50 % más por tarea.
¿Puedo usar Sonnet 5.5 en Claude Code y en GitHub Copilot?
Sí. Claude Code lo usa por defecto con esfuerzo Medium; la API, con High. En GitHub Copilot, de Pro a Enterprise, se «factura a precio de lista del proveedor bajo facturación por uso». Para fijarlo, mira cómo cambiar de modelo en Claude Code.
¿Cuál es la ventana de contexto de Sonnet 5.5 y su fecha de corte de conocimiento?
Admite 1M de tokens de contexto y devuelve hasta 128K tokens de salida, con una fecha de corte de conocimiento fiable de junio de 2026 según la system card.
¿Existe un Haiku 5.5?
No a fecha de 29 de septiembre de 2026. Anthropic dijo el 28 de septiembre que Claude Haiku 5.5 «se unirá a la familia Claude 5.5 en las próximas semanas».