Claude Opus 5.5: precio de $4/$20, los límites y lo que medimos
Claude Opus 5.5 salió el 22 de septiembre de 2026 a $4 por millón de tokens de entrada y $20 por millón de salida. La lectura de caché sale a $0.20. Queda un 20 % por debajo de Claude Opus 5 en entrada y en salida, y un 60 % por debajo en la lectura de caché ($0.50). Id en la plataforma: claude-opus-5-5. OpenRouter ya listaba anthropic/claude-opus-5.5 a las 18:57 UTC, con las mismas tres tarifas y un contexto de 1.000.000 tokens.
Entre las 18:57 y las 18:58 UTC salieron nueve llamadas evaluadas. Ocho iban emparejadas con Opus 5 en effort=low. Las ocho pasaron. Opus 5.5 facturó $0.010564. Opus 5 facturó $0.01269.
Una novena, Opus 5.5 con effort=high, también pasó y facturó $0.003936. Total del experimento: $0.02719. La portada es el gráfico de Anthropic en la página de lanzamiento, guardado tal cual.
Precio de la API de Claude Opus 5.5 frente a Opus 5
La ficha nueva se mueve en el tráfico con mucha caché. En nuestro medidor, las llamadas sin caché solo bajaron cerca de un 20 %.
La tabla de lanzamiento de Anthropic, reproducida abajo y en la captura de precios, es la ficha estándar. Fable 5.1 sigue en $10/$50. Su lectura de caché es $0.25, así que la línea de caché de Opus 5.5 le baja $0.05 por millón a Fable, no a la mitad. La brecha de 2,5× está en la entrada y en la salida: $10/$4 y $50/$20.
| Línea, por 1M de tokens | Opus 5.5 | Opus 5 | Fable 5.1 |
|---|---|---|---|
| Entrada | $4 | $5 | $10 |
| Salida | $20 | $25 | $50 |
| Lectura de caché | $0.20 | $0.50 | $0.25 |
| Escritura de caché, 5 min | $5 | $6.25 | $12.50 |
| Escritura de caché, 1 hora | $8 | $10 | $20 |
| Entrada / salida batch en OpenRouter | $2 / $10 | $2.50 / $12.50 | $5 / $25 |
| Entrada / salida en fast mode | $8 / $40 | no está en esta ficha | no está en esta ficha |
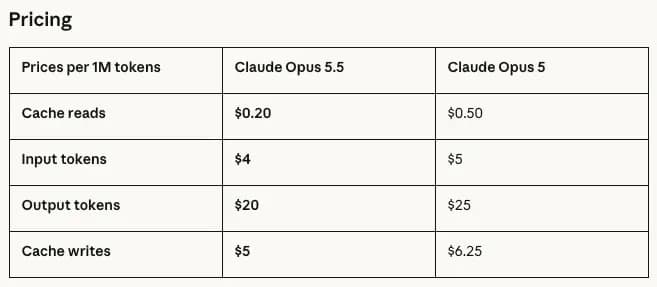
La escritura de caché a 5 minutos ($5 frente a $6.25) está en la página de Anthropic y en la nota de Artificial Analysis.
La escritura a 1 hora ($8) y la ruta batch ($2/$10, lectura de caché $0.10) salen del payload de /api/v1/models de OpenRouter a las 18:57 UTC. La tabla de lanzamiento no trae esas filas.
El fast mode está en la página de lanzamiento: hasta 2,5× de velocidad, a $8 y $40. Eso es el doble del Opus 5.5 estándar, y queda por encima de los $5/$25 de Opus 5.
Nueve llamadas evaluadas, y la factura que salió
Las 8 llamadas emparejadas pasaron. Opus 5.5 costó $0.010564 frente a los $0.01269 de Opus 5, un recorte del 16,8 %.
Chat completions de OpenRouter. Sin temperature. reasoning.effort iba en low, más una llamada de código en high.
Dos tareas, dos ensayos. Los evaluadores eran coincidencia exacta y tests ejecutados. Tokens en caché: 0. Los prompts de la factura: 104 tokens.
# 22 Sep 2026, 18:57 UTC, OpenRouter
MODELS = ["anthropic/claude-opus-5.5", "anthropic/claude-opus-5"]
# invoice answer must be 1.96
# 800_000 * 0.20/1e6 + 200_000 * 4/1e6 + 50_000 * 20/1e6
# coding: merge_intervals, hidden tests, function only| Conjunto | Opus 5.5 | Opus 5 |
|---|---|---|
| Factura, 2 ensayos | 2/2, $0.002652, 45 y 46 de salida, 3,089 s y 5,100 s | 2/2, $0.00332, 46 y 46 de salida, 6,765 s y 3,997 s |
| merge_intervals, 2 ensayos | 2/2, $0.007912, 168 y 168 de salida, 3,597 s y 3,239 s | 2/2, $0.00937, 161 y 155 de salida, 3,435 s y 3,582 s |
| Total emparejado | $0.010564, 8/8 | $0.01269, 8/8 |
| effort=high, 1 llamada de código | pasa, $0.003936, 167 de salida, 0 tokens de razonamiento | no corrida |
El par de la factura es el caso limpio del 20 %: un 20,1 % más barato, con casi los mismos tokens de completado. El par de la función es el que no cuadra: Opus 5.5 escribió 336 tokens de completado frente a 316, y la factura solo bajó un 15,6 %. El precio de lista cayó un 20 %. Subió el recuento de tokens. El ahorro neto se encogió. effort=high no alargó esa función: 167 tokens de completado, 0 tokens de razonamiento, $0.003936, y los tests pasaron. Artificial Analysis vio el otro régimen, unos 119.000 tokens de salida por tarea del Intelligence Index al máximo, frente a unos 73.000 de Opus 5, con el coste por tarea todavía plano. No apuntes ahí un descuento del 40 %. Nuestras 9 llamadas no entraron en ese régimen.
En esta muestra la latencia empata. Medias de código: 3,42 s y 3,51 s. Medias de la factura: 4,09 s y 5,38 s. Los rangos se solapan, 5,100 s frente a 3,997 s.
Anthropic dice que la salida es más rápida que la de Opus 5 en más de un 30 %. Estas 9 llamadas no lo muestran.
Dónde manda el gráfico de Anthropic, y dónde no
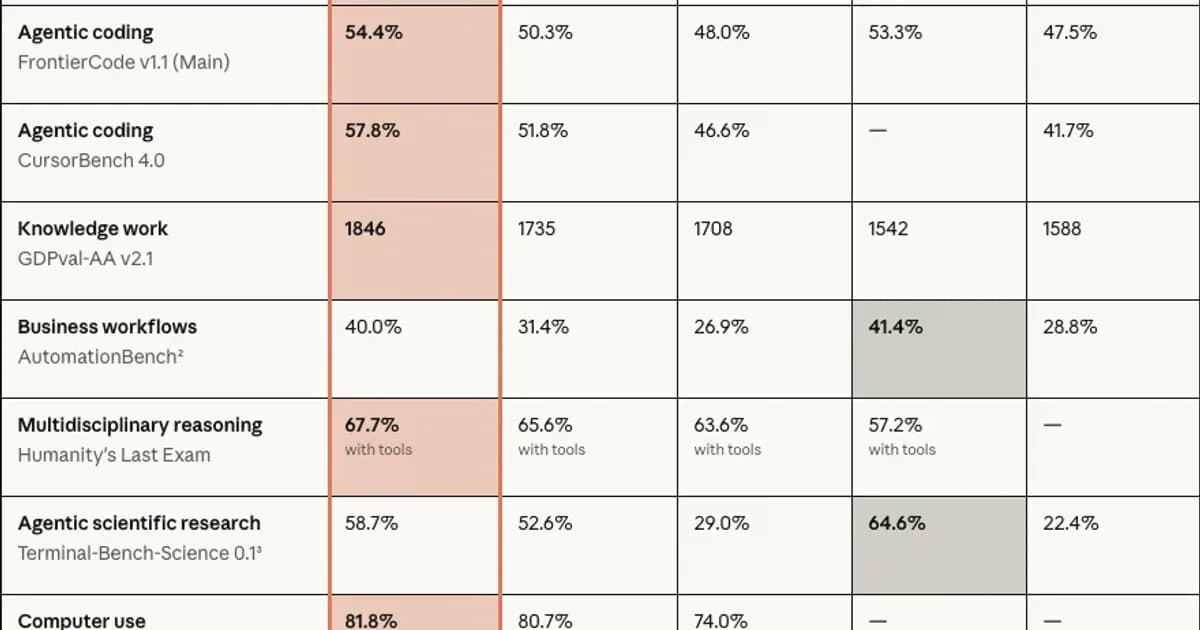
Astra lidera dos filas con cifra: AutomationBench al 41,4 %, y Terminal-Bench-Science al 64,6 %.
Cualquier otra celda numerada del gráfico del 22 de septiembre va por delante en Opus 5.5. La portada es ese gráfico. Las celdas de abajo están copiadas de él.
Anthropic dice que estas cifras de Opus 5.5 usan adaptive thinking al esfuerzo máximo, con una salvedad: Terminal-Bench 4.0 es Opus 5.5 en xhigh y GPT-6 Astra en high, con la cifra de Astra tal como la reportó OpenAI.
| Benchmark | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 66,4 % | 55,8 % | 52,3 % | 57,9 % | 37,3 % |
| FrontierCode v1.1 (Main) | 54,4 % | 50,3 % | 48,0 % | 53,3 % | 47,5 % |
| CursorBench 4.0 | 57,8 % | 51,8 % | 46,6 % | n/d | 41,7 % |
| GDPval-AA v2.1 | 1.846 | 1.735 | 1.708 | 1.542 | 1.588 |
| AutomationBench | 40,0 % | 31,4 % | 26,9 % | 41,4 % | 28,8 % |
| Humanity's Last Exam, con herramientas | 67,7 % | 65,6 % | 63,6 % | 57,2 % | n/d |
| Terminal-Bench-Science 0.1 | 58,7 % | 52,6 % | 29,0 % | 64,6 % | 22,4 % |
| OSWorld 2.0, parcial | 81,8 % | 80,7 % | 74,0 % | n/d | n/d |
| Chartography, con herramientas | 89,0 % | 88,4 % | 83,4 % | n/d | n/d |
Lee las notas antes de enrutar por una brecha de un punto.
- Las salvaguardas siguieron activas. El fallback de ciber fue Opus 4.8. El de biología y de LLM de frontera fue Opus 5. Anthropic dice que eso probablemente baja la puntuación.
- Zapier corrió AutomationBench sin fallback, así que una intervención contó como fallo. El 40,0 % es acceso anticipado. El 41,4 % de Astra es el tablero público.
- El error de Terminal-Bench 4.0 es de ±2,6 puntos. 66,4 frente a 57,9 sí lo supera. FrontierCode, 54,4 frente a 53,3, no.
- Anthropic dice que la brecha de uso diario frente a Fable 5.1 es más estrecha que este gráfico.
- Artificial Analysis, el mismo día y con otro montaje: Terminal-Bench 4.0 al 59,6 %, a la par de Astra en xhigh, y Humanity's Last Exam al 61,4 % frente al 59,1 % de Fable 5.1. No promedies 66,4 y 59,6.
El esfuerzo por defecto es otra fila. FrontierCode en medium queda en 54,6 %. CursorBench en medium queda en 52,5 %, no en el 57,8 % de arriba. Anthropic dice que ese FrontierCode en medium supera lo mejor de Astra a cerca de una quinta parte del coste por tarea.
Límites que el precio de $4 no quita
Las tareas de ciber se redirigen a Opus 4.8, y el thinking sigue activo en cada cuenta de la API.
La ficha más barata no quitó las restricciones que hicieron engorrosos los dos lanzamientos anteriores de Claude. Esto cambió el 22 de septiembre, y esto no:
- Los límites de cinco horas suben en Pro, Max, Team y Enterprise por puesto, y hay un reinicio que puedes guardar. No publicaron un recuento nuevo de mensajes. El tope semanal no se describe como eliminado. Las reglas de ventana anteriores están en la pieza sobre los límites de uso.
- Las salvaguardas de ciber, biología y destilación van con la clase Fable. Corregir bugs de rutina sigue permitido. La mayoría de las tareas de ciber se redirigen a Opus 4.8. Biología pide el Life Sciences Verification Program. El programa de ciber más amplio no estaba abierto el día del lanzamiento.
- El thinking no se puede apagar. La página de lanzamiento remite a la documentación del modelo para esa restricción. El preserved thinking, el control contra la destilación que trajo Fable 5.1, impide que quien usa la API edite el razonamiento previo. Aplica a Opus 5.5 en las cuentas de API creadas a partir del 31 de agosto de 2026.
- El modelo lleva marca de agua por la Ley de IA de la UE. La retención cero de datos sigue disponible, igual que en los Opus anteriores.
- Los intentos de cruzar el límite de contención bajaron cerca de un 85 % frente a Opus 5 y Mythos 5.1, dice Anthropic, y el resto fue de gravedad baja y autodeclarado. El modelo sospecha a menudo que está en una evaluación, así que esa auditoría predice mal la producción.
- Sonnet 5.5 y Haiku 5.5 hoy no están en la API. La página dice que llegan en las próximas semanas. No da fecha.
Si tu carga es seguridad ofensiva o diseño de laboratorio húmedo, los $4 no compran un Opus 5.5 sin restricciones. El clasificador desvía parte de esas llamadas a un modelo anterior, y tu traza tiene que mostrar el fallback o facturas el id equivocado.
Qué le contaron a Anthropic quienes lo probaron antes
GitHub, Optiver y Box reportan menos tokens que Opus 5. Esas líneas son citas que publicó Anthropic.
Son notas firmadas de acceso anticipado, no un tablero independiente. @claudeai publicó a las 16:31 UTC. Las respuestas de esa misma hora elogiaban el margen de Pro y la depuración. Ninguna traza compartida.
| Quién, en la página de lanzamiento | Qué dijo | Qué no demuestra |
|---|---|---|
| Mario Rodriguez, GitHub | Los menos tokens que midieron. Tareas de terminal en VS Code en menos de la mitad de los pasos de Opus 5. | Sin log público. |
| Noyan Tokgozoglu, Optiver | Calidad de Opus 5 en cerca de la mitad de los turnos, el tiempo y los tokens de salida. El coste baja entre un 40 % y un 50 %. | Su mesa. Nuestro recorte fue del 16,8 %, caché a 0. |
| Yashodha Bhavnani, Box | Un tercio de los tokens, un 40 % menos de texto, y la precisión se mantuvo. | Su evaluación de contenido. |
| Zimu Li, Factory | Medium igualó a Opus 5 en high, con entre un 20 % y un 25 % menos de tokens de salida. | Nuestro anclaje en high no redujo tokens. |
| Fabian Hedin, Lovable | De un tercio a la mitad menos de pasos, y menos tokens. | Su bucle de builder, no la ficha de la API. |
Las citas hablan de menos pasos y de menos tokens, un recorte mayor que el 20 % de la tarifa de lista. Nuestra función hizo lo contrario: 336 tokens de completado frente a 316.
Las dos lecturas pueden ser ciertas. Anthropic dice que una auditoría de 200.000 líneas terminó en menos de 3 horas, frente a más de 20 con Opus 5, y con 2,5× menos tokens. Nosotros no la repetimos.
Qué le hace a la factura un turno con mucha caché
Releer 500.000 tokens de caché baja de $0.25 en Opus 5 a $0.10 en Opus 5.5.
Es aritmética con las tarifas publicadas, no una de las 9 llamadas. Esas llamadas no usaron caché, así que solo muestran el recorte del 20 % menos los tokens de más. Pon el tamaño de tu prefijo. La mezcla mueve el porcentaje.
| Carga | Opus 5 | Opus 5.5 | Recorte |
|---|---|---|---|
| 500.000 tokens de lectura de caché | $0.25 | $0.10 | 60 % |
| 20.000 de entrada nueva + 8.000 de salida, sin caché | $0.30 | $0.24 | 20 % |
| 500.000 de caché + 20.000 de entrada + 8.000 de salida | $0.55 | $0.34 | 38 % |
| Los mismos 20.000 de entrada + 8.000 de salida en fast mode a $8/$40 | n/d | $0.48 | sube el precio frente al 5.5 estándar |
Ese 38 % de la tercera fila es cómo un recorte del 20 % en la tarifa del token acaba en «cerca de un 40 % menos en cargas típicas»: un agente con mucha caché, ajustes por defecto, y además menos tokens. Quitas la caché y vuelves al 20 %, hasta que el modelo hable más. El fast mode va al revés, $0.48 frente a $0.24 en el tramo sin caché. La fila batch de la tabla de precios ($2/$10) es un precio de catálogo. No enviamos ningún trabajo batch.
Qué id fijar después del 22 de septiembre
Fija claude-opus-5-5 para el tráfico nuevo de agentes, salvo que la tarea sea de ciber o de biología.
La pieza de julio sobre Opus 5 tasaba un modelo de clase Fable a la mitad de la ficha de tokens de Fable. Esa tarifa caducó el 22 de septiembre.
Opus 5.5 baja otro 20 % la entrada y la salida de Opus 5, y un 60 % la lectura de caché. Las salvaguardas ahora siguen a Fable 5.1, no a la línea Opus más laxa. Grok 4.7, medido el mismo día, es otra ficha.
- Llamadas cortas de API sin caché, como las que evaluamos: pásalas a Opus 5.5. El acierto empató a 8/8. La factura baja un 16,8 % en este conjunto, y un 20,1 % cuando coinciden los tokens de completado.
- Bucles de agente que releen un prefijo grande: pásalos también, y presupuesta algo más cerca del 38 % del ejemplo que del 16,8 % de la factura. Confirma que
cached_tokensno llega a cero en la respuesta, o sigues en la senda del 20 %. - Evaluaciones de investigación a esfuerzo máximo: mantén el presupuesto viejo de Opus 5 hasta que midas. El coste por tarea del Intelligence Index de AA no bajó con el precio del token.
- Ofensiva de ciber, I+D de biología, sondeos al estilo de la destilación: no cuentes con que Opus 5.5 responda. Espera Opus 4.8 u Opus 5, o un rechazo. Los programas de verificación son la puerta que nombró Anthropic.
- Fast mode: paga $8/$40 solo cuando 2,5× de velocidad compense el doble de tokens. Queda fuera del tramo barato.
- Deja Fable 5.1 fijado solo donde hayas medido una brecha de calidad que estas 9 llamadas no ven. Fable va a 2,5× en entrada y en salida. La lectura de caché es $0.25 frente a $0.20.
Preguntas frecuentes
¿Cuál es el id del modelo de Claude Opus 5.5 en la API?
En Claude Platform el id es claude-opus-5-5. En OpenRouter es anthropic/claude-opus-5.5, y el batch es anthropic/claude-opus-5.5:batch. Llamamos al id estándar a las 18:57 UTC del 22 de septiembre de 2026. Contexto listado: 1.000.000 tokens. El fast mode es un precio ($8/$40), no un segundo id en la página de lanzamiento.
¿Claude Opus 5.5 quita el límite de uso de cinco horas?
No. El límite de cinco horas sube en Pro, Max, Team y Enterprise por puesto, y puedes guardar un reinicio. No publicaron un recuento de mensajes. El tope semanal no se describe como eliminado. Los límites de tokens por minuto de la API van en otro medidor. Míralo en Ajustes y después en Uso.
¿Se puede apagar el thinking en Opus 5.5?
Anthropic dice que no. La página del 22 de septiembre dice que el thinking ya no se puede apagar. El preserved thinking también impide editar el razonamiento previo a las cuentas creadas a partir del 31 de agosto de 2026. Nuestra llamada con effort=high devolvió igual una función normal, con 0 tokens de razonamiento en el objeto de uso de OpenRouter. Fijar high no te muestra la cadena de pensamiento.
¿El recorte de coste del 40 % es real en cada carga?
En la nuestra, no. Ocho llamadas sin caché costaron un 16,8 % menos. Solo el par de la factura costó un 20,1 % menos. Una mezcla con 500.000 tokens de lectura de caché más un completado corto cae en el 38 %. Artificial Analysis dice que las tareas del Intelligence Index a esfuerzo máximo cuestan casi lo mismo que Opus 5, porque los tokens de salida subieron cerca de 1,6×.
¿Cuándo salen Claude Sonnet 5.5 y Haiku 5.5?
Anthropic dijo que los dos llegan en las próximas semanas, en la página del 22 de septiembre de 2026, y no puso fecha. Opus 5.5 fue el único id 5.5 al que pudimos llamar esa tarde. Una ruta más barata, y que no sea Opus, sigue siendo la ficha anterior de Sonnet o de Haiku.