GPT-6 Astra vs Claude Opus 5.5 vs Grok 4.7: factura, GDPval y un medidor de seis llamadas
GPT-6 Astra, Claude Opus 5.5 y Grok 4.7 se podían llamar en OpenRouter a las 22:34 UTC del 22 de septiembre de 2026. Seis llamadas evaluadas, dos tareas, un ensayo cada una: las seis pasaron. La factura del gateway quedó en $0.01626.
Los gráficos de lanzamiento no cuadran.
El marcador de Anthropic tiene a Astra y no a Grok. El de xAI tiene a Fable 5.1 y a Sol, y coloca a Astra en un gráfico de Elo. Esta página se queda con las anclas compartidas y se detiene donde las escalas ya no miden lo mismo.
El corte de Opus 5.5 frente a Opus 5 sigue en el post de Opus 5.5. La subida de 4.7 frente a 4.6 sigue en el post de Grok 4.7. Astra frente a Fable sigue en el post de GPT-6 Astra.
Tres fichas, y el tamaño del prompt que les cambia el precio
El token de Astra cuesta 2,5× el de Opus 5.5 en entrada y en salida, y 5× en lecturas de caché. La ficha de xAI para Grok deja la entrada a la mitad y la salida a 0,3×, hasta que el prompt pasa de 200.000 tokens.
Opus 5.5 es el 1× de la comparación: $4, $20 y $0.20 por millón.
La ficha de Astra marca $10, $50 y $1.00. La ficha de Grok del 21 de septiembre es $2, $6 y $0.50 por debajo de 200.000 tokens de prompt.
| Línea, por 1M de tokens, por debajo del salto | Opus 5.5 | GPT-6 Astra | Grok 4.7, ficha de xAI |
|---|---|---|---|
| Entrada | $4 | $10 | $2 |
| Salida | $20 | $50 | $6 |
| Lectura de caché | $0.20 | $1.00 | $0.50 |
| Contexto | 1.000.000 | 1.050.000 | 500.000 |
| Salto | sin salto en esta ficha | 272.000 tokens de prompt: entrada y caché a 2×, salida a 1,5× | 200.000 tokens de prompt: toda la petición pasa a $4 / $12 / $1 |
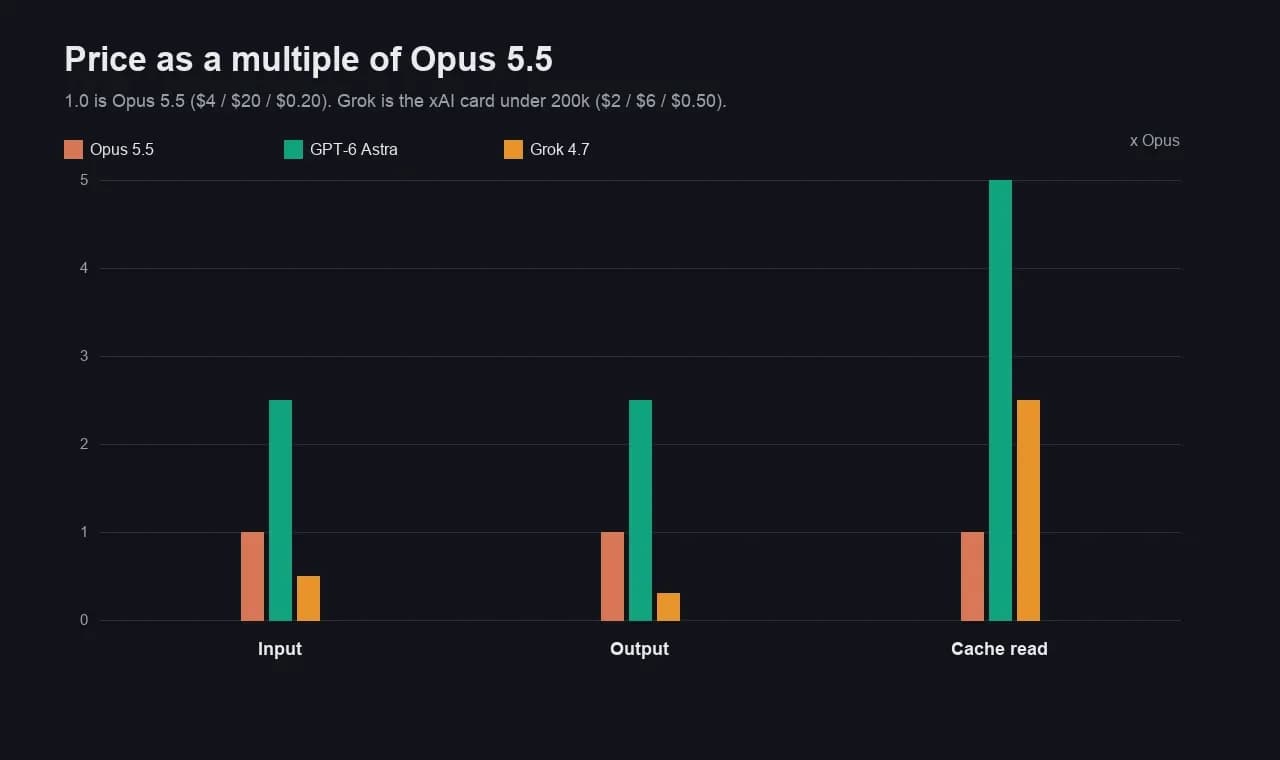
A las 22:34 UTC, OpenRouter igualaba la ficha de Opus y la de Astra. La de Grok, no.
El listado marcaba $1.60, $4.80 y $0.40, y a partir de 200.000 tokens de prompt pasaba a $3.20, $9.60 y $0.80. Eso es 0,8× la ficha de xAI. Nuestras cifras de usage.cost salen de ese catálogo. El post de Grok 4.7 sigue tasando la ficha propia de xAI en $2 y $6.
Releer 500.000 tokens de caché, solo aritmética: Opus $0.10, Astra $0.25 y la línea de caché de xAI para Grok $0.25. Astra sale caro en la caché. En la salida, los $6 de Grok contra los $50 de Astra son 8,3×, y contra los $20 de Opus son 3,3×.
Seis llamadas evaluadas, y la factura que envió cada modelo
Las seis pasaron. Las dos llamadas de Grok costaron $0.0038784, Opus 5.5 costó $0.005292 y Astra costó $0.00709.
La respuesta de la factura tenía que ser 1.96. merge_intervals tenía que pasar los tests ocultos, también los de rangos que se tocan.
Los tokens en caché fueron 0 en Opus y en Astra. Grok devolvió 1.152 tokens en caché en las dos llamadas, dentro de prompts de 1.310 y 1.336 tokens. 295 de los 298 tokens de salida de la factura eran de razonamiento.
# 22 Sep 2026, 22:34 UTC, OpenRouter, one trial, max_tokens 1800
MODELS = [
    "anthropic/claude-opus-5.5",
    "openai/gpt-6-astra",
    "x-ai/grok-4.7",
]| Tarea | Opus 5.5 | GPT-6 Astra | Grok 4.7 |
|---|---|---|---|
| Factura, tiene que ser 1.96 | pasa, $0.001336, 46 de salida, 4,277 s | pasa, $0.00263, 38 de salida, 2,116 s | pasa, $0.002144, 298 de salida, 5,292 s |
| merge_intervals | pasa, $0.003956, 168 de salida, 3,307 s | pasa, $0.00446, 69 de salida, 2,588 s | pasa, $0.0017344, 204 de salida, 4,217 s |
| Total de las dos tareas | $0.005292 | $0.00709 | $0.0038784 |
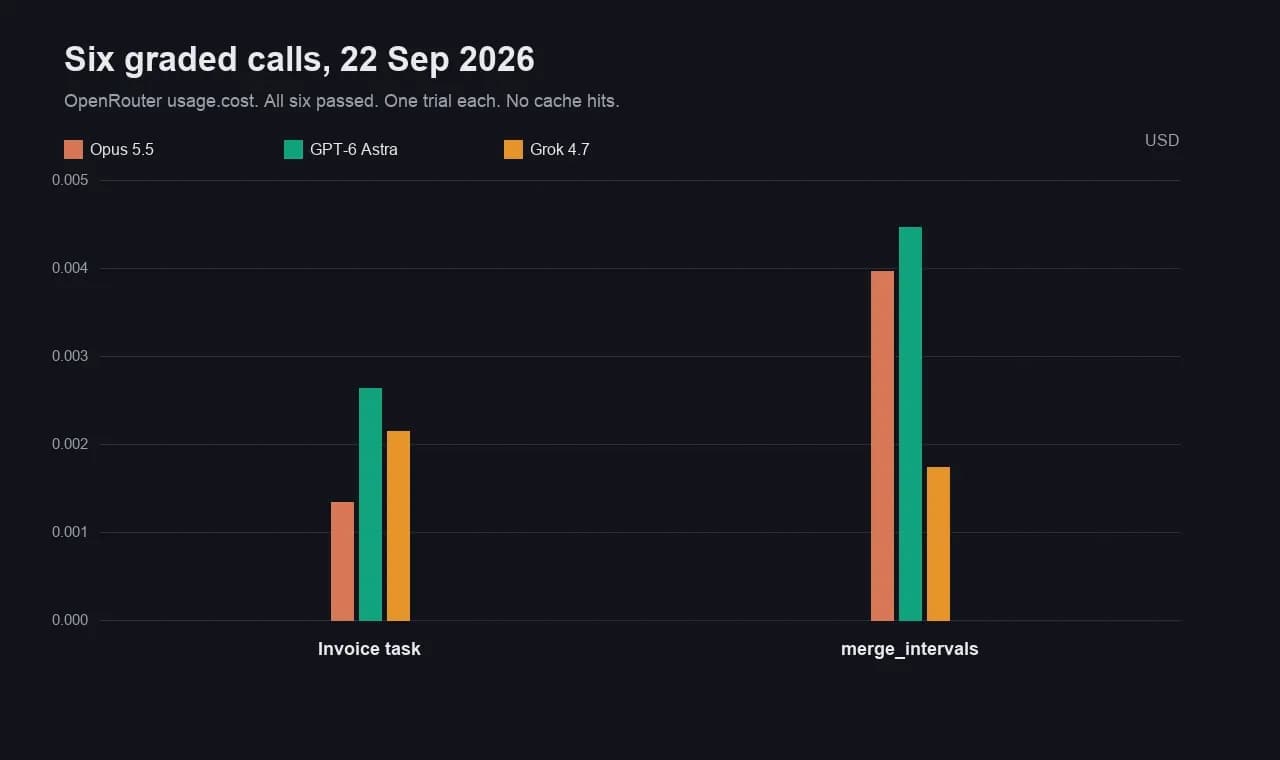
Astra escribió menos tokens que los otros dos y envió la factura más alta.
38 y 69 tokens de completado, contra 46 y 168 de Opus. La ficha de $10/$50 se comió el ahorro. Esas dos cifras de usage.cost cuadran con $10 y $50 exactamente. Opus cuadra con $4 y $20.
Grok perdió la factura y ganó la función. 204 tokens a $4.80 quedaron en $0.0017344.
Astra fue el más rápido en las dos pasadas: 2,116 s y 2,588 s. Un ensayo no arma un ranking de velocidad.
La pieza de Astra del 4 de septiembre decía que openai/gpt-6-astra devolvía HTTP 400. Eso era cierto a las 14:40 UTC de ese día. En esta pasada ya no lo era. El id se resolvió, la llamada devolvió 1.96 y los tests pasaron.
GDPval es la fila que los dos laboratorios sí comparten
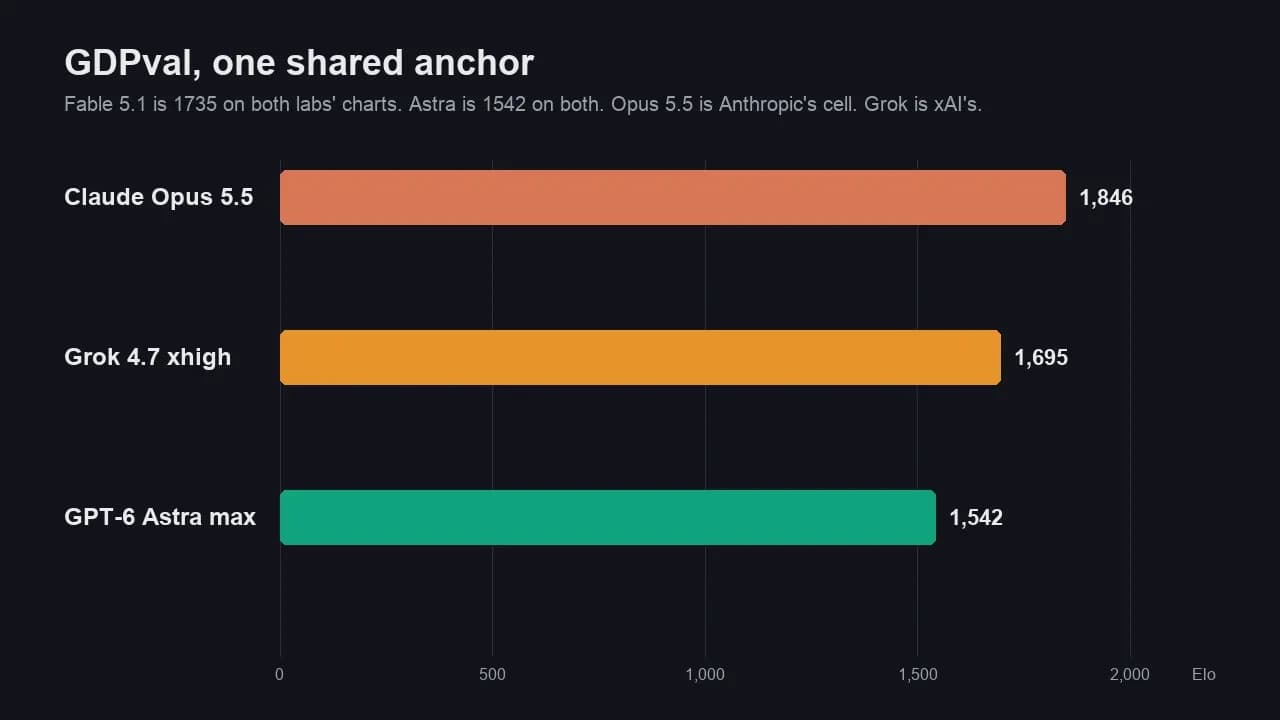
Opus 5.5 lidera esa fila compartida con 1.846. Grok 4.7 en xhigh marca 1.695. Astra max marca 1.542.
Fable 5.1, con 1.735, hace de ancla y no entra como cuarto modelo.
Anthropic imprime 1.735, Astra en 1.542 y Opus 5.5 en 1.846. xAI imprime los mismos 1.735 y 1.542, y Grok 4.7 xhigh en 1.695. Las barras comparten eje porque esos dos números están en las dos páginas.
| Celda | Puntuación | Quién la imprimió |
|---|---|---|
| Claude Opus 5.5 | 1.846 | Anthropic, 22 de septiembre de 2026, GDPval-AA v2.1 |
| Grok 4.7 xhigh | 1.695 | Gráfico de lanzamiento de xAI, 21 de septiembre de 2026, GDPval |
| GPT-6 Astra max | 1.542 | Los dos gráficos |
| Fable 5.1 max, solo como ancla | 1.735 | Los dos gráficos |
Opus queda 151 Elo por encima de Grok y 304 por encima de Astra. Grok queda 153 por encima de Astra y 40 por detrás del ancla de Fable. Nada de eso lo medimos nosotros. Nuestras seis llamadas fueron una factura de dos decimales y una función de merge. No miden trabajo de oficina.
Artificial Analysis puso a Opus 5.5 en 58 en su Intelligence Index a esfuerzo máximo, y dijo que el coste por tarea se mantuvo al nivel de Opus 5 porque los tokens de salida subieron cerca de 1,6×. Su nota de Grok 4.7 puso a ese modelo en 46 en el mismo índice. Otra escala, la misma dirección: Opus va por delante de Grok, y eso no justifica ignorar la factura de tokens.
Terminal-Bench y CursorBench no son la misma escala
No promedies el 66,4 % de Anthropic con el 38,0 % de xAI. No son la misma celda de Terminal-Bench.
- Anthropic, con Opus 5.5 en xhigh y Astra en high tal como lo publicó OpenAI: Terminal-Bench 4.0 da 66,4 % a Opus 5.5 y 57,9 % a Astra. Fable 5.1 está en 55,8 % en esa página. CursorBench 4.0 da 57,8 % a Opus 5.5 y 51,8 % a Fable. La celda de CursorBench de Astra está en blanco.
- Marcador de xAI: Terminal-Bench 4.0 da 38,0 % a Grok 4.7 xhigh y 57,9 % a Fable 5.1 Max. CursorBench da 46,3 % a Grok y 51,8 % a Fable. Astra no está en ese marcador. La celda de CursorBench de Fable, 51,8 %, coincide con Anthropic. La de Terminal-Bench, no: 57,9 % allí y 55,8 % en la página de Anthropic.
- Artificial Analysis, un tercer setup: Opus 5.5 marca 59,6 % en Terminal-Bench 4.0, al nivel de Astra en xhigh. En la pasada de agente de ese laboratorio, Grok pasó del 18 % al 33 %, no al 38,0 %.
CursorBench sí se puede poner junto a sí mismo, porque el 51,8 % aparece dos veces. Opus 5.5, con 57,8 %, le saca 6,0 puntos a Fable en la cifra de mayor esfuerzo de Anthropic. Grok, con 46,3 %, queda 5,5 puntos por detrás de esa celda de Fable. Astra no tiene celda. Pon el laboratorio al lado del porcentaje. Sin eso, el ranking es un collage.
EEBench, Harvey y HealthBench son filas de xAI. Opus 5.5 y Astra no están. Esas filas se quedan en el post de Grok. AutomationBench y Terminal-Bench-Science son filas de Anthropic y de OpenAI. Grok no está. Esas filas se quedan en los posts de Opus y de Astra.
Qué sigue siendo de cada post que ya existe
Esta página no reemplaza las tres piezas a las que enlaza. Solo pone a los tres modelos en orden.
- El post de Opus 5.5 guarda el corte de $4/$20, el medidor de $0.02719, el límite de cinco horas y el ciber que vuelve a Opus 4.8. Su portada sigue siendo el gráfico de Anthropic. Las columnas de Astra se leen aquí.
- El post de Grok 4.7 guarda 4.7 frente a 4.6: doce llamadas, 12/12, y el salto de $2/$6. La barra de 1.695 es de ese post. Opus 5.5, no.
- El post de Astra guarda Astra frente a Fable 5.1, con el HTTP 400 del 4 de septiembre y el corte de 99,9 % frente a 62,7 %. Ya se podía llamar el 22 de septiembre. La decisión sobre Fable no cambió.
Cuál de los tres fijar
Fija Grok 4.7 cuando la factura de salida es el producto y el trabajo cabe en 500.000 tokens. Fija Opus 5.5 cuando el producto es la fila compartida de GDPval. Fija Astra si ya mediste un trabajo de computer-use o de matemáticas en los otros dos posts, y puedes pagar $10/$50.
- Llamadas cortas sin caché, como estas seis: Grok fue el más barato en total, $0.0038784 frente a $0.005292 y $0.00709, y el más caro en la factura, porque el razonamiento llegó a 295 tokens. Si tus llamadas cortas se parecen a
merge_intervals, copia la fila de la función. Si se parecen a un número de una línea, Opus gastó 46 tokens y ganó esa fila. - Agentes con mucha caché por debajo de 200.000 tokens de prompt: Opus, a $0.20 por millón de tokens en caché, le gana a los dos. Astra, a $1.00, está a 5× de esa línea. La línea de caché de xAI para Grok es $0.50, o sea 2,5× Opus.
- Prompts que pasan de 200.000 tokens: Grok cambia el precio de toda la petición. Un prompt de 250.000 tokens en la ficha de xAI sale a $4 y $12, no a $2 y $6. El salto de Astra empieza más tarde, en 272.000, y no cambia el precio de los tokens por debajo de esa línea. La documentación de Grok sí cambia el precio de la petición entera.
- Trabajo de oficina, si te fías de GDPval: Opus 1.846, luego Grok 1.695, luego Astra 1.542, con el 1.735 de Fable entre Opus y Grok. Ese orden es el de los laboratorios. No sale de las seis llamadas.
- Trabajo de terminal: déjalo fuera de este ranking. Elige el laboratorio cuyo runner sí vas a desplegar, y usa el número de ese laboratorio. Mezclar 66,4 % con 38,0 % no te dice qué id llamar.
Preguntas frecuentes
¿Ya puedes llamar a GPT-6 Astra en OpenRouter?
Sí, a las 22:34 UTC del 22 de septiembre de 2026. El id openai/gpt-6-astra devolvió 1.96 en la factura y un merge_intervals que pasó los tests ocultos. El 4 de septiembre el mismo id devolvió HTTP 400. El post anterior deja constancia de ese 400. Este deja constancia de la llamada que funcionó. El contexto en el listado era de 1.050.000 tokens.
¿xAI bajó Grok 4.7 de los $2 y $6?
En la ficha de lanzamiento que cita esta página, no hubo recorte. La tabla de xAI sigue en $2 y $6 por debajo de 200.000 tokens de prompt, y pasa a $4 y $12. El catálogo de OpenRouter en esta pasada era $1.60 y $4.80, y luego $3.20 y $9.60, un 0,8× de esas líneas. La factura de las seis llamadas usa la cifra de OpenRouter. Si le pagas a xAI directamente, la factura sigue la ficha de xAI hasta que ellos la cambien.
¿Por qué Grok no está en el gráfico de benchmarks de Anthropic?
Grok no tiene columna en el gráfico de Anthropic del 22 de septiembre: ahí se compara Opus 5.5 con Fable 5.1, Opus 5, GPT-6 Astra y GPT-5.6 Sol. El gráfico de xAI compara Grok 4.7 con Grok 4.6, Sol y Fable. Opus 5.5 no tiene columna. El cruce es GDPval: las dos páginas imprimen Fable en 1.735 y Astra en 1.542.
¿El medidor de seis llamadas dice que Opus 5.5 es más inteligente?
No. Los tres pasaron las dos tareas. El medidor es una factura y un recuento de tokens. GDPval es la puntuación de laboratorio, y ahí Opus 5.5 va primero entre estos tres, con 1.846 frente a 1.695 y 1.542. Que la función de merge pase no confirma el 1.846, y el 1.846 no predice la factura de $0.005292.
¿Qué modelo tiene la ventana de contexto más corta?
Grok 4.7, con 500.000 tokens en el listado de OpenRouter. Opus 5.5 llega a 1.000.000. Astra llega a 1.050.000. Grok además cambia de tarifa a los 200.000 tokens de prompt, así que la ventana barata queda por debajo de 500.000. La tarifa mayor de Astra arranca en 272.000 y se aplica a los tokens por encima de esa línea, más un multiplicador de salida de 1,5×.