Le nouveau Claude Sonnet 5.5 : même prix $2/$10, mais les 30 % d'économie n'existent que sur les longues tâches
Anthropic a sorti Claude Sonnet 5.5 le 28 septembre 2026 exactement au prix de Sonnet 5 : $2 le million de tokens d'entrée, $10 le million de tokens de sortie. Un jour plus tard, on a fait passer 19 appels notés par OpenRouter. Sur un long fichier HTML, la facture baisse de 11,1 %. Sur une petite somme de facture, elle monte de 12,8 %.
Même prix. Facture différente.
Ce qui change avec Claude Sonnet 5.5, sorti le 28 septembre
Remplace l'identifiant du modèle par claude-sonnet-5-5 et ton tarif par token reste à $2 en entrée et $10 en sortie.
La page de tarifs d'Anthropic liste Sonnet 5.5 et Sonnet 5 sur des lignes identiques, cache et batch compris : toute différence de coût entre les deux est donc une différence de nombre de tokens.
| Élément | Sonnet 5.5 au lancement |
|---|---|
| Identifiant API | claude-sonnet-5-5 |
| Entrée / sortie, par million de tokens | $2 / $10 |
| Lecture du cache / écriture du cache | $0.20 / $2.50 (5 min), $4 (1 heure) |
| Batch entrée / sortie | $1 / $5 |
| Contexte / sortie maximale | 1M / 128K tokens |
| Effort par défaut | Medium dans Claude Code et les apps, High sur l'API |
| Disponibilité | Zero data retention ; AWS, Google Cloud, Microsoft Azure |
| GitHub Copilot | Pro, Pro+, Max, Business, Enterprise, au tarif public |
Sources : la page modèle Sonnet 5.5 d'Anthropic, son article de lancement et le changelog de GitHub. Pour le contexte : ce que Sonnet 5 a changé et les prix par token chez les différents fournisseurs. Côté budget européen, la TVA s'ajoute sur les factures professionnelles dans l'UE, et les déploiements sur AWS, Google Cloud et Azure comptent si tes données doivent rester sous un contrat cloud existant.
Sonnet 5.5 face à Opus 5.5 : jusqu'où va le tableau d'Anthropic ?
Sonnet 5.5 reste à moins de trois points d'Opus 5.5 sur quatre lignes en pourcentage sur six, et sa seule victoire tombe dans la marge d'erreur.
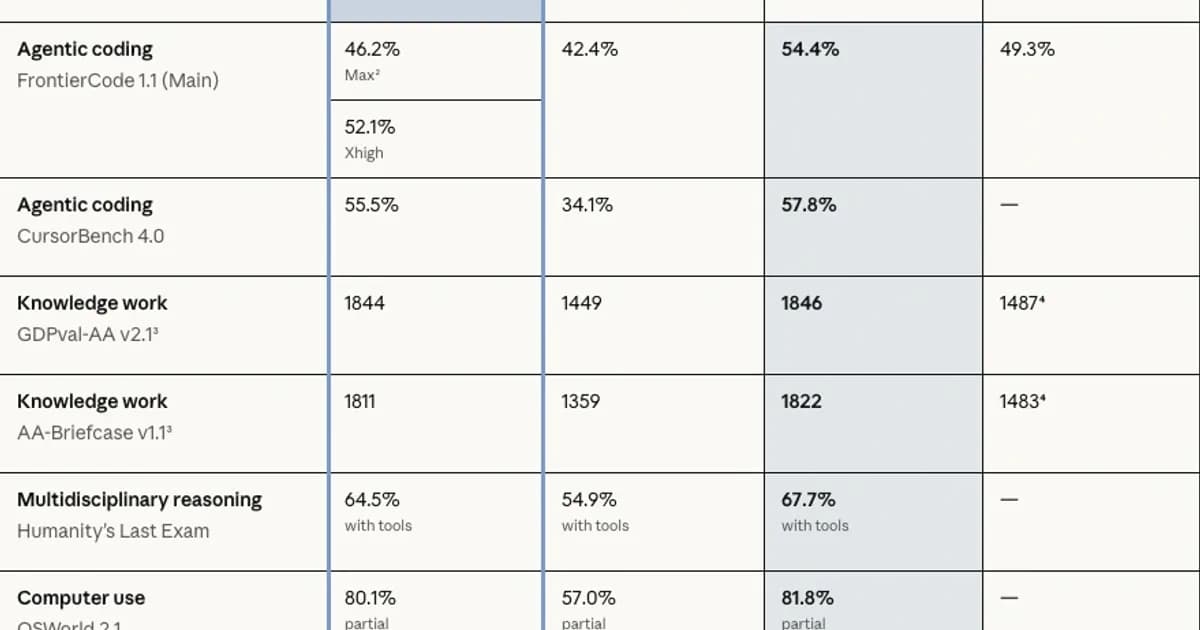
Cellules recopiées depuis l'image de couverture :
| Benchmark | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70,6 % | 10,3 % | 66,4 %¹ | n/d |
| FrontierCode 1.1 Main | 46,2 % (Max)², 52,1 % (Xhigh) | 42,4 % | 54,4 % | 49,3 % |
| CursorBench 4.0 | 55,5 % | 34,1 % | 57,8 % | n/d |
| GDPval-AA v2.1³ | 1 844 | 1 449 | 1 846 | 1 487⁴ |
| AA-Briefcase v1.1³ | 1 811 | 1 359 | 1 822 | 1 483⁴ |
| HLE (avec outils) | 64,5 % | 54,9 % | 67,7 % | n/d |
| OSWorld 2.1 (partiel) | 80,1 % | 57,0 % | 81,8 % | n/d |
| Chartography (sans outils) | 61,6 % | 15,6 % | 64,4 % | 53,6 %⁴ |
¹ Opus avec l'effort Xhigh. ² Max a fait moins bien que Xhigh : il a lancé davantage de sous-agents de revue de code, ce qui a causé, selon Cognition, des timeouts ou des modifications hors périmètre dans deux cas. ³ Mesuré par Artificial Analysis sur un déploiement préversion avec un bug de sortie structurée, corrigé depuis. ⁴ Un bug d'image de GPT-6 Sol n'est peut-être pas reflété. Les graphiques Terminal-Bench et CursorBench d'Anthropic tracent GPT-5.6 Sol.
FrontierCode (Xhigh) et CursorBench sont à 2,3 points d'Opus, OSWorld à 1,7, Chartography à 2,8. HLE fait exception avec 3,2. Les lignes Elo sont à 2 et 11 points d'écart.
C'est la ligne Terminal-Bench qui alimente le fil r/ClaudeCode « Sonnet 5.5 beats Opus 5.5 at coding and it's half the price?? ». La system card donne des erreurs standard de ±2,5 et ±2,6 points : l'écart de 4,2 points vaut environ 1,2 erreur standard combinée, et Sonnet tournait en max quand Opus tournait en xhigh. Artificial Analysis a mesuré Sonnet 5.5 à 64 % sur le même test. La plus grosse avance d'Opus n'est pas sur la page de lancement : SWE-Bench Pro, 81,3 contre 89,9.
GPT-6 Sol est simplement la colonne qu'Anthropic a imprimée. Pour la comparaison de GPT-6 Astra avec Opus 5.5, lis notre test à trois.
Vraiment 30 % moins cher par tâche ? Nos 19 appels mesurés
Seulement sur la longue tâche : 11,1 % moins cher sur une tâche HTML à 2 564 tokens de sortie en moyenne, 10 à 13 % plus cher sur deux tâches minuscules.
Le 29 septembre à 14:25 UTC, on a envoyé 19 appels notés via OpenRouter à Sonnet 5.5 et à Sonnet 5 : 3 tâches, 3 essais, 2 modèles, plus un appel supplémentaire à effort élevé. Facture totale : $0.183434. Les 18 appels appariés ont tous réussi.
# sonnet55_bench.py, 29 Sep 2026, POST https://openrouter.ai/api/v1/chat/completions
body = {
    "model": model,        # anthropic/claude-sonnet-5.5 ou anthropic/claude-sonnet-5
    "messages": messages,
    "max_tokens": max_tokens,         # 12000 sur la tâche HTML
    "reasoning": {"effort": effort},  # low : invoice, merge_intervals ; medium : HTML
}
Aucun LLM n'a noté quoi que ce soit. La facture (800k tokens lus au cache, 200k en entrée, 50k en sortie) devait renvoyer exactement 1.06, merge_intervals passait 6 asserts exécutés, et le HTML exigeait doctype, canvas, requestAnimationFrame et aucun script externe. Les coûts sont usage.cost sommé sur 3 essais.
| Tâche (effort) | Sonnet 5.5 | Sonnet 5 | Écart | Tokens de sortie moyens | Latence moyenne |
|---|---|---|---|---|---|
| Facture (low) | $0.002754 | $0.002442 | +12,8 % | 71 / 61 | 2,63 s / 4,49 s |
| merge_intervals (low) | $0.006054 | $0.005502 | +10,0 % | 172 / 154 | 3,06 s / 3,68 s |
| HTML 150 oiseaux (medium) | $0.077508 | $0.087156 | -11,1 % | 2 564 / 2 886 | 15,54 s / 21,61 s |
| Total apparié | $0.086316 | $0.0951 | -9,2 % | n/d | n/d |
Anthropic promet « jusqu'à 30 % de moins par tâche que son prédécesseur ». Matthias Bastian, de The Decoder, a ajouté la bonne réserve : « Des tests indépendants doivent encore confirmer ces affirmations. »
Dans notre mesure de 19 appels à effort low et medium, avec une seule longue tâche, l'économie est de -11,1 % sur le HTML et bascule à +12,8 % et +10,0 % sur les petites tâches. Le prix catalogue est identique : toute économie est donc un nombre de tokens, et sur nos deux plus petites tâches, Sonnet 5.5 a écrit plus de tokens, pas moins.
La vitesse tient mieux. La latence HTML baisse de 28,1 %, et le débit passe de 133,5 à 165,0 tokens par seconde (+23,6 %) : bon sens, un peu sous les 30 %. Sonnet 5 a aussi consigné 54 à 63 tokens de raisonnement par appel de facture ; Sonnet 5.5 en a consigné 0 sur les 10 appels.
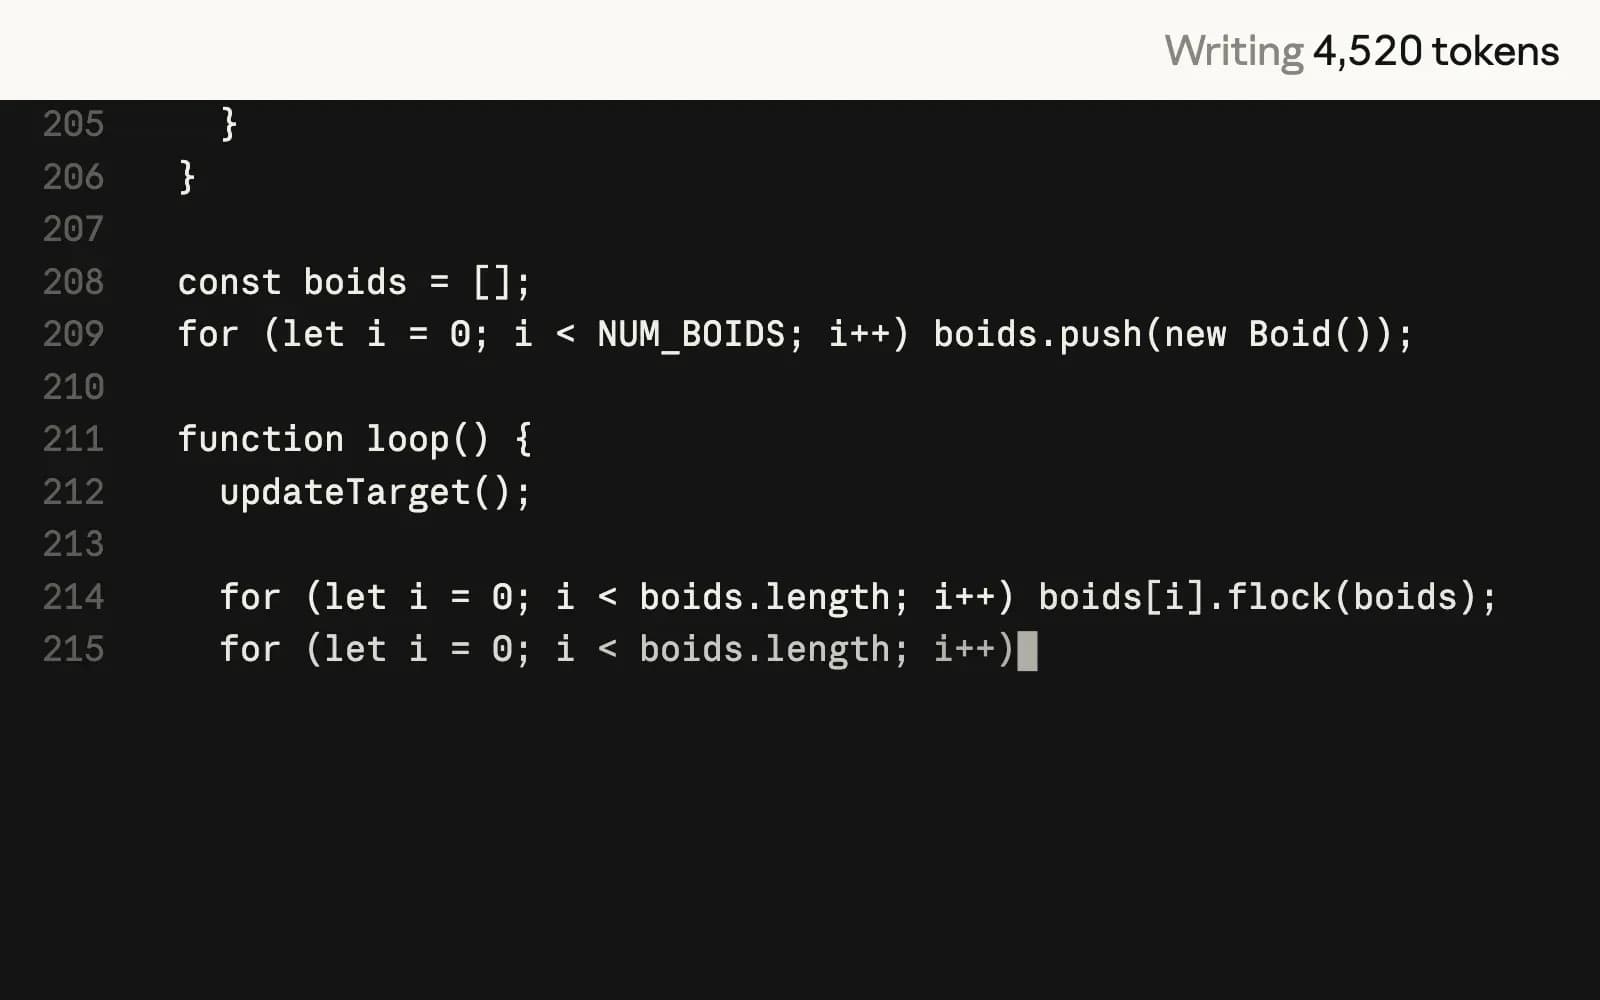
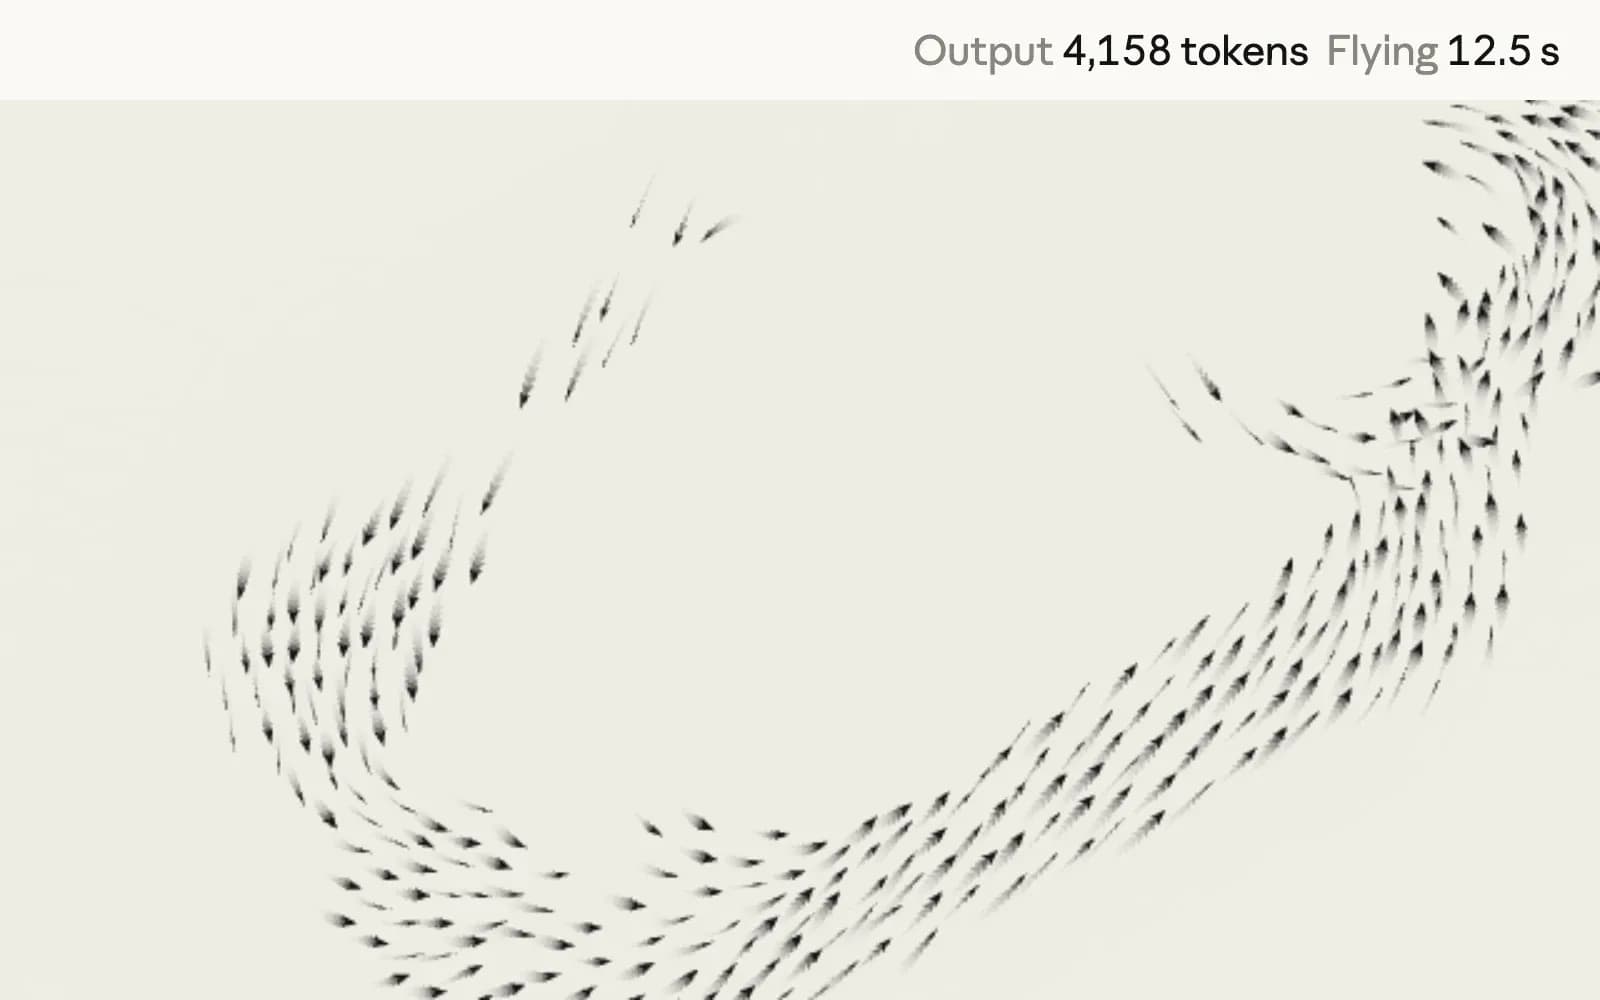
Cette tâche HTML est une version à 150 oiseaux du prompt de démo à 400 étourneaux de la page de lancement d'Anthropic. Les images ci-dessous sont l'enregistrement d'Anthropic, pas notre exécution.
Ce que les testeurs du lancement ont rapporté à Anthropic
« Sans changer aucun de nos prompts, Claude Sonnet 5.5 a fait mieux que Sonnet 5 sur presque toutes nos évaluations hors ligne du Slackbot, en moins d'étapes et avec environ 14 % de tokens de sortie en moins. » Curtis Allen, Principal Engineer, Slack
« Le nouveau modèle a géré des dizaines de milliers de lignes de code pour l'architecture des systèmes de gameplay, gardé des réponses vives, tenu des tâches de plusieurs heures et livré avec des prompts moins prescriptifs. » Daniel Vogel, Chief Operating Officer, Epic Games
Les deux citations sont collectées par le fournisseur, et les deux décrivent un travail long en plusieurs étapes. Nos tâches minuscules ont donné l'inverse.
Non mesuré : le travail agentique, les benchmarks ci-dessus, le repli cyber. 3 essais, c'est un relevé ponctuel ; pour faire le tien, lis usage sur chaque appel.
Pourquoi le niveau d'effort pèse plus sur la facture que le modèle ?
Artificial Analysis a mesuré $0.59 par tâche en medium et $7.60 en max, soit 13 fois plus pour 15 points d'index.
En max, l'organisme a compté « ~193k tokens de sortie par tâche de l'Intelligence Index. C'est la plus forte consommation de tokens que nous ayons mesurée ».
| Effort | Coût AA par tâche | AA Intelligence Index | Rang AA, 29 sept. |
|---|---|---|---|
| Low | $0.41 | 36 | 63 sur 216 |
| Medium | $0.59 | 41 | 44 sur 216 |
| High | $1.08 | 47 | 23 sur 216 |
| Max | $7.60 | 56 | 3 sur 216 |
Les lignes viennent des pages par niveau d'effort d'AA, consultées le 29 septembre. L'article de lancement d'AA donnait à Sonnet 5.5 la deuxième place de l'index ; la page du modèle affichait 56, rang 3 sur 216, ce jour-là. Max a aussi coûté « environ 50 % de plus que le coût par tâche de Sonnet 5 ».
Notre propre appel à effort high a ignoré le réglage : merge_intervals avec effort=high a coûté $0.002018 pour 172 tokens de sortie, comme en low. L'effort ne joue que sur un travail assez gros pour qu'on y réfléchisse, et c'est là que commence la réduction de la facture d'API LLM.
Qu'est-ce qui renvoie une erreur 400 après le changement d'identifiant ?
Toute requête avec le raisonnement désactivé échoue : passe à between_tools et garde l'effort à high ou en dessous.
Le guide de migration d'Anthropic détaille l'erreur :
# Avant (réflexe Sonnet 5) : 400 invalid_request_error sur claude-sonnet-5-5
thinking = {"type": "disabled"}
# '"thinking.type.disabled" is not supported for this model. Use
#  "thinking.type.between_tools" for the lowest thinking setting, ...'

# Après : accepté aux efforts low / medium / high, 400 à xhigh / max
thinking = {"type": "between_tools"}
output_config = {"effort": "medium"} # fixé pour toute la conversation avec between_toolstool_choiceavecanyoutoolrenvoie 400. Utiliseautoplusstrict: true(20 outils stricts au maximum), ouautoseul sur Amazon Bedrock.- Les blocs de raisonnement d'Opus 5, d'Opus 5.5, de Fable ou de Mythos sont ignorés sans bruit ; les comptes créés à partir du 31 août 2026 reçoivent un 400 si tu rejoues un bloc après avoir modifié l'historique. Le mécanisme est le même que pour la liaison des blocs de raisonnement de Fable 5.1.
- Le computer use demande
computer_toolset_20260801sur l'API Claude et sur Google Cloud. - Les refus nomment une catégorie
stop_details, dontcyber,frontier_llm(« pourrait aider au développement de modèles d'IA concurrents ») etreasoning_extraction. - Le repli côté serveur (
fallbacks: "default", bêta, API Claude uniquement) relance sur Sonnet 5 les refuscyberetfrontier_llm; la system card indique que 1,2 % des requêtes Terminal-Bench sont passées par le repli. - Le prompt minimal pouvant être mis en cache tombe à 512 tokens contre 1 024 (seuils de la mise en cache des prompts), et
/claude-api migratedans Claude Code applique ces changements.
Les équipes sécurité tombent d'abord sur le point 4. Un commentateur de HN, johnmlussier, dit que malgré sa participation au Cyber Verification Program, il « ne peut utiliser ni Opus 5.5 ni Sonnet 5.5 pour le moindre travail de bounty autorisé ». Anthropic annonce l'extension du programme pour « bientôt » (« Soon » dans son texte).
La même checklist dit : « Relance ton balayage des niveaux d'effort et refais ta base de coût ». Fais-le avant de croire les 30 %.
Claude Sonnet 5.5 ou Opus 5.5 : lequel choisir ?
Prends Sonnet 5.5 par défaut pour le code bien délimité et les appels en volume ; garde Opus 5.5 pour le jugement ouvert et tout travail à effort max.
Sonnet est listé à la moitié du $4/$20 d'Opus 5.5, mais Artificial Analysis a mesuré Sonnet en max à $7.60 par tâche contre $5.98 pour Opus 5.5, soit environ 27 % de plus.
| Signal | Sonnet 5.5 | Opus 5.5 | Avantage |
|---|---|---|---|
| Entrée / sortie par million | $2 / $10 | $4 / $20 | Sonnet, moitié prix |
| Lecture du cache / écriture 5 min | $0.20 / $2.50 | $0.20 / $5 | Égalité en lecture |
| Mix lourd en cache (ci-dessous) | $1.06 | $1.96 | Sonnet, 1,85x et non 2x |
| Coût AA par tâche, effort max | $7.60 | $5.98 | Opus, 27 % moins cher |
| SWE-Bench Pro | 81,3 % | 89,9 % | Opus de 8,6 points |
Mix: 800k cache-read + 200k input + 50k output tokens
Sonnet 5.5: 0.8 x $0.20 + 0.2 x $2 + 0.05 x $10 = $0.16 + $0.40 + $0.50 = $1.06
Opus 5.5:   0.8 x $0.20 + 0.2 x $4 + 0.05 x $20 = $0.16 + $0.80 + $1.00 = $1.96
Ratio: 1.96 / 1.06 = 1.85x
Le « environ 1,65× » d'Aleksei Aleinikov dépend d'un mix qu'il ne précise pas. Mets le tien : plus ta part de cache est lourde, plus l'avantage de Sonnet se réduit.
Anthropic dit elle-même : « Opus 5.5 reste nettement plus fort sur le travail complexe et ouvert qui demande un jugement soutenu. » Un commentateur de HN, datadrivenangel, va plus loin : « Opus 5.5 en Low semble plus intelligent, moins cher et plus rapide que Sonnet en medium ». Non testé par nous. Les tarifs et limites d'Opus sont dans notre analyse d'Opus 5.5.
Notre choix par défaut depuis le 29 septembre : claude-sonnet-5-5 à l'effort medium. Les jobs à effort max vont sur Opus 5.5, car en max Sonnet cesse d'être le modèle bon marché.
Questions fréquemment posées
Quelle est la date de sortie de Claude Sonnet 5.5 ?
Anthropic a sorti Claude Sonnet 5.5 le 28 septembre 2026 sous l'identifiant claude-sonnet-5-5, le même jour sur Amazon Web Services, Google Cloud, Microsoft Azure et GitHub Copilot. Selon la documentation d'Anthropic, il ne sera pas retiré avant le 28 septembre 2027.
Claude Sonnet 5.5 est-il moins cher que Sonnet 5 ?
Pas au token : les deux sont listés à $2 en entrée et $10 en sortie. Dans notre mesure, une longue tâche HTML a coûté 11,1 % de moins sur Sonnet 5.5 et une petite tâche de facture 12,8 % de plus ; en effort max, Artificial Analysis a mesuré environ 50 % de plus par tâche.
Peut-on utiliser Sonnet 5.5 dans Claude Code et GitHub Copilot ?
Oui. Claude Code le règle par défaut sur l'effort Medium ; l'API, sur High. Dans GitHub Copilot, de Pro à Enterprise, il est « facturé au tarif public du fournisseur dans le cadre de la facturation à l'usage ». Pour le fixer, vois comment changer de modèle dans Claude Code.
Quelle est la fenêtre de contexte de Sonnet 5.5 et sa date limite de connaissances ?
Il accepte 1M tokens de contexte et renvoie jusqu'à 128K tokens de sortie, avec une date limite de connaissances fiable à juin 2026 selon la system card.
Existe-t-il un Haiku 5.5 ?
Pas au 29 septembre 2026. Anthropic a annoncé le 28 septembre que Claude Haiku 5.5 « rejoindra la famille Claude 5.5 dans les prochaines semaines ».