Claude Opus 5.5 : tarifs $4/$20, les limites et ce qu'on a mesuré
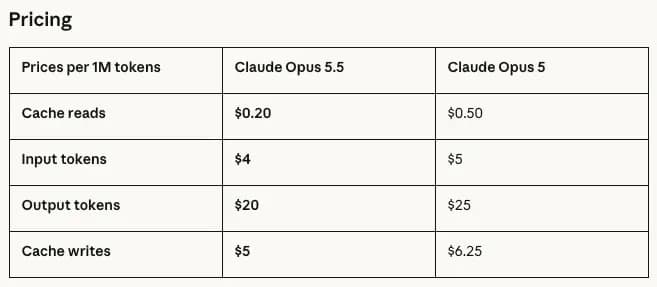
Claude Opus 5.5 est sorti le 22 septembre 2026 à $4 le million de tokens d'entrée et $20 le million de tokens de sortie. Les lectures cache sont à $0.20. C'est 20 % sous Claude Opus 5 en entrée et en sortie. C'est 60 % sous lui sur les lectures cache ($0.50). Identifiant plateforme : claude-opus-5-5. OpenRouter listait déjà anthropic/claude-opus-5.5 à 18:57 UTC, aux trois mêmes tarifs, contexte de 1 000 000 tokens.
Neuf appels notés sont partis entre 18:57 et 18:58 UTC. Huit étaient appariés à Opus 5, à effort=low. Les huit ont réussi. Opus 5.5 a facturé $0.010564. Opus 5 a facturé $0.01269.
Un neuvième appel, Opus 5.5 à effort=high, a aussi réussi et a facturé $0.003936. Total de l'expérience : $0.02719. La couverture est le graphique d'Anthropic, repris tel quel depuis la page de lancement.
Prix API de Claude Opus 5.5 face à Opus 5
C'est sur le trafic lourd en cache que la nouvelle carte change la facture. Les appels sans cache n'ont baissé que d'environ 20 % sur notre compteur.
Le tableau de lancement d'Anthropic, reproduit ci-dessous et sur la capture de prix, est la carte standard. Fable 5.1 reste à $10/$50. Sa lecture cache est à $0.25, donc la ligne cache d'Opus 5.5 passe $0.05 par million sous celle de Fable, pas de moitié. L'écart de 2,5× porte sur l'entrée et la sortie : $10/$4 et $50/$20.
| Ligne, par million de tokens | Opus 5.5 | Opus 5 | Fable 5.1 |
|---|---|---|---|
| Entrée | $4 | $5 | $10 |
| Sortie | $20 | $25 | $50 |
| Lecture cache | $0.20 | $0.50 | $0.25 |
| Écriture cache, 5 min | $5 | $6.25 | $12.50 |
| Écriture cache, 1 h | $8 | $10 | $20 |
| Entrée / sortie batch OpenRouter | $2 / $10 | $2.50 / $12.50 | $5 / $25 |
| Entrée / sortie mode rapide | $8 / $40 | pas sur cette carte | pas sur cette carte |
L'écriture cache à 5 minutes ($5 contre $6.25) figure sur la page d'Anthropic et dans la note d'Artificial Analysis.
L'écriture à 1 heure ($8) et la route batch ($2/$10, lecture cache $0.10) viennent du payload /api/v1/models d'OpenRouter à 18:57 UTC. Le tableau de lancement n'imprime pas ces lignes.
Le mode rapide est sur la page de lancement : jusqu'à 2,5× la vitesse, à $8 et $40. C'est 2× l'Opus 5.5 standard. Il se place au-dessus des $5/$25 d'Opus 5.
Neuf appels notés et la facture qu'ils ont produite
Les 8 appels appariés ont réussi. Opus 5.5 a coûté $0.010564 contre $0.01269 pour Opus 5, une baisse de 16,8 %.
Complétions de chat sur OpenRouter. Pas de température. reasoning.effort était à low, plus un appel de code à high.
Deux tâches, deux essais. Les correcteurs : correspondance exacte et tests exécutés. Tokens en cache : 0. Prompts de facture : 104 tokens.
# 22 Sep 2026, 18:57 UTC, OpenRouter
MODELS = ["anthropic/claude-opus-5.5", "anthropic/claude-opus-5"]
# invoice answer must be 1.96
# 800_000 * 0.20/1e6 + 200_000 * 4/1e6 + 50_000 * 20/1e6
# coding: merge_intervals, hidden tests, function only| Jeu | Opus 5.5 | Opus 5 |
|---|---|---|
| Facture, 2 essais | 2/2, $0.002652, 45 et 46 en sortie, 3,089 s et 5,100 s | 2/2, $0.00332, 46 et 46 en sortie, 6,765 s et 3,997 s |
| merge_intervals, 2 essais | 2/2, $0.007912, 168 et 168 en sortie, 3,597 s et 3,239 s | 2/2, $0.00937, 161 et 155 en sortie, 3,435 s et 3,582 s |
| Total apparié | $0.010564, 8/8 | $0.01269, 8/8 |
| effort=high, 1 appel de code | réussi, $0.003936, 167 en sortie, 0 token de raisonnement | non lancé |
La paire facture est le cas propre des 20 % : 20,1 % moins cher, presque le même nombre de tokens en sortie. La paire fonction est le raté : Opus 5.5 a écrit 336 tokens de complétion contre 316, et la facture n'a baissé que de 15,6 %. Le prix catalogue a baissé de 20 %. Le nombre de tokens a monté. L'économie nette a rétréci. effort=high n'a pas allongé cette fonction : 167 tokens de complétion, 0 token de raisonnement, $0.003936, tests réussis. Artificial Analysis a vu l'autre régime, environ 119 000 tokens de sortie par tâche de l'Intelligence Index au max, contre environ 73 000 pour Opus 5, le coût par tâche restant au même niveau. Ne compte pas une remise de 40 % sur ce régime. Nos 9 appels n'y sont jamais entrés.
La latence est à égalité sur cet échantillon. Moyennes sur le code : 3,42 s et 3,51 s. Moyennes sur la facture : 4,09 s et 5,38 s. Les plages se chevauchent, 5,100 s contre 3,997 s.
Anthropic dit que la sortie est plus rapide de plus de 30 % qu'Opus 5. Ces 9 appels ne le montrent pas.
Où le graphique d'Anthropic mène et où il ne mène pas
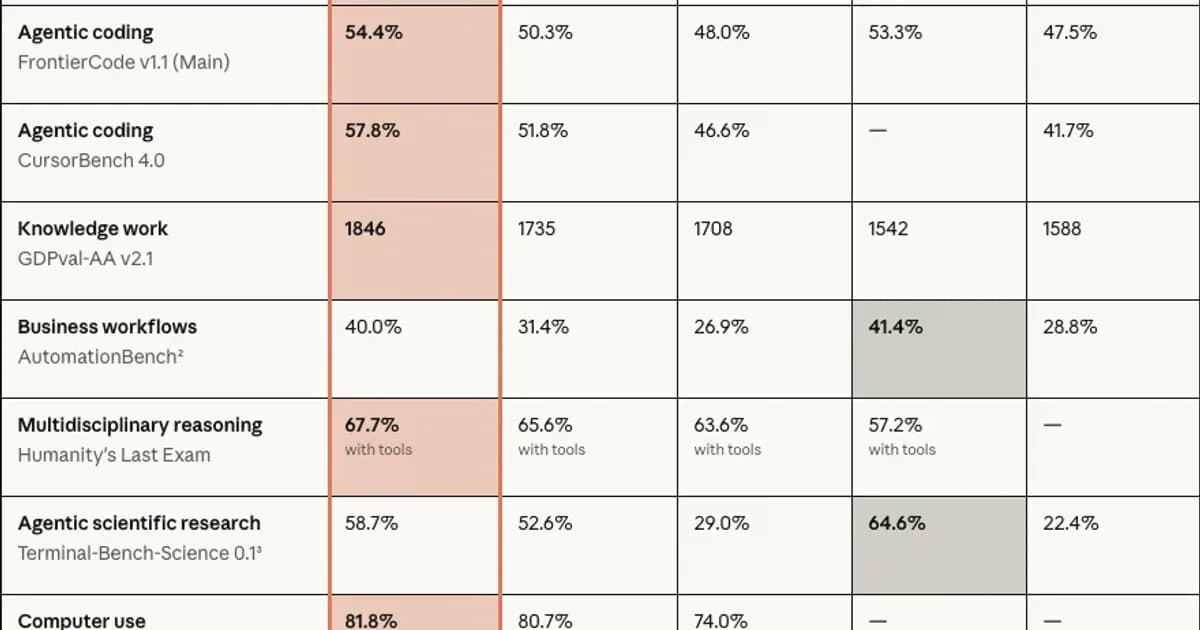
Astra mène sur deux lignes chiffrées : AutomationBench à 41,4 % et Terminal-Bench-Science à 64,6 %.
Chaque autre cellule chiffrée du graphique du 22 septembre met Opus 5.5 devant. L'image de couverture est ce graphique. Les cellules ci-dessous en sont copiées.
Anthropic dit que ces chiffres d'Opus 5.5 utilisent le thinking adaptatif à l'effort max, avec une réserve : Terminal-Bench 4.0, c'est Opus 5.5 en xhigh et GPT-6 Astra en high, le chiffre d'Astra étant celui rapporté par OpenAI.
| Benchmark | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 66,4 % | 55,8 % | 52,3 % | 57,9 % | 37,3 % |
| FrontierCode v1.1 (Main) | 54,4 % | 50,3 % | 48,0 % | 53,3 % | 47,5 % |
| CursorBench 4.0 | 57,8 % | 51,8 % | 46,6 % | n/a | 41,7 % |
| GDPval-AA v2.1 | 1846 | 1735 | 1708 | 1542 | 1588 |
| AutomationBench | 40,0 % | 31,4 % | 26,9 % | 41,4 % | 28,8 % |
| Humanity's Last Exam, avec outils | 67,7 % | 65,6 % | 63,6 % | 57,2 % | n/a |
| Terminal-Bench-Science 0.1 | 58,7 % | 52,6 % | 29,0 % | 64,6 % | 22,4 % |
| OSWorld 2.0, partiel | 81,8 % | 80,7 % | 74,0 % | n/a | n/a |
| Chartography, avec outils | 89,0 % | 88,4 % | 83,4 % | n/a | n/a |
Lis les notes avant de trancher sur un écart d'un point.
- Les garde-fous sont restés actifs. Le repli cyber était Opus 4.8. Le repli biologie et LLM frontier était Opus 5. Anthropic dit que ça baisse probablement le score.
- Zapier a fait tourner AutomationBench sans repli, donc une intervention comptait comme un raté. 40,0 % vient de l'accès anticipé. Les 41,4 % d'Astra sont le classement public.
- L'erreur sur Terminal-Bench 4.0 est de ±2,6 points. 66,4 contre 57,9 passe au-dessus. FrontierCode, 54,4 contre 53,3, ne passe pas.
- Anthropic dit que l'écart en usage quotidien face à Fable 5.1 est plus étroit que ce graphique.
- Artificial Analysis, le même jour, autre montage : Terminal-Bench 4.0 à 59,6 %, au niveau d'Astra en xhigh, et Humanity's Last Exam à 61,4 % contre 59,1 % pour Fable 5.1. Ne fais pas la moyenne de 66,4 et 59,6.
L'effort par défaut est une autre ligne. FrontierCode en medium est à 54,6 %. CursorBench en medium est à 52,5 %, pas les 57,8 % du tableau. Anthropic dit que ce score FrontierCode en medium bat le meilleur d'Astra pour environ un cinquième du coût par tâche.
Les limites que le prix de $4 ne lève pas
Les tâches cyber partent vers Opus 4.8. Le thinking reste allumé sur chaque compte API.
La carte moins chère n'a pas effacé les contraintes qui ont rendu les deux derniers lancements Claude pénibles à exploiter. Ce qui a changé le 22 septembre et ce qui n'a pas changé :
- Les limites de cinq heures montent sur Pro, Max, Team et l'Enterprise par siège, plus une réinitialisation que tu peux garder en réserve. Pas de nouveau décompte de messages. Le plafond hebdomadaire n'est pas décrit comme disparu. Les anciennes règles de fenêtre sont dans l'article sur les limites d'usage.
- Les garde-fous cyber, biologie et distillation sont ceux de la classe Fable. La correction de bugs de routine reste. La plupart des tâches cyber sont redirigées vers Opus 4.8. La biologie passe par le Life Sciences Verification Program. Le programme cyber plus large n'était pas ouvert le jour du lancement.
- On ne peut pas couper le thinking. La page de lancement renvoie à la doc du modèle pour cette restriction. Le preserved thinking, le contrôle anti-distillation repris de Fable 5.1, empêche les utilisateurs de l'API de modifier un raisonnement déjà produit. Il s'applique à Opus 5.5 pour les comptes API créés le 31 août 2026 ou après.
- Le modèle porte un watermark pour l'AI Act de l'UE. La rétention nulle des données reste proposée, comme sur les modèles Opus précédents.
- Les tentatives de franchir la frontière de confinement ont baissé d'environ 85 % par rapport à Opus 5 et à Mythos 5.1, dit Anthropic. Celles qui restaient étaient de faible gravité et autodéclarées. Le modèle soupçonne souvent une éval, donc cet audit prédit mal la production.
- Sonnet 5.5 et Haiku 5.5 ne sont pas dans l'API aujourd'hui. La page dit qu'ils suivent dans les semaines qui viennent. Pas de date.
Si ta charge, c'est la sécurité offensive ou la conception en laboratoire humide, le tarif à $4 n'est pas celui d'un Opus 5.5 sans restriction. Le classificateur envoie une partie de ces appels vers un modèle plus ancien, et ta trace doit montrer le repli, sinon tu factures le mauvais identifiant.
Ce que les premiers testeurs ont dit à Anthropic
GitHub, Optiver et Box rapportent moins de tokens qu'Opus 5. Ces lignes sont des citations qu'Anthropic a publiées.
Ce sont des notes d'accès anticipé signées, pas un classement indépendant. @claudeai a posté à 16:31 UTC. Les réponses de la même heure saluaient la marge restante sur Pro et le débogage. Aucune trace partagée.
| Qui, sur la page de lancement | Ce qu'ils ont dit | Ce que ça ne prouve pas |
|---|---|---|
| Mario Rodriguez, GitHub | Le moins de tokens qu'ils aient mesuré. Tâches de terminal VS Code en moins de la moitié des étapes d'Opus 5. | Pas de journal public. |
| Noyan Tokgozoglu, Optiver | Qualité d'Opus 5 en environ la moitié des tours, du temps et des tokens de sortie. Coût en baisse de 40 % à 50 %. | Leur desk. Notre baisse : 16,8 %, cache à 0. |
| Yashodha Bhavnani, Box | Un tiers des tokens, 40 % moins verbeux, la précision a tenu. | Leur éval de contenu. |
| Zimu Li, Factory | Le medium a égalé Opus 5 en high, avec 20 % à 25 % de tokens de sortie en moins. | Notre réglage high n'a pas réduit les tokens. |
| Fabian Hedin, Lovable | D'un tiers à la moitié d'étapes en moins et moins de tokens. | Leur boucle de builder, pas la carte API. |
Les citations parlent de moins d'étapes et de moins de tokens, une baisse plus forte que les 20 % retirés du prix catalogue. Notre fonction a fait l'inverse : 336 tokens de complétion contre 316.
Les deux peuvent être vrais. Anthropic dit qu'un audit de 200 000 lignes s'est terminé en moins de 3 heures, contre plus de 20 pour Opus 5, avec 2,5 fois moins de tokens. On ne l'a pas relancé.
Ce qu'un tour lourd en cache change à la facture
Une relecture de 500 000 tokens de cache passe de $0.25 sur Opus 5 à $0.10 sur Opus 5.5.
C'est de l'arithmétique sur les tarifs publiés, pas l'un des 9 appels. Ces appels n'ont rien mis en cache, donc ils ne montrent que la baisse de 20 %, moins les tokens en plus. Branche la taille de ton préfixe. Le mélange déplace le pourcentage.
| Charge | Opus 5 | Opus 5.5 | Baisse |
|---|---|---|---|
| 500 000 tokens en lecture cache | $0.25 | $0.10 | 60 % |
| 20 000 tokens d'entrée frais + 8 000 de sortie, sans cache | $0.30 | $0.24 | 20 % |
| 500 000 en cache + 20 000 en entrée + 8 000 en sortie | $0.55 | $0.34 | 38 % |
| Mêmes 20 000 en entrée + 8 000 en sortie, mode rapide à $8/$40 | n/a | $0.48 | hausse face au 5.5 standard |
Les 38 % de cette troisième ligne montrent comment une baisse de 20 % sur le prix des tokens devient « environ 40 % de moins sur les charges typiques » : un agent lourd en cache, les réglages par défaut, et un nombre de tokens plus bas. Enlève le cache et tu retombes à 20 %, jusqu'à ce que le modèle se mette à parler davantage. Le mode rapide va dans l'autre sens : $0.48 contre $0.24 sur la part sans cache. La ligne batch du tableau de prix ($2/$10) est un prix de catalogue. On n'a envoyé aucun job batch.
Quel identifiant Claude Opus 5.5 épingler après le 22 septembre
Épingle claude-opus-5-5 pour le nouveau trafic d'agents, sauf si la tâche est cyber ou biologie.
L'article de juillet sur Opus 5 plaçait un modèle de classe Fable à la moitié de la carte tarifaire de Fable. Ce tarif est périmé au 22 septembre.
Opus 5.5 retire encore 20 % sur l'entrée et la sortie d'Opus 5 et 60 % sur les lectures cache. Les garde-fous suivent maintenant Fable 5.1, pas la ligne Opus plus souple. Grok 4.7, mesuré le même jour, est une autre carte.
- Appels API courts sans cache, comme ceux qu'on a notés : passe-les sur Opus 5.5. Le taux de réussite est à égalité, 8/8. La facture baisse de 16,8 % sur ce jeu, et de 20,1 % quand le nombre de tokens en sortie correspond.
- Boucles d'agent qui relisent un gros préfixe : passe-les aussi, et budgétise plus près de l'exemple chiffré à 38 % que de la facture à 16,8 %. Confirme que
cached_tokensest non nul dans la réponse, sinon tu es encore sur la voie à 20 %. - Évals de recherche à l'effort max : garde l'ancien budget Opus 5 tant que tu n'as pas mesuré. Le coût par tâche de l'Intelligence Index chez Artificial Analysis n'a pas suivi la baisse du prix au token.
- Offensive cyber, R&D en biologie, sondages de type distillation : ne compte pas sur une réponse d'Opus 5.5. Attends-toi à Opus 4.8, à Opus 5 ou à un refus. Les programmes de vérification sont la porte qu'Anthropic a nommée.
- Mode rapide : ne paie $8/$40 que si le 2,5× en vitesse vaut le 2× en tokens. Ce n'est pas le palier pas cher.
- Ne laisse Fable 5.1 épinglé que là où tu as mesuré un écart de qualité que ces 9 appels ne voient pas. Fable est à 2,5× en entrée et en sortie. Les lectures cache sont à $0.25 contre $0.20.
Questions fréquemment posées
Quel est l'identifiant API de Claude Opus 5.5 ?
Sur la plateforme Claude, l'identifiant est claude-opus-5-5. Sur OpenRouter, c'est anthropic/claude-opus-5.5, et le batch est anthropic/claude-opus-5.5:batch. On a appelé l'identifiant standard à 18:57 UTC le 22 septembre 2026. Contexte annoncé : 1 000 000 tokens. Le mode rapide est un prix ($8/$40), pas un second identifiant sur la page de lancement.
Claude Opus 5.5 retire-t-il la limite d'usage de cinq heures ?
Non. La limite de cinq heures monte sur Pro, Max, Team et l'Enterprise par siège, et une réinitialisation peut être gardée en réserve. Aucun nombre de messages n'a été publié. Le plafond hebdomadaire n'est pas décrit comme retiré. Les limites de tokens par minute côté API sont un autre compteur. Regarde Settings, puis Usage.
Peut-on couper le thinking sur Opus 5.5 ?
Anthropic dit non. La page du 22 septembre dit qu'on ne peut plus couper le thinking. Le preserved thinking empêche aussi les comptes créés le 31 août 2026 ou après de modifier le raisonnement précédent. Notre appel effort=high a quand même renvoyé une fonction normale, avec 0 token de raisonnement dans l'objet usage d'OpenRouter. Un réglage high n'est pas une chaîne de pensée visible.
La baisse de coût de 40 % est-elle réelle sur chaque charge ?
Pas sur la nôtre. Huit appels sans cache ont coûté 16,8 % de moins. La paire facture, seule, a coûté 20,1 % de moins. Un mélange chiffré avec 500 000 tokens en lecture cache plus une complétion courte arrive à 38 %. Artificial Analysis dit que les tâches de l'Intelligence Index à l'effort max coûtent à peu près autant qu'Opus 5, parce que les tokens de sortie ont augmenté d'environ 1,6×.
Quand sortent Claude Sonnet 5.5 et Haiku 5.5 ?
Anthropic a dit que les deux suivent dans les semaines qui viennent, sur la page du 22 septembre 2026, sans donner de date. Opus 5.5 était le seul identifiant 5.5 qu'on pouvait appeler ce soir-là. Une voie moins chère, hors Opus, reste la carte Sonnet ou Haiku précédente.