GPT-6 Astra vs Claude Opus 5.5 vs Grok 4.7 : facture, GDPval et un compteur à six appels
On pouvait appeler GPT-6 Astra, Claude Opus 5.5 et Grok 4.7 sur OpenRouter à 22:34 UTC le 22 septembre 2026. Six appels notés, deux tâches, un essai chacun : tous ont réussi. La gateway a facturé $0.01626.
Les graphiques de lancement ne s'alignent pas.
Le tableau d'Anthropic a Astra, pas Grok. Le tableau xAI a Fable 5.1 et Sol, plus Astra sur un graphique Elo. Cette page garde les repères communs. Elle s'arrête là où les échelles ne mesurent plus la même chose.
L'écart de prix Opus 5.5 contre Opus 5 reste dans l'article Opus 5.5. La comparaison 4.7 contre 4.6 reste dans l'article Grok 4.7. Astra contre Fable reste dans l'article GPT-6 Astra.
Trois cartes et la taille de prompt qui change leur tarif
Le token d'Astra vaut 2,5× celui d'Opus 5.5 en entrée et en sortie. En lecture cache, c'est 5×. La carte xAI de Grok est à la moitié de l'entrée d'Opus 5.5 et à 0,3× de sa sortie, tant que le prompt reste sous 200 000 tokens.
Opus 5.5 sert de base 1,0 : $4, $20 et $0.20 par million.
La fiche modèle d'Astra est à $10, $50 et $1.00. La carte Grok du 21 septembre est à $2, $6 et $0.50 sous 200 000 tokens de prompt.
| Ligne, par million de tokens, sous le seuil | Opus 5.5 | GPT-6 Astra | Grok 4.7, carte xAI |
|---|---|---|---|
| Entrée | $4 | $10 | $2 |
| Sortie | $20 | $50 | $6 |
| Lecture cache | $0.20 | $1.00 | $0.50 |
| Contexte | 1 000 000 | 1 050 000 | 500 000 |
| Seuil | aucun sur cette carte | 272 000 tokens de prompt : entrée et cache à 2×, sortie à 1,5× | 200 000 tokens de prompt : toute la requête passe à $4 / $12 / $1 |
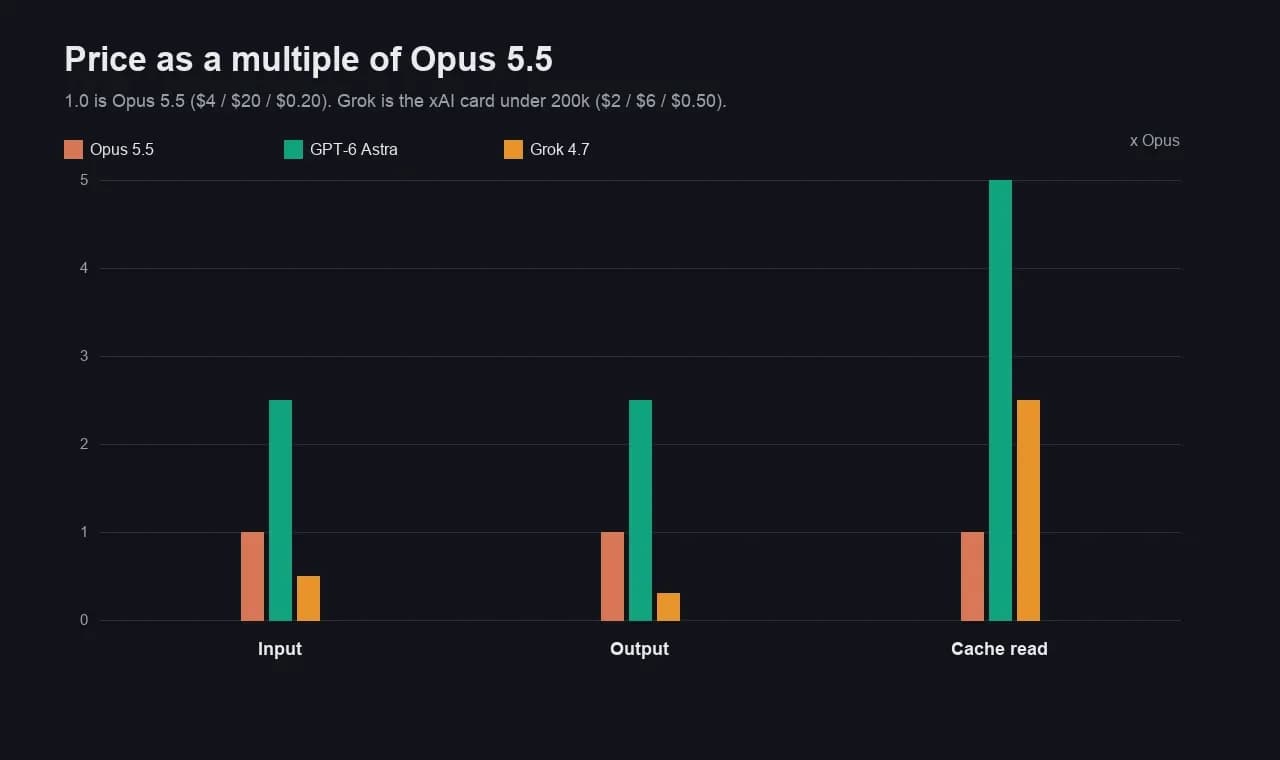
À 22:34 UTC, OpenRouter collait aux tarifs d'Opus et d'Astra. Les tarifs de Grok ne collaient pas à la carte xAI.
La fiche affichait $1.60, $4.80 et $0.40, puis $3.20, $9.60 et $0.80 à 200 000 tokens de prompt. C'est 0,8× la carte xAI. Nos montants usage.cost utilisent ce catalogue. L'article Grok 4.7 tarife encore la carte propre de xAI à $2 et $6.
Une relecture de 500 000 tokens en cache, simple calcul : Opus $0.10, Astra $0.25, la ligne cache xAI de Grok $0.25. C'est sur le cache qu'Astra est le plus cher, pas sur la sortie. Sur la sortie, $6 chez Grok contre $50 chez Astra, c'est un écart de 8,3×. Contre les $20 d'Opus, l'écart est de 3,3×.
Six appels notés et la facture que chaque modèle a vraiment envoyée
Les six ont réussi. Les deux appels de Grok ont coûté $0.0038784. Opus 5.5 a coûté $0.005292. Astra a coûté $0.00709.
La réponse de la tâche facture devait être 1,96. merge_intervals devait passer les tests cachés, y compris les intervalles qui se touchent.
Les tokens en cache étaient à 0 chez Opus et chez Astra. Grok a rapporté 1 152 tokens en cache sur les deux appels, à l'intérieur de prompts de 1 310 et 1 336 tokens. 295 de ses 298 tokens de facture étaient du raisonnement.
# 22 Sep 2026, 22:34 UTC, OpenRouter, one trial, max_tokens 1800
MODELS = [
    "anthropic/claude-opus-5.5",
    "openai/gpt-6-astra",
    "x-ai/grok-4.7",
]| Tâche | Opus 5.5 | GPT-6 Astra | Grok 4.7 |
|---|---|---|---|
| Facture, doit être 1,96 | réussi, $0.001336, 46 en sortie, 4,277 s | réussi, $0.00263, 38 en sortie, 2,116 s | réussi, $0.002144, 298 en sortie, 5,292 s |
| merge_intervals | réussi, $0.003956, 168 en sortie, 3,307 s | réussi, $0.00446, 69 en sortie, 2,588 s | réussi, $0.0017344, 204 en sortie, 4,217 s |
| Total des deux tâches | $0.005292 | $0.00709 | $0.0038784 |
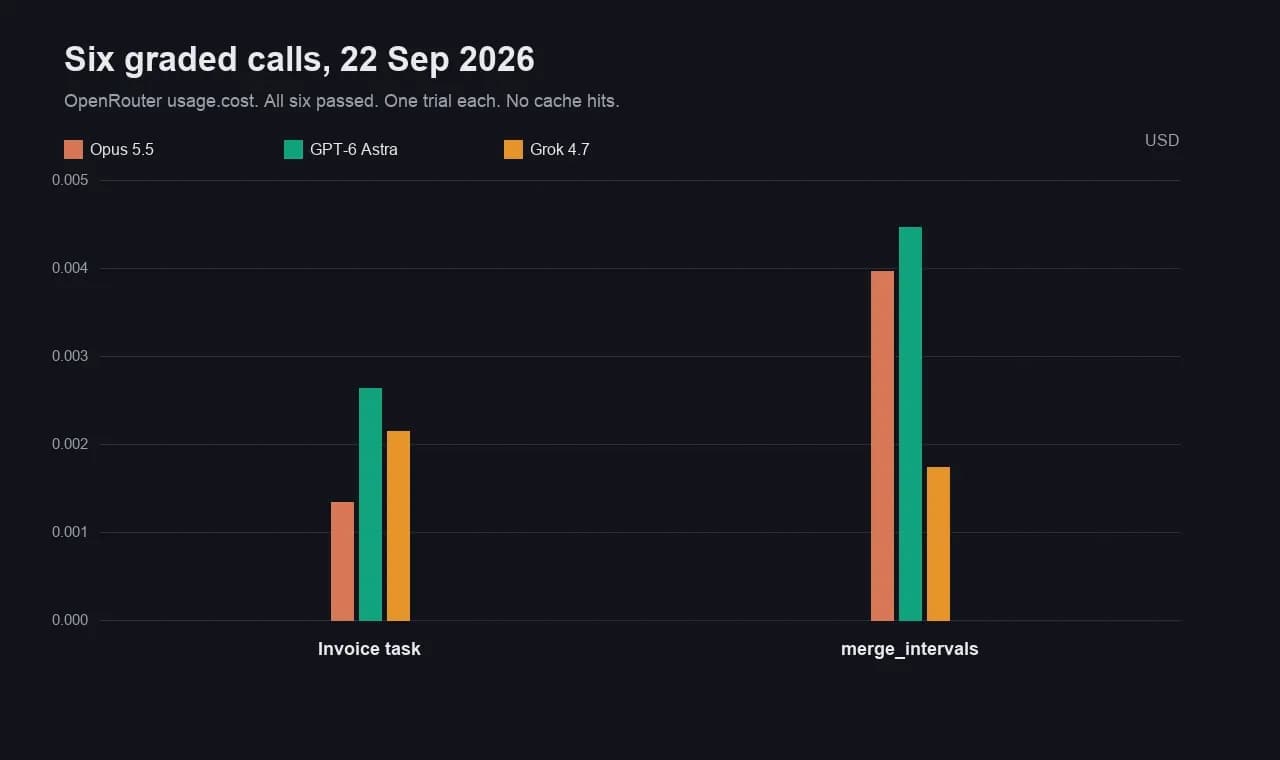
Astra a écrit le moins de tokens et envoyé la facture la plus élevée.
38 et 69 tokens de complétion, contre 46 et 168 chez Opus. La carte $10/$50 a mangé l'économie. Ces deux montants usage.cost collent exactement à $10 et à $50. Opus colle à $4 et à $20.
Grok a perdu la facture et gagné la fonction. 204 tokens à $4.80 donnent $0.0017344.
Astra a été le plus rapide sur les deux tâches, 2,116 s et 2,588 s. Un seul essai ne fait pas un classement de vitesse.
L'article Astra du 4 septembre disait que openai/gpt-6-astra renvoyait HTTP 400. C'était vrai à 14:40 UTC ce jour-là. Sur ces six appels, ce n'est plus vrai. L'identifiant a été accepté, l'appel a renvoyé 1,96 et les tests sont passés.
GDPval est la ligne que les deux labos partagent vraiment
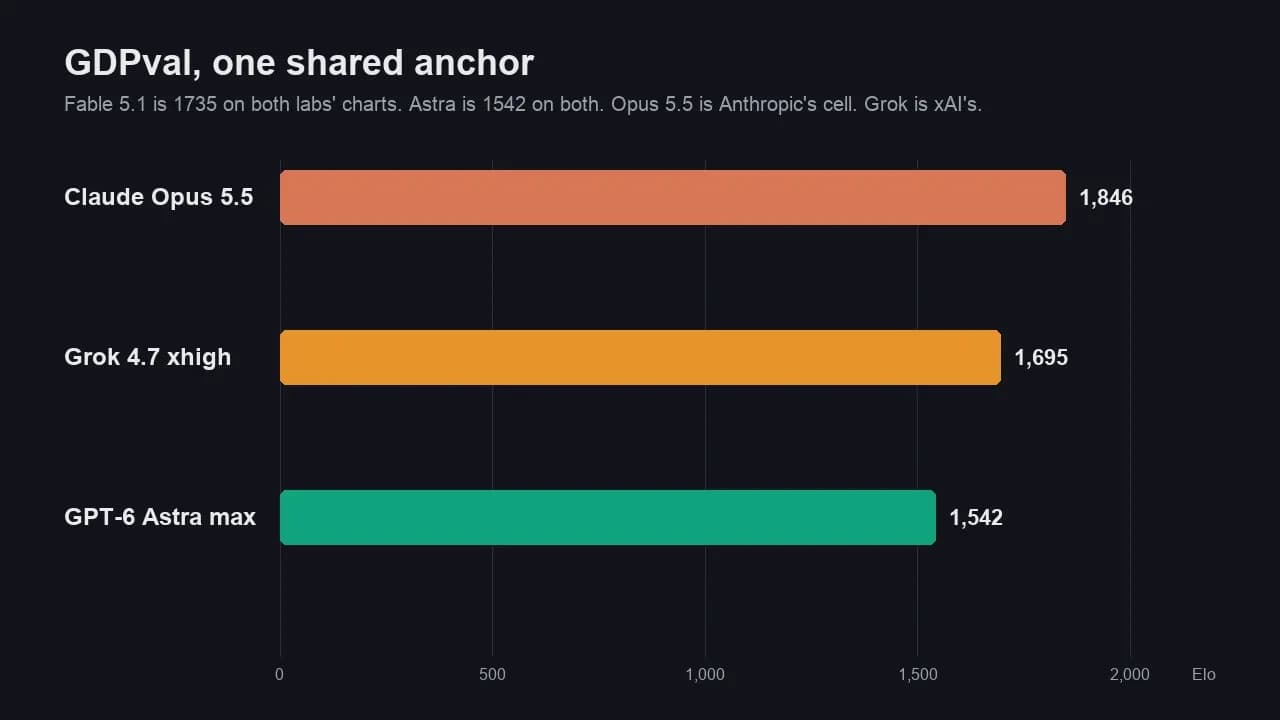
Opus 5.5 mène cette ligne partagée à 1 846. Grok 4.7 xhigh est à 1 695. Astra max est à 1 542.
Fable 5.1 à 1 735 est le repère, pas un quatrième choix.
Anthropic imprime 1 735, Astra à 1 542 et Opus 5.5 à 1 846. xAI imprime les mêmes 1 735 et 1 542, plus Grok 4.7 xhigh à 1 695. Deux nombres recopiés, donc un axe commun.
| Cellule | Score | Qui l'a imprimé |
|---|---|---|
| Claude Opus 5.5 | 1 846 | Anthropic, 22 septembre 2026, GDPval-AA v2.1 |
| Grok 4.7 xhigh | 1 695 | Graphique de lancement xAI, 21 septembre 2026, GDPval |
| GPT-6 Astra max | 1 542 | Les deux graphiques |
| Fable 5.1 max, repère seulement | 1 735 | Les deux graphiques |
Opus est à 151 Elo au-dessus de Grok et à 304 au-dessus d'Astra. Grok est à 153 au-dessus d'Astra et à 40 derrière le repère Fable. Rien de tout ça n'est notre mesure. Nos six appels portaient sur une facture à deux décimales et une fonction de fusion. Ça ne note pas le travail de bureau.
Artificial Analysis a placé Opus 5.5 à 58 sur son Intelligence Index à l'effort max et a dit que le coût par tâche est resté au niveau d'Opus 5 parce que les tokens de sortie ont augmenté d'environ 1,6×. Leur note sur Grok 4.7 place ce modèle à 46 sur le même index. Autre échelle, même sens : Opus est devant Grok. Ce n'est pas une raison d'ignorer la facture de tokens.
Terminal-Bench et CursorBench ne sont pas la même échelle
Ne fais pas la moyenne des 66,4 % d'Anthropic avec les 38,0 % de xAI. Ce n'est pas la même cellule de Terminal-Bench.
- Anthropic, Opus 5.5 en xhigh, Astra en high comme OpenAI l'a rapporté : Terminal-Bench 4.0 est à 66,4 % pour Opus 5.5 et à 57,9 % pour Astra. Fable 5.1 est à 55,8 % sur cette page. CursorBench 4.0 est à 57,8 % pour Opus 5.5 et à 51,8 % pour Fable. La cellule CursorBench d'Astra est vide.
- Tableau xAI : Terminal-Bench 4.0 est à 38,0 % pour Grok 4.7 xhigh et à 57,9 % pour Fable 5.1 Max. CursorBench est à 46,3 % pour Grok et à 51,8 % pour Fable. Astra n'est pas sur ce tableau. La cellule CursorBench de Fable, à 51,8 %, est la même que chez Anthropic. La cellule Terminal-Bench de Fable ne l'est pas : 57,9 % d'un côté, 55,8 % sur la page d'Anthropic.
- Artificial Analysis, un troisième montage : Opus 5.5 à 59,6 % sur Terminal-Bench 4.0, au niveau d'Astra en xhigh. Sur le run agent de ce labo, Grok passe de 18 % à 33 %, pas à 38,0 %.
CursorBench se compare à lui-même, parce que 51,8 % apparaît deux fois. Opus 5.5 à 57,8 % devance Fable de 6,0 points sur le chiffre d'Anthropic à effort plus élevé. Grok à 46,3 % est 5,5 points derrière cette cellule Fable. Astra n'a pas de cellule. Cite le labo à côté du pourcentage. Sans ça, le classement est un collage.
EEBench, Harvey et HealthBench sont des lignes xAI. Opus 5.5 et Astra en sont absents. Ces lignes restent dans l'article Grok. AutomationBench et Terminal-Bench-Science sont des lignes Anthropic et OpenAI. Grok en est absent. Ces lignes-là restent dans les articles Opus et Astra.
Ce que chaque article existant garde encore
Cette page ne remplace pas les trois articles vers lesquels elle renvoie. Elle classe seulement les trois modèles entre eux.
- L'article Opus 5.5 garde la baisse à $4/$20, le compteur à $0.02719, la limite de cinq heures et le repli cyber vers Opus 4.8. Sa couverture reste le graphique d'Anthropic. Les colonnes Astra se lisent ici.
- L'article Grok 4.7 garde 4.7 contre 4.6 : douze appels, 12/12 et le seuil à $2/$6. La barre à 1 695 reste dans cet article. Opus 5.5 n'y est pas.
- L'article Astra garde Astra contre Fable 5.1, y compris le HTTP 400 du 4 septembre et l'écart 99,9 % contre 62,7 %. On a pu l'appeler le 22 septembre. La décision Fable n'a pas changé.
Lequel des trois épingler
Épingle Grok 4.7 quand tu optimises la facture de sortie et que la tâche tient dans 500 000 tokens. Épingle Opus 5.5 quand tu optimises la ligne GDPval partagée. Épingle Astra quand tu as déjà mesuré une tâche de computer-use ou de maths que les deux autres articles documentent et que tu peux payer $10/$50.
- Appels courts sans cache, comme ces six : Grok a été le moins cher au total, à $0.0038784 contre $0.005292 et $0.00709. Sur la facture, c'était le plus cher, parce que le raisonnement est monté à 295 tokens. Si tes appels courts ressemblent à
merge_intervals, copie la ligne de la fonction. S'ils ressemblent à un nombre sur une ligne, Opus a dépensé 46 tokens et a gagné cette ligne. - Agents lourds en cache, sous 200 000 tokens de prompt : Opus à $0.20 le million de tokens en cache bat les deux. Astra à $1.00 est à 5× cette ligne. La ligne cache xAI de Grok est à $0.50, soit 2,5× Opus.
- Prompts au-dessus de 200 000 tokens : Grok bascule toute la requête sur le palier du haut. Un prompt de 250 000 tokens sur la carte xAI coûte $4 et $12, pas $2 et $6. Le seuil d'Astra commence plus tard, à 272 000. Les tokens sous cette ligne gardent le tarif bas, là où la doc de Grok fait basculer la requête entière.
- Travail de bureau que tu acceptes de confier à GDPval : Opus à 1 846, puis Grok à 1 695, puis Astra à 1 542. Les 1 735 de Fable se placent entre Opus et Grok. Cet ordre est celui des labos. Ce n'est pas un score sorti des six appels.
- Travail de terminal : laisse-le hors de ce classement. Choisis le labo dont tu déploies vraiment le runner, puis prends le chiffre de ce labo. Mélanger 66,4 % et 38,0 % ne te dira pas quel binaire appeler.
Questions fréquemment posées
Peut-on appeler GPT-6 Astra sur OpenRouter maintenant ?
Oui, à 22:34 UTC le 22 septembre 2026. L'identifiant openai/gpt-6-astra a renvoyé 1,96 sur la facture et un merge_intervals qui a passé les tests cachés. Le 4 septembre, le même identifiant renvoyait HTTP 400. L'article précédent note ce 400. Celui-ci note l'appel qui a marché. Le contexte sur la fiche était de 1 050 000 tokens.
xAI a-t-il baissé Grok 4.7 sous $2 et $6 ?
Ce n'est pas le cas sur la carte de lancement que cette page cite. Le tableau xAI est toujours à $2 et $6 sous 200 000 tokens de prompt, puis à $4 et $12. Pendant ces appels, le catalogue OpenRouter était à $1.60 et $4.80, puis à $3.20 et $9.60, soit 0,8× ces lignes. La facture des six appels utilise le chiffre OpenRouter. Une facture que tu paies à xAI en direct suit encore la carte xAI, tant qu'il ne la change pas.
Pourquoi Grok est-il absent du graphique de benchmark d'Anthropic ?
Le graphique d'Anthropic du 22 septembre compare Opus 5.5 à Fable 5.1, Opus 5, GPT-6 Astra et GPT-5.6 Sol. Grok n'est pas une colonne. Le graphique xAI compare Grok 4.7 à Grok 4.6, Sol et Fable. Opus 5.5 n'est pas une colonne. Le recoupement, c'est GDPval : les deux pages impriment Fable à 1 735 et Astra à 1 542.
Le compteur à six appels dit-il qu'Opus 5.5 est plus intelligent ?
Non. Les trois ont réussi les deux tâches. Le compteur est une facture et un décompte de tokens. GDPval est le score des labos et il place bien Opus 5.5 premier de ces trois, à 1 846 contre 1 695 et 1 542. Une fonction de fusion réussie ne confirme pas 1 846, et 1 846 ne prédit pas la facture de $0.005292.
Quel modèle a la fenêtre de contexte la plus courte ?
Grok 4.7, à 500 000 tokens sur la fiche OpenRouter. Opus 5.5 est à 1 000 000. Astra est à 1 050 000. Grok bascule aussi dès 200 000 tokens de prompt, donc la fenêtre utile au tarif bas est plus petite que 500 000. Le tarif plus élevé d'Astra commence à 272 000 et porte sur les tokens au-dessus de cette ligne, plus un multiplicateur de 1,5× sur la sortie.