Claude Sonnet 5.5: stesso prezzo di $2/$10, ma il risparmio del 30% si vede solo sui lavori lunghi
Anthropic ha pubblicato Claude Sonnet 5.5 il 28 settembre 2026 esattamente al prezzo di Sonnet 5: $2 per milione di token in input, $10 per milione in output. Il giorno dopo abbiamo fatto passare 19 chiamate valutate da OpenRouter. Su un lungo file HTML il conto è sceso dell'11,1%. Su una somma di fattura minuscola è salito del 12,8%.
Stesso prezzo. Conto diverso.
Cosa è cambiato con l'uscita di Claude Sonnet 5.5 il 28 settembre?
Cambia l'id del modello in claude-sonnet-5-5 e la tariffa per token resta a $2 in input e $10 in output.
La pagina dei prezzi di Anthropic elenca Sonnet 5.5 e Sonnet 5 su righe identiche, cache e batch compresi: ogni differenza di costo tra i due è quindi un conteggio di token.
| Voce | Sonnet 5.5 al lancio |
|---|---|
| Id del modello API | claude-sonnet-5-5 |
| Input / output, per 1M di token | $2 / $10 |
| Cache read / cache write | $0.20 / $2.50 (5 min), $4 (1 ora) |
| Batch input / output | $1 / $5 |
| Contesto / output massimo | 1M / 128K token |
| Effort predefinito | Medium in Claude Code e nelle app, High sull'API |
| Disponibilità | Zero data retention; AWS, Google Cloud, Microsoft Azure |
| GitHub Copilot | Pro, Pro+, Max, Business, Enterprise, a prezzo di listino |
Fonti: la pagina del modello Sonnet 5.5 di Anthropic, il post di lancio e il changelog di GitHub. Per il contesto: cosa ha cambiato Sonnet 5 e i prezzi per token dei vari provider.
Quanto si avvicina Sonnet 5.5 a Opus 5.5 nella tabella di Anthropic?
Su quattro righe percentuali su sei Sonnet 5.5 resta sotto Opus 5.5 di meno di tre punti, e la sua unica vittoria cade dentro il margine d'errore.
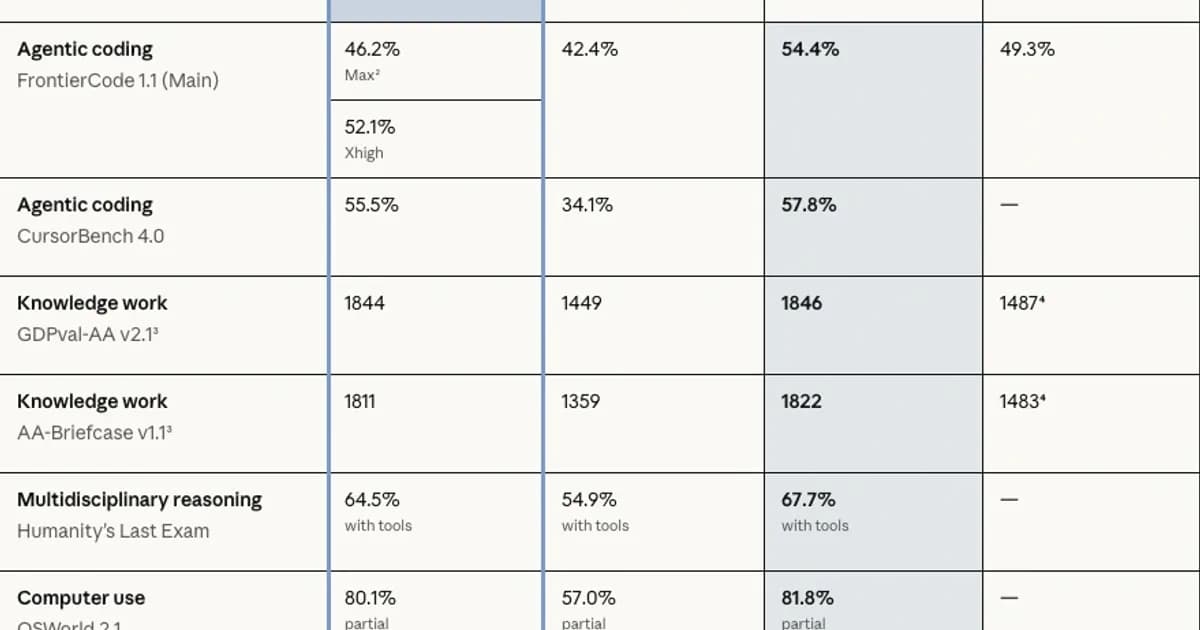
Celle ribattute dall'immagine hero:
| Benchmark | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70,6% | 10,3% | 66,4%¹ | n/d |
| FrontierCode 1.1 Main | 46,2% (Max)², 52,1% (Xhigh) | 42,4% | 54,4% | 49,3% |
| CursorBench 4.0 | 55,5% | 34,1% | 57,8% | n/d |
| GDPval-AA v2.1³ | 1844 | 1449 | 1846 | 1487⁴ |
| AA-Briefcase v1.1³ | 1811 | 1359 | 1822 | 1483⁴ |
| HLE (with tools) | 64,5% | 54,9% | 67,7% | n/d |
| OSWorld 2.1 (partial) | 80,1% | 57,0% | 81,8% | n/d |
| Chartography (no tools) | 61,6% | 15,6% | 64,4% | 53,6%⁴ |
¹ Opus con effort Xhigh. ² Max ha ottenuto meno di Xhigh: ha lanciato più subagenti di code review, che secondo Cognition in due casi hanno causato timeout o modifiche fuori ambito. ³ Eseguito da Artificial Analysis su un deployment pre-release con un bug nell'output strutturato, poi corretto. ⁴ Potrebbe non riflettere un bug nell'immagine di GPT-6 Sol. I grafici Terminal-Bench e CursorBench di Anthropic riportano GPT-5.6 Sol.
FrontierCode (Xhigh) e CursorBench restano indietro di 2,3 punti, OSWorld di 1,7, Chartography di 2,8. HLE fa eccezione con 3,2. Le righe Elo sono distanti 2 e 11.
Quella riga di Terminal-Bench alimenta il thread su r/ClaudeCode «Sonnet 5.5 beats Opus 5.5 at coding and it's half the price??». La system card indica errori standard di ±2,5 e ±2,6 punti, quindi il divario di 4,2 punti vale circa 1,2 errori standard combinati, e Sonnet è stato eseguito a max mentre Opus a xhigh. Artificial Analysis ha misurato Sonnet 5.5 al 64% sullo stesso test. Il vantaggio più ampio di Opus non compare nella pagina di lancio: SWE-Bench Pro, 81,3 contro 89,9.
GPT-6 Sol è solo la colonna che Anthropic ha stampato; per il confronto tra GPT-6 Astra e Opus 5.5 vedi il nostro test a tre.
Il 30% di risparmio di Anthropic sopravvive a 19 chiamate API?
Solo sul lavoro lungo: 11,1% in meno su un compito HTML da 2.564 token di output medi, 10-13% in più su due compiti minuscoli.
Il 29 settembre alle 14:25 UTC abbiamo inviato 19 chiamate valutate tramite OpenRouter a Sonnet 5.5 e Sonnet 5: 3 compiti, 3 prove, 2 modelli, più una chiamata extra a effort alto. Conto totale: $0.183434. Tutte e 18 le chiamate abbinate sono state superate.
# sonnet55_bench.py, 29 Sep 2026, POST https://openrouter.ai/api/v1/chat/completions
body = {
    "model": model,        # anthropic/claude-sonnet-5.5 or anthropic/claude-sonnet-5
    "messages": messages,
    "max_tokens": max_tokens,         # 12000 on the HTML task
    "reasoning": {"effort": effort},  # low: invoice, merge_intervals; medium: HTML
}
Nessun LLM ha valutato nulla. La fattura (800k token di cache read, 200k di input, 50k di output) doveva restituire esattamente 1.06, merge_intervals ha eseguito 6 assert, e l'HTML richiedeva doctype, canvas, requestAnimationFrame e nessuno script esterno. I costi sono usage.cost sommato su 3 prove.
| Compito (effort) | Sonnet 5.5 | Sonnet 5 | Delta | Token di output medi | Latenza media |
|---|---|---|---|---|---|
| Fattura (low) | $0.002754 | $0.002442 | +12,8% | 71 / 61 | 2,63 s / 4,49 s |
| merge_intervals (low) | $0.006054 | $0.005502 | +10,0% | 172 / 154 | 3,06 s / 3,68 s |
| HTML con 150 uccelli (medium) | $0.077508 | $0.087156 | -11,1% | 2.564 / 2.886 | 15,54 s / 21,61 s |
| Totale abbinato | $0.086316 | $0.0951 | -9,2% | n/d | n/d |
Anthropic promette «fino al 30% in meno per compito rispetto al predecessore». Matthias Bastian di The Decoder ha aggiunto la precisazione giusta: «Independent testing still needs to confirm these claims», cioè servono test indipendenti per confermare queste dichiarazioni.
Nel nostro contatore da 19 chiamate a effort low e medium, con un solo compito lungo, il risparmio è stato del -11,1% sull'HTML ed è diventato +12,8% e +10,0% sui compiti minuscoli. Con lo stesso prezzo di listino ogni risparmio è un conteggio di token, e sui nostri due compiti più piccoli Sonnet 5.5 ha scritto più token, non meno.
La velocità ha tenuto meglio. La latenza dell'HTML è scesa del 28,1% e il throughput è passato da 133,5 a 165,0 token al secondo (+23,6%): direzione giusta, un po' sotto il 30%. Sonnet 5 ha inoltre registrato 54-63 token di reasoning per chiamata sulla fattura; Sonnet 5.5 ne ha registrati 0 su tutte e 10 le chiamate.
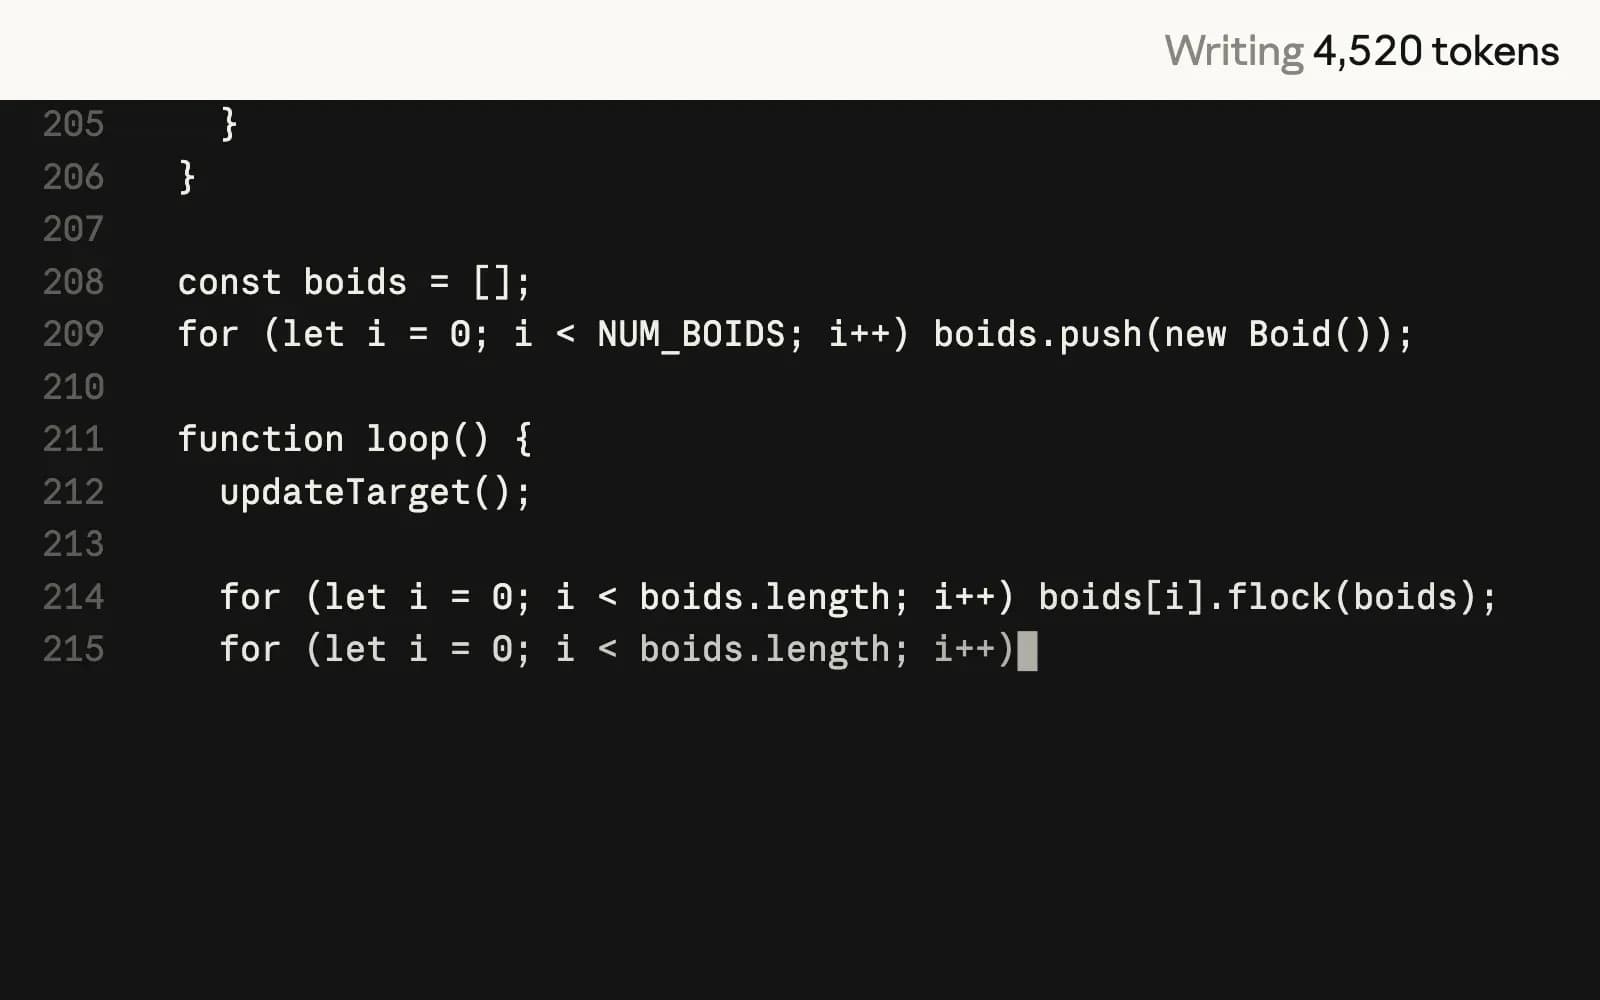
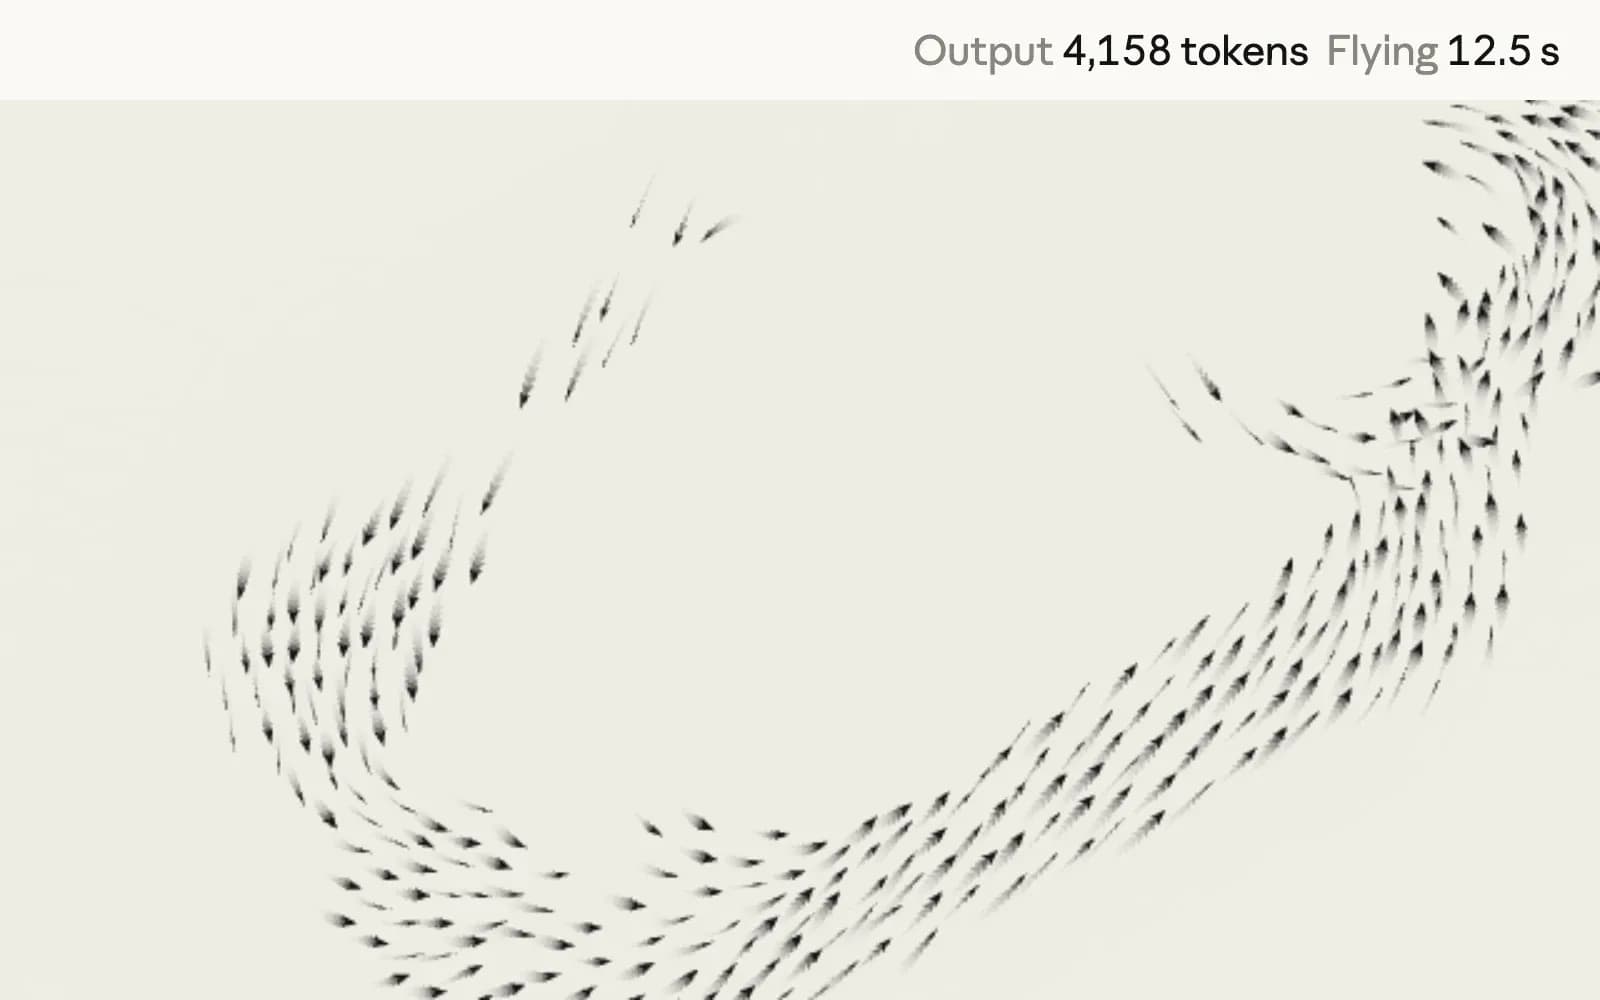
Quel compito HTML è una versione con 150 uccelli del prompt dimostrativo da 400 storni della pagina di lancio di Anthropic. I fotogrammi qui sotto sono la registrazione di Anthropic, non la nostra esecuzione.
Cosa hanno riferito i tester del lancio di Anthropic
«Senza cambiare nessuno dei nostri prompt, Claude Sonnet 5.5 ha fatto meglio di Sonnet 5 su quasi tutte le nostre valutazioni offline di Slackbot, con meno passaggi e circa il 14% di token di output in meno.» Curtis Allen, Principal Engineer, Slack
«Il nuovo modello ha gestito decine di migliaia di righe di codice per l'architettura dei sistemi di gioco, ha mantenuto risposte scattanti, ha retto compiti di più ore e ha consegnato con prompt meno prescrittivi.» Daniel Vogel, Chief Operating Officer, Epic Games
Entrambe sono testimonianze raccolte dal fornitore e riguardano lavori lunghi e a più passaggi. I nostri compiti minuscoli sono andati nella direzione opposta.
Non misurati: il lavoro agentico, i benchmark qui sopra, il fallback cyber. 3 prove sono un contatore a campione; per fare il tuo, leggi usage a ogni chiamata.
Perché l'effort sposta il conto più del modello?
Artificial Analysis ha misurato $0.59 per compito a medium e $7.60 a max, un salto di 13 volte per 15 punti di indice.
A max ha contato «~193k Output Tokens per Intelligence Index Task. This is the highest token use we have measured», cioè il maggior uso di token mai misurato.
| Effort | Costo per compito AA | AA Intelligence Index | Posizione AA, 29 set |
|---|---|---|---|
| Low | $0.41 | 36 | 63 su 216 |
| Medium | $0.59 | 41 | 44 su 216 |
| High | $1.08 | 47 | 23 su 216 |
| Max | $7.60 | 56 | 3 su 216 |
Le righe vengono dalle pagine per effort di AA, consultate il 29 settembre. L'articolo di lancio di AA dava a Sonnet 5.5 il secondo posto nell'indice; la pagina del modello quel giorno mostrava 56, posizione 3 su 216. Max costava inoltre «~50% higher than Sonnet 5's Cost per Task», circa il 50% in più per compito rispetto a Sonnet 5.
La nostra chiamata a effort alto ha ignorato l'impostazione: merge_intervals con effort=high è costato $0.002018 per 172 token di output, identico a low. L'effort incide solo su lavori abbastanza grandi da richiedere ragionamento, ed è da lì che parte il taglio della spesa per le API LLM.
Cosa restituisce un 400 dopo aver cambiato l'id del modello?
Ogni richiesta con il thinking disattivato fallisce; cambialo in between_tools e tieni l'effort a high o sotto.
La guida alla migrazione di Anthropic descrive l'errore:
# Before (Sonnet 5 habit): 400 invalid_request_error on claude-sonnet-5-5
thinking = {"type": "disabled"}
# '"thinking.type.disabled" is not supported for this model. Use
#  "thinking.type.between_tools" for the lowest thinking setting, ...'

# After: accepted at low / medium / high effort, 400 at xhigh / max
thinking = {"type": "between_tools"}
output_config = {"effort": "medium"} # fixed for the conversation under between_toolstool_choiceconanyotoolrestituisce 400. Usaautopiùstrict: true(massimo 20 strumenti strict), oppure soloautosu Amazon Bedrock.- I blocchi di thinking di Opus 5, Opus 5.5, Fable o Mythos vengono scartati in silenzio; gli account creati dal 31 agosto 2026 in poi ricevono un 400 se riproponi un blocco dopo aver modificato la cronologia. Il meccanismo è lo stesso del vincolo dei blocchi di thinking di Fable 5.1.
- Il computer use richiede
computer_toolset_20260801sulla Claude API e su Google Cloud. - I rifiuti indicano una categoria in
stop_details, tra cuicyber,frontier_llm(«could assist the development of competing AI models», cioè potrebbe aiutare lo sviluppo di modelli di IA concorrenti) ereasoning_extraction. - Il fallback lato server (
fallbacks: "default", beta, solo Claude API) riprova su Sonnet 5 i rifiuticyberefrontier_llm; secondo la system card l'1,2% delle richieste Terminal-Bench è finito in fallback. - Il minimo di prompt memorizzabile in cache scende a 512 token da 1.024 (soglie minime del prompt caching), e
/claude-api migratein Claude Code applica queste modifiche.
I team di sicurezza incontrano per primo il punto 4. Un commentatore di HN, johnmlussier, ha scritto che pur essendo nel Cyber Verification Program «can't use Opus 5.5 or Sonnet 5.5 for any authorized bounty work», cioè non può usare né Opus 5.5 né Sonnet 5.5 per alcun lavoro di bounty autorizzato. Anthropic dice che il programma esteso arriverà «presto» (nel testo originale, «Soon»).
La stessa checklist dice «Re-run your effort sweep, and re-baseline cost», ovvero ripeti la scansione degli effort e ricalcola la base dei costi. Fallo prima di fidarti del 30%.
Sonnet 5.5 o Opus 5.5: quale merita lo slot predefinito?
Usa Sonnet 5.5 come predefinito per il codice ben delimitato e le chiamate ad alto volume; tieni Opus 5.5 per il giudizio aperto e per ogni lavoro a effort max.
Sonnet costa la metà di Opus 5.5, che è a $4/$20, eppure Artificial Analysis ha misurato Sonnet a max a $7.60 per compito contro i $5.98 di Opus 5.5, circa il 27% in più.
| Segnale | Sonnet 5.5 | Opus 5.5 | Vince |
|---|---|---|---|
| Input / output per 1M | $2 / $10 | $4 / $20 | Sonnet, metà prezzo |
| Cache read / write a 5 min | $0.20 / $2.50 | $0.20 / $5 | Pari sulle letture |
| Mix con molta cache (sotto) | $1.06 | $1.96 | Sonnet, 1,85x e non 2x |
| Costo per compito AA, effort max | $7.60 | $5.98 | Opus, 27% in meno |
| SWE-Bench Pro | 81,3% | 89,9% | Opus di 8,6 punti |
Mix: 800k cache-read + 200k input + 50k output tokens
Sonnet 5.5: 0.8 x $0.20 + 0.2 x $2 + 0.05 x $10 = $0.16 + $0.40 + $0.50 = $1.06
Opus 5.5:   0.8 x $0.20 + 0.2 x $4 + 0.05 x $20 = $0.16 + $0.80 + $1.00 = $1.96
Ratio: 1.96 / 1.06 = 1.85x
Il «circa 1,65×» di Aleksei Aleinikov dipende da un mix che lui non dichiara. Inserisci il tuo: più alta è la quota di cache, più piccolo è il vantaggio di Sonnet.
Anthropic stessa dice che «Opus 5.5 remains clearly stronger at complex, open-ended work requiring sustained judgment», cioè resta nettamente più forte nel lavoro complesso e aperto che richiede giudizio prolungato. Un commentatore di HN, datadrivenangel, è andato oltre: «Opus 5.5 on Low seems smarter, cheaper, and faster than sonnet on medium». Non testato da noi. Prezzi e limiti di Opus sono nella nostra analisi di Opus 5.5.
Il nostro predefinito dal 29 settembre: claude-sonnet-5-5 a effort medium. I lavori a effort max vanno a Opus 5.5, perché a max Sonnet smette di essere il modello economico.
Domande frequenti
Quando è uscito Claude Sonnet 5.5?
Anthropic ha rilasciato Claude Sonnet 5.5 il 28 settembre 2026 come claude-sonnet-5-5, lo stesso giorno su Amazon Web Services, Google Cloud, Microsoft Azure e GitHub Copilot. Secondo la documentazione di Anthropic non verrà ritirato prima del 28 settembre 2027.
Claude Sonnet 5.5 costa meno di Sonnet 5?
Non per token: entrambi sono a listino $2 in input e $10 in output. Nel nostro contatore un lungo compito HTML è costato l'11,1% in meno su Sonnet 5.5 e un piccolo compito di fattura il 12,8% in più; a effort max Artificial Analysis ha misurato circa il 50% in più per compito.
Posso usare Sonnet 5.5 in Claude Code e GitHub Copilot?
Sì. Claude Code lo imposta a effort Medium; l'API a High. In GitHub Copilot, da Pro a Enterprise, è «billed at provider list pricing under usage-based billing», cioè fatturato a prezzo di listino del provider con fatturazione a consumo. Per fissarlo, vedi come cambiare modello in Claude Code.
Qual è la finestra di contesto di Sonnet 5.5 e il suo knowledge cutoff?
Accetta 1M di token di contesto e restituisce fino a 128K token di output, con un knowledge cutoff affidabile a giugno 2026 secondo la system card.
Esiste un Haiku 5.5?
Non al 29 settembre 2026. Anthropic ha dichiarato il 28 settembre che Claude Haiku 5.5 «will join the Claude 5.5 family in the coming weeks», cioè si unirà alla famiglia Claude 5.5 nelle prossime settimane.