Claude Opus 5.5: prezzo $4/$20, i limiti e cosa abbiamo misurato
Claude Opus 5.5 è uscito il 22 settembre 2026 a $4 per milione di token di input e a $20 per milione di token di output. Le cache read costano $0.20. Rispetto a Claude Opus 5 è il 20% in meno su input e output, e il 60% in meno sulle cache read ($0.50). L'id sulla piattaforma è claude-opus-5-5. Alle 18:57 UTC OpenRouter aveva già in listino anthropic/claude-opus-5.5, con le stesse tre tariffe e un contesto da 1.000.000 token.
Nove chiamate valutate sono uscite tra le 18:57 e le 18:58 UTC. Otto avevano la controparte su Opus 5, con effort=low. Sono passate tutte e otto. Opus 5.5 ha fatturato $0.010564. Opus 5 ha fatturato $0.01269.
La nona, Opus 5.5 con effort=high, è passata anche lei e ha fatturato $0.003936. Totale dell'esperimento: $0.02719. La cover è il grafico di Anthropic, preso dalla pagina di lancio e salvato così com'è.
Prezzo API di Claude Opus 5.5 rispetto a Opus 5
Il traffico pieno di cache è il punto in cui la scheda nuova si muove. Sul nostro meter le chiamate senza cache sono scese solo di circa il 20%.
La tabella di lancio di Anthropic, riprodotta sotto e nello screenshot dei prezzi, è la scheda standard. Fable 5.1 resta a $10/$50. La sua cache read è $0.25, quindi la riga di Opus 5.5 la batte di $0.05 per milione, non della metà. Il rapporto di 2,5× sta su input e output: $10/$4 e $50/$20.
| Voce, per 1M di token | Opus 5.5 | Opus 5 | Fable 5.1 |
|---|---|---|---|
| Input | $4 | $5 | $10 |
| Output | $20 | $25 | $50 |
| Cache read | $0.20 | $0.50 | $0.25 |
| Scrittura cache, 5 min | $5 | $6.25 | $12.50 |
| Scrittura cache, 1 ora | $8 | $10 | $20 |
| Batch OpenRouter, input / output | $2 / $10 | $2.50 / $12.50 | $5 / $25 |
| Fast mode, input / output | $8 / $40 | non su questa scheda | non su questa scheda |
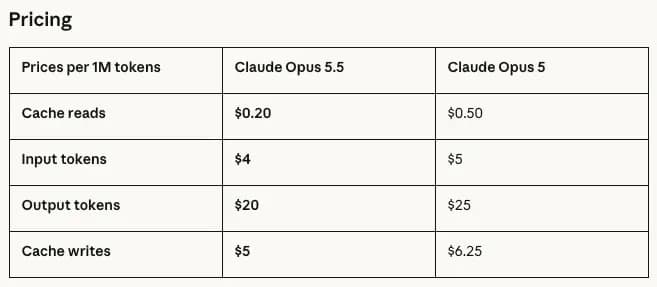
La scrittura cache a 5 minuti ($5 contro $6.25) è sulla pagina di Anthropic e nella nota di Artificial Analysis.
La scrittura a 1 ora ($8) e il percorso batch ($2/$10, cache read $0.10) stanno nel payload /api/v1/models di OpenRouter alle 18:57 UTC. La tabella di lancio quelle righe non le stampa.
Il fast mode è sulla pagina di lancio: fino a 2,5× di velocità, a $8 e $40. È il doppio del prezzo di Opus 5.5 standard, e sta sopra i $5/$25 di Opus 5.
Nove chiamate valutate, e la fattura che hanno prodotto
Tutte e 8 le chiamate abbinate sono passate. Opus 5.5 è costato $0.010564 contro i $0.01269 di Opus 5, un taglio del 16,8%.
Chat completions su OpenRouter. Nessuna temperature. reasoning.effort era low, e una chiamata di coding era a high.
Due task, due trial ciascuno. I grader controllavano la corrispondenza esatta ed eseguivano i test. Token in cache: 0. Prompt della fattura: 104 token.
# 22 Sep 2026, 18:57 UTC, OpenRouter
MODELS = ["anthropic/claude-opus-5.5", "anthropic/claude-opus-5"]
# invoice answer must be 1.96
# 800_000 * 0.20/1e6 + 200_000 * 4/1e6 + 50_000 * 20/1e6
# coding: merge_intervals, hidden tests, function only| Set | Opus 5.5 | Opus 5 |
|---|---|---|
| Fattura, 2 trial | 2/2, $0.002652, 45 e 46 out, 3,089s e 5,100s | 2/2, $0.00332, 46 e 46 out, 6,765s e 3,997s |
| merge_intervals, 2 trial | 2/2, $0.007912, 168 e 168 out, 3,597s e 3,239s | 2/2, $0.00937, 161 e 155 out, 3,435s e 3,582s |
| Totale abbinato | $0.010564, 8/8 | $0.01269, 8/8 |
| effort=high, 1 chiamata di coding | passata, $0.003936, 167 out, 0 token di reasoning | non eseguita |
La coppia sulla fattura è il caso pulito del 20%: costa il 20,1% in meno, con quasi lo stesso numero di completion. La coppia sulla funzione è il punto in cui il conto non torna. Opus 5.5 ha scritto 336 token di completion contro 316, e la fattura è scesa solo del 15,6%. Il listino è calato del 20%. I token, però, sono aumentati, e il risparmio netto si è ristretto. effort=high non ha allungato quella funzione: 167 token di completion, 0 token di reasoning, $0.003936, test passati. Artificial Analysis ha visto l'altro regime, circa 119.000 token di output per task dell'Intelligence Index al massimo contro circa 73.000 di Opus 5, con il costo per task ancora fermo. Non segnarti uno sconto del 40% in quel regime. Le nostre 9 chiamate non ci sono entrate.
Su questo campione la latenza è un pareggio. Medie sul coding: 3,42s e 3,51s. Medie sulla fattura: 4,09s e 5,38s. Gli intervalli si sovrappongono, 5,100s contro 3,997s.
Anthropic dice che l'output è oltre il 30% più veloce di Opus 5. Queste 9 chiamate non lo mostrano.
Dove il grafico di Anthropic è avanti, e dove no
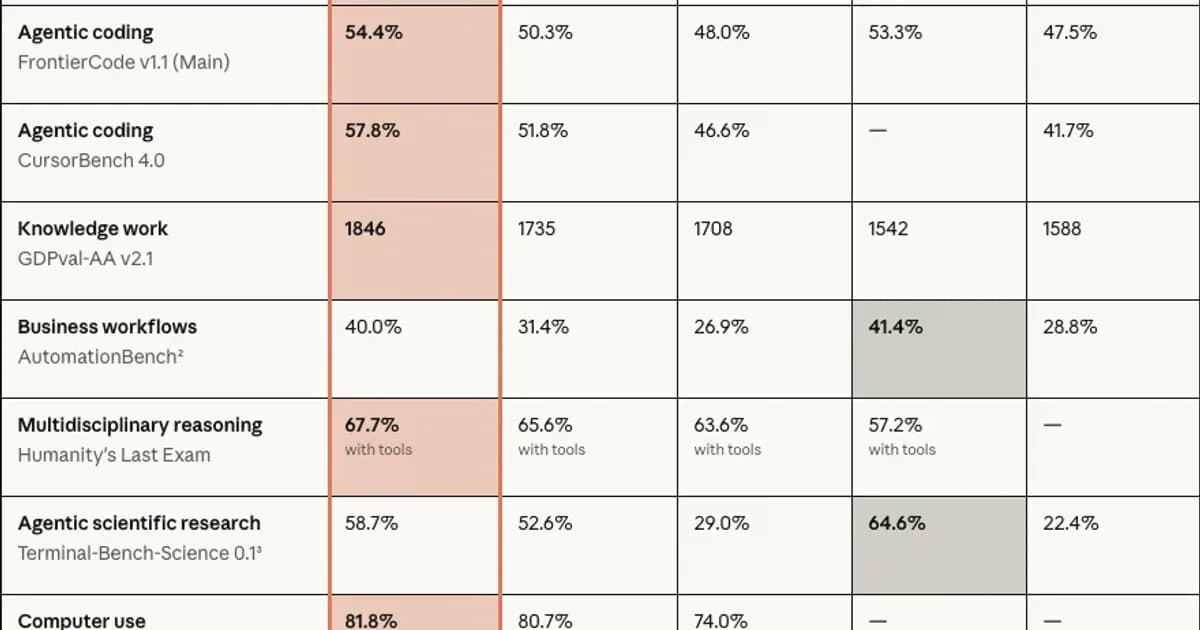
Astra è avanti su due righe con un numero: AutomationBench al 41,4%, e Terminal-Bench-Science al 64,6%.
Ogni altra cella numerata del grafico del 22 settembre è a favore di Opus 5.5. La cover è proprio quel grafico. Le celle sotto sono copiate da lì.
Anthropic dice che questi numeri di Opus 5.5 usano adaptive thinking con effort al massimo, con una postilla: su Terminal-Bench 4.0, Opus 5.5 è a xhigh e GPT-6 Astra è a high, e la cifra di Astra è quella riportata da OpenAI.
| Benchmark | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 66,4% | 55,8% | 52,3% | 57,9% | 37,3% |
| FrontierCode v1.1 (Main) | 54,4% | 50,3% | 48,0% | 53,3% | 47,5% |
| CursorBench 4.0 | 57,8% | 51,8% | 46,6% | n/a | 41,7% |
| GDPval-AA v2.1 | 1.846 | 1.735 | 1.708 | 1.542 | 1.588 |
| AutomationBench | 40,0% | 31,4% | 26,9% | 41,4% | 28,8% |
| Humanity's Last Exam, con tool | 67,7% | 65,6% | 63,6% | 57,2% | n/a |
| Terminal-Bench-Science 0.1 | 58,7% | 52,6% | 29,0% | 64,6% | 22,4% |
| OSWorld 2.0, parziale | 81,8% | 80,7% | 74,0% | n/a | n/a |
| Chartography, con tool | 89,0% | 88,4% | 83,4% | n/a | n/a |
Leggi le note prima di spostare traffico per un punto di differenza.
- Le salvaguardie sono rimaste accese. Il fallback cyber era Opus 4.8. Il fallback su biologia e sugli LLM di frontiera era Opus 5. Anthropic dice che questo può abbassare il punteggio.
- Zapier ha fatto girare AutomationBench senza fallback, quindi un intervento contava come miss. Il 40,0% è early access. Il 41,4% di Astra è la board pubblica.
- L'errore su Terminal-Bench 4.0 è di ±2,6 punti. 66,4 contro 57,9 lo supera. FrontierCode, 54,4 contro 53,3, no.
- Anthropic dice che il divario nell'uso di tutti i giorni, rispetto a Fable 5.1, è più stretto di questo grafico.
- Artificial Analysis, lo stesso giorno e con un altro setup: Terminal-Bench 4.0 al 59,6%, in pari con Astra a xhigh, e Humanity's Last Exam al 61,4% contro il 59,1% di Fable 5.1. Non fare la media tra 66,4 e 59,6.
L'effort di default è un'altra riga. FrontierCode a medium è al 54,6%. CursorBench a medium è al 52,5%, non al 57,8% della tabella. Anthropic dice che quel FrontierCode a medium batte il meglio di Astra a circa un quinto del costo per task.
Limiti di Claude Opus 5.5 che il prezzo da $4 non toglie
I task cyber finiscono su Opus 4.8, e il thinking resta acceso su ogni account API.
La scheda più bassa non ha tolto i vincoli che hanno reso scomodi, in produzione, gli ultimi due lanci di Claude. Cosa è cambiato il 22 settembre, e cosa no:
- I limiti di cinque ore salgono su Pro, Max, Team ed Enterprise a posti, e c'è un reset che puoi salvare. Nessun nuovo conteggio di messaggi. Il tetto settimanale non è descritto come eliminato. Le regole precedenti sulle finestre stanno nel pezzo sui limiti di utilizzo.
- Le salvaguardie su cyber, biologia e distillation sono quelle della classe Fable. La correzione dei bug di routine resta. La maggior parte dei task cyber viene reinstradata su Opus 4.8. Per la biologia serve il Life Sciences Verification Program. Il programma cyber più ampio non era aperto il giorno del lancio.
- Non puoi spegnere il thinking. La pagina di lancio rimanda alla documentazione del modello per questo vincolo. Il preserved thinking, il controllo anti-distillation di Fable 5.1, impedisce a chi usa l'API di modificare il reasoning precedente. Vale per Opus 5.5 sugli account API creati dal 31 agosto 2026 in poi.
- Il modello ha un watermark per l'EU AI Act. La zero data retention c'è ancora, come sui modelli Opus di prima.
- I tentativi di superare il confine di containment sono calati di circa l'85% rispetto a Opus 5 e a Mythos 5.1, dice Anthropic, e il resto era a bassa gravità e auto-segnalato. Il modello spesso sospetta di essere dentro un'eval, quindi quell'audit predice male la produzione.
- Sonnet 5.5 e Haiku 5.5 oggi non sono nell'API. La pagina dice che arrivano nelle prossime settimane. Nessuna data.
Se il tuo carico è offensive security o design wet-lab, il prezzo da $4 non compra un Opus 5.5 senza vincoli. Il classificatore spende parte di quelle chiamate su un modello più vecchio, e la trace deve mostrare il fallback, altrimenti fatturi l'id sbagliato.
Cosa hanno detto ad Anthropic i primi tester
GitHub, Optiver e Box riportano meno token di Opus 5. Quelle frasi sono citazioni pubblicate da Anthropic.
Sono note firmate di early access, non una board indipendente. @claudeai ha postato alle 16:31 UTC. Le risposte della stessa ora lodavano il margine su Pro e il debugging. Nessuna trace condivisa.
| Chi, sulla pagina di lancio | Cosa ha detto | Cosa non dimostra |
|---|---|---|
| Mario Rodriguez, GitHub | Il conteggio di token più basso che hanno misurato. Task da terminale in VS Code in meno della metà dei passi di Opus 5. | Nessun log pubblico. |
| Noyan Tokgozoglu, Optiver | Qualità di Opus 5 in circa metà dei turni, metà del tempo e metà dei token di output. Costo giù dal 40% al 50%. | Il loro desk. Il nostro taglio è stato il 16,8%, cache a 0. |
| Yashodha Bhavnani, Box | Un terzo dei token, 40% meno prolisso, accuratezza invariata. | La loro eval sui contenuti. |
| Zimu Li, Factory | Medium ha pareggiato Opus 5 a high, con dal 20% al 25% di token di output in meno. | Il nostro pin a high non ha ridotto i token. |
| Fabian Hedin, Lovable | Da un terzo a metà passi in meno, e meno token. | Il loro loop nel builder, non la scheda API. |
Le citazioni descrivono meno passi e meno token, un taglio più grande del 20% sul listino. La nostra funzione ha fatto l'opposto: 336 token di completion contro 316.
Possono essere vere entrambe. Anthropic dice che un audit da 200.000 righe è finito in meno di 3 ore, contro oltre 20 per Opus 5, con 2,5× meno token. Non l'abbiamo rieseguito.
Cosa fa alla fattura un turno pieno di cache
Una rilettura di 500.000 token di cache scende da $0.25 su Opus 5 a $0.10 su Opus 5.5.
È aritmetica sulle tariffe pubblicate, non una delle 9 chiamate. Quelle chiamate non hanno messo nulla in cache, quindi mostrano solo il taglio del 20% meno i token in più. Metti la dimensione del tuo prefisso. Il mix sposta la percentuale.
| Carico | Opus 5 | Opus 5.5 | Taglio |
|---|---|---|---|
| 500.000 token di cache read | $0.25 | $0.10 | 60% |
| 20.000 input freschi + 8.000 output, senza cache | $0.30 | $0.24 | 20% |
| 500.000 di cache + 20.000 in + 8.000 out | $0.55 | $0.34 | 38% |
| Stessi 20.000 in + 8.000 out in fast mode a $8/$40 | n/a | $0.48 | aumento di prezzo rispetto al 5.5 standard |
Quel 38% sulla terza riga è il modo in cui un taglio del 20% sui token diventa «circa il 40% in meno sui carichi tipici»: un agente pesante sulla cache, impostazioni di default, e meno token. Togli la cache e torni al 20%, finché il modello non scrive di più. Il fast mode va dall'altra parte, $0.48 contro $0.24 sulla fetta senza cache. La riga batch della tabella prezzi ($2/$10) è un prezzo di catalogo. Non abbiamo mandato nessun job batch.
Quale id fissare dopo il 22 settembre
Fissa claude-opus-5-5 per il traffico nuovo degli agenti, tranne quando il task è cyber o di biologia.
Il pezzo di luglio su Opus 5 prezzava un modello di classe Fable alla metà della scheda token di Fable. Dal 22 settembre quella tariffa è superata.
Opus 5.5 toglie un altro 20% da input e output di Opus 5, e il 60% dalle cache read. Le salvaguardie ora seguono Fable 5.1, non la linea Opus più permissiva. Grok 4.7, misurato lo stesso giorno, è una scheda diversa.
- Chiamate API corte e senza cache, come quelle che abbiamo valutato: spostale su Opus 5.5. Pareggio a 8/8. La fattura scende del 16,8% su questo set, e del 20,1% quando i conteggi di completion coincidono.
- Loop di agenti che rileggono un prefisso lungo: spostali anche quelli, e metti a budget una cifra più vicina all'esempio del 38% che al 16,8% della fattura. Controlla che
cached_tokenssulla response non sia zero, altrimenti sei ancora sulla strada del 20%. - Eval di ricerca a effort massimo: tieni il budget vecchio di Opus 5 finché non misuri. Il costo per task dell'Intelligence Index di AA non è sceso insieme al prezzo dei token.
- Offensiva cyber, R&D di biologia, probing in stile distillation: non contare su una risposta di Opus 5.5. Aspettati Opus 4.8 o Opus 5, oppure un rifiuto. I programmi di verifica sono la porta che Anthropic ha indicato.
- Fast mode: paga $8/$40 solo quando 2,5× di velocità vale 2× sul prezzo dei token. Non è la fascia economica.
- Lascia Fable 5.1 fissato solo dove hai misurato un gap di qualità che queste 9 chiamate non vedono. Fable costa 2,5× su input e output. Le cache read sono $0.25 contro $0.20.
Domande frequenti
Qual è l'id API di Claude Opus 5.5?
Sulla Claude Platform l'id è claude-opus-5-5. Su OpenRouter è anthropic/claude-opus-5.5, e il batch è anthropic/claude-opus-5.5:batch. Abbiamo chiamato l'id standard alle 18:57 UTC del 22 settembre 2026. Il contesto in listino è 1.000.000 token. Il fast mode è un prezzo ($8/$40), non un id diverso sulla pagina di lancio.
Claude Opus 5.5 toglie il limite di utilizzo di cinque ore?
No. Il limite di cinque ore sale su Pro, Max, Team ed Enterprise a posti, e puoi salvare un reset. Non è stato pubblicato un numero di messaggi. Il tetto settimanale non è descritto come rimosso. I limiti di token al minuto dell'API sono un meter a parte. Controlla Impostazioni, poi Utilizzo.
Puoi spegnere il thinking su Opus 5.5?
Anthropic dice di no. La pagina del 22 settembre dice che non puoi più spegnere il thinking. Il preserved thinking, sugli account creati dal 31 agosto 2026 in poi, blocca anche la modifica del reasoning precedente. La nostra chiamata con effort=high ha comunque restituito una funzione normale, con 0 token di reasoning sull'oggetto usage di OpenRouter. Fissare l'effort su high non ti fa vedere la catena di pensiero.
Il taglio di costo del 40% vale su ogni carico?
Sulle nostre, no. Otto chiamate senza cache sono costate il 16,8% in meno. La sola coppia della fattura è costata il 20,1% in meno. Un mix calcolato, con 500.000 token di cache read più una completion corta, arriva al 38%. Artificial Analysis dice che i task dell'Intelligence Index a effort massimo costano circa quanto Opus 5, perché i token di output sono cresciuti di circa 1,6×.
Quando escono Claude Sonnet 5.5 e Haiku 5.5?
Anthropic ha detto che entrambi arrivano nelle prossime settimane, sulla pagina del 22 settembre 2026, senza una data. Opus 5.5 era l'unico id 5.5 che siamo riusciti a chiamare quella sera. Per spendere meno, fuori da Opus, resta la scheda precedente di Sonnet o di Haiku.