GPT-6 Astra vs Claude Opus 5.5 vs Grok 4.7: fattura, GDPval e un meter da sei chiamate
GPT-6 Astra, Claude Opus 5.5 e Grok 4.7 erano tutti e tre chiamabili su OpenRouter alle 22:34 UTC del 22 settembre 2026. Sei chiamate valutate, due task, una prova per task, e sono passate tutte. La fattura del gateway è stata $0.01626.
I grafici di lancio non si allineano.
Il tabellone di Anthropic ha Astra e non ha Grok. Il tabellone di xAI ha Fable 5.1 e Sol, più Astra su un grafico Elo. Questa pagina usa solo le ancore condivise e si ferma dove i righelli si dividono.
Il taglio Opus contro Opus 5 resta nel post su Opus 5.5. L'upgrade 4.7 contro 4.6 resta nel post su Grok 4.7. Astra contro Fable resta nel post su GPT-6 Astra.
Tre schede, e la lunghezza del prompt che ne cambia il prezzo
Il token di Astra costa 2,5× quello di Opus 5.5 su input e su output, e 5× sulle cache read. La scheda xAI di Grok sta a metà sull'input e a 0,3× sull'output, finché il prompt non supera i 200.000 token.
Opus 5.5 è la linea a 1,0: $4, $20 e $0.20 per milione.
La scheda del modello di Astra è $10, $50 e $1.00. La scheda di Grok del 21 settembre è $2, $6 e $0.50 sotto i 200.000 token di prompt.
| Voce, per 1M di token, sotto la soglia | Opus 5.5 | GPT-6 Astra | Grok 4.7, scheda xAI |
|---|---|---|---|
| Input | $4 | $10 | $2 |
| Output | $20 | $50 | $6 |
| Cache read | $0.20 | $1.00 | $0.50 |
| Contesto | 1.000.000 | 1.050.000 | 500.000 |
| Soglia | nessuna su questa scheda | 272.000 token di prompt: input e cache 2×, output 1,5× | 200.000 token di prompt: l'intera richiesta passa a $4 / $12 / $1 |
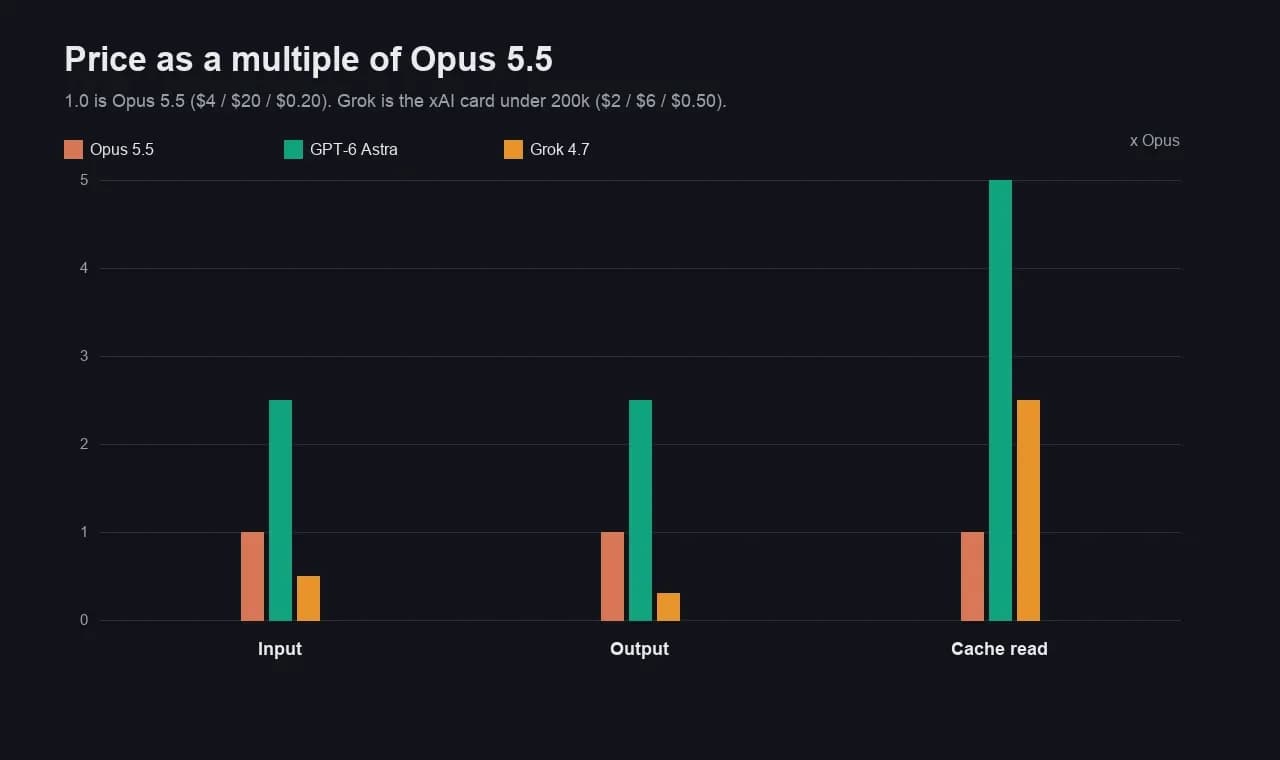
Alle 22:34 UTC OpenRouter aveva le stesse tariffe di Opus e di Astra. Grok no.
Il listino era $1.60, $4.80 e $0.40, poi $3.20, $9.60 e $0.80 a 200.000 token di prompt. È 0,8× la scheda xAI. Le nostre cifre usage.cost usano quel catalogo. Il pezzo su Grok 4.7 tiene ancora la scheda xAI a $2 e $6.
Una rilettura di cache da 500.000 token, solo aritmetica: Opus $0.10, Astra $0.25, la riga cache xAI di Grok $0.25. Sulla cache Astra è il modello caro, non sull'output. Sull'output, i $6 di Grok contro i $50 di Astra sono un divario di 8,3×, e contro i $20 di Opus un divario di 3,3×.
Sei chiamate valutate, e la fattura che ogni modello ha emesso
Tutte e sei sono passate. Le due chiamate di Grok sono costate $0.0038784, Opus 5.5 $0.005292, Astra $0.00709.
La risposta della fattura doveva essere 1,96. merge_intervals doveva passare i test nascosti, compresi gli intervalli che si toccano.
I token in cache erano 0 su Opus e su Astra. Grok ha riportato 1.152 token in cache su entrambe le chiamate, dentro prompt di 1.310 e 1.336 token. 295 dei suoi 298 token sulla fattura erano di reasoning.
# 22 Sep 2026, 22:34 UTC, OpenRouter, one trial, max_tokens 1800
MODELS = [
    "anthropic/claude-opus-5.5",
    "openai/gpt-6-astra",
    "x-ai/grok-4.7",
]| Task | Opus 5.5 | GPT-6 Astra | Grok 4.7 |
|---|---|---|---|
| Fattura, deve essere 1,96 | passata, $0.001336, 46 di output, 4,277 s | passata, $0.00263, 38 di output, 2,116 s | passata, $0.002144, 298 di output, 5,292 s |
| merge_intervals | passata, $0.003956, 168 di output, 3,307 s | passata, $0.00446, 69 di output, 2,588 s | passata, $0.0017344, 204 di output, 4,217 s |
| Totale dei due task | $0.005292 | $0.00709 | $0.0038784 |
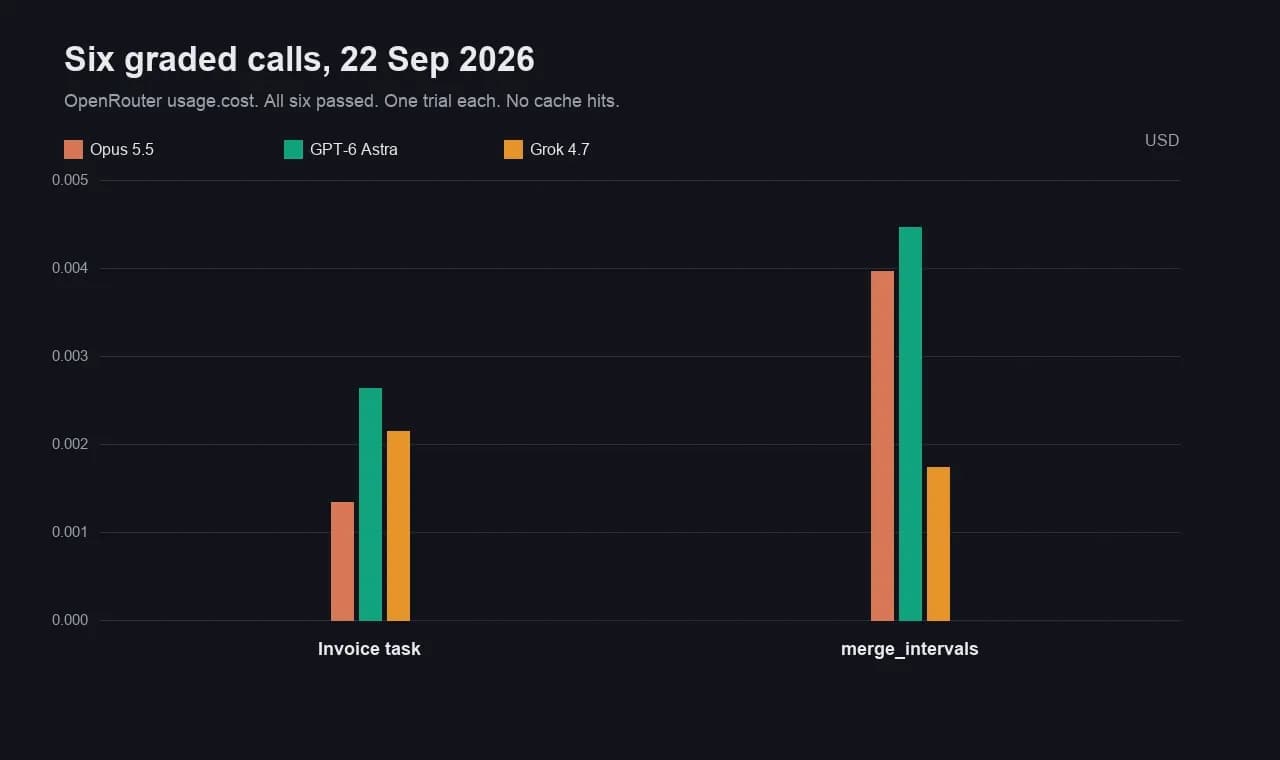
Astra ha scritto meno token di tutti e ha mandato la fattura più alta.
38 e 69 token di completamento, contro i 46 e i 168 di Opus. La scheda a $10/$50 si è mangiata il risparmio. Quelle due cifre usage.cost combaciano esattamente con $10 e $50. Opus combacia con $4 e $20.
Sulla fattura Grok ha perso. Sulla funzione ha vinto. 204 token a $4.80 fanno $0.0017344.
Astra è stato il più rapido su entrambe le prove, 2,116 s e 2,588 s. Una prova sola non fa una classifica di velocità.
Il pezzo su Astra del 4 settembre diceva che openai/gpt-6-astra restituiva HTTP 400. Alle 14:40 UTC di quel giorno era vero. Per l'esecuzione del 22 settembre no. Il gateway ha accettato l'id, la chiamata ha restituito 1,96 e i test sono passati.
GDPval è la riga che i due laboratori condividono davvero
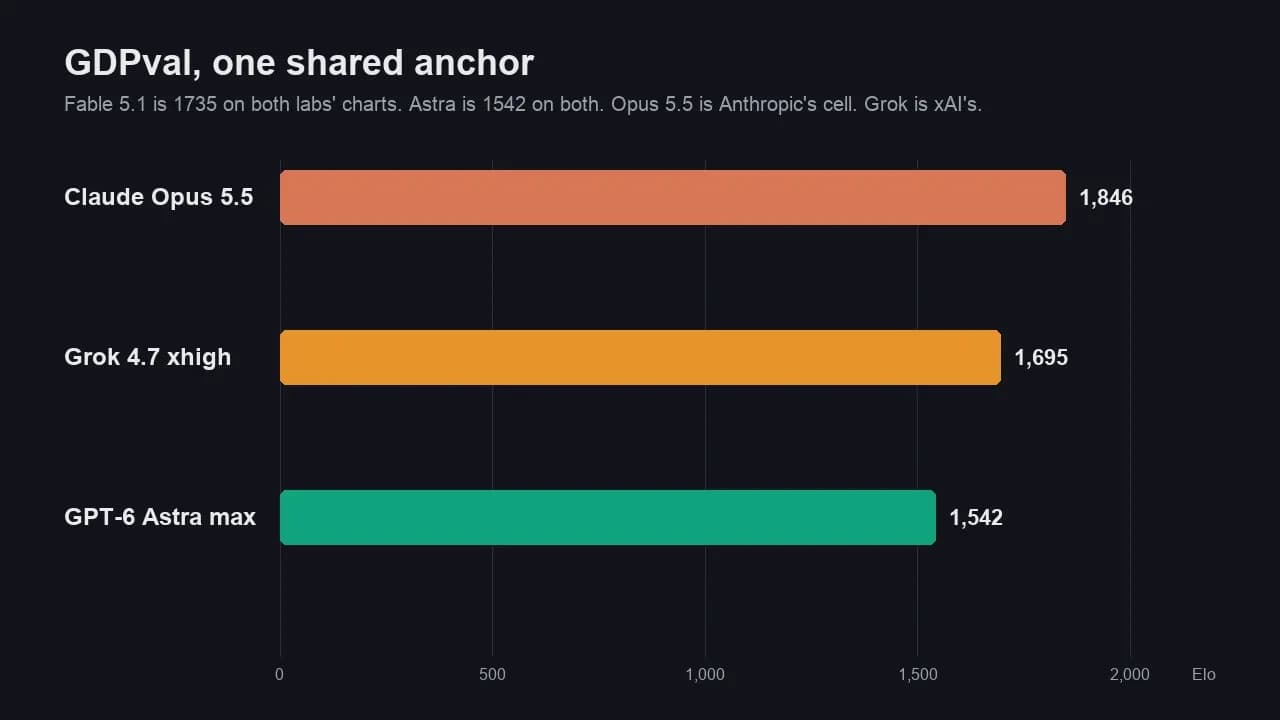
Opus 5.5 è in testa su quella riga condivisa, a 1.846. Grok 4.7 xhigh è a 1.695. Astra max è a 1.542.
Fable 5.1 a 1.735 è l'ancora, non una quarta scelta.
Anthropic stampa 1.735, Astra a 1.542 e Opus 5.5 a 1.846. xAI stampa gli stessi 1.735 e 1.542, e Grok 4.7 xhigh a 1.695. Le barre stanno sullo stesso asse perché quei due numeri sono copiati.
| Cella | Punteggio | Chi lo stampa |
|---|---|---|
| Claude Opus 5.5 | 1.846 | Anthropic, 22 settembre 2026, GDPval-AA v2.1 |
| Grok 4.7 xhigh | 1.695 | Grafico di lancio xAI, 21 settembre 2026, GDPval |
| GPT-6 Astra max | 1.542 | Entrambi i grafici |
| Fable 5.1 max, solo ancora | 1.735 | Entrambi i grafici |
Opus è 151 Elo sopra Grok e 304 sopra Astra. Grok è 153 Elo sopra Astra e 40 Elo dietro l'ancora Fable. Quei distacchi non li abbiamo misurati noi. Le sei chiamate erano una fattura a due decimali e una funzione di merge. Non misurano il lavoro d'ufficio.
Artificial Analysis ha messo Opus 5.5 a 58 sull'Intelligence Index, a effort massimo, e il costo per task è rimasto pari a quello di Opus 5 perché i token di output sono saliti di circa 1,6×. La loro nota su Grok 4.7 mette quel modello a 46 sullo stesso indice. Righello diverso, stessa direzione: Opus davanti a Grok. Non è un motivo per ignorare la fattura dei token.
Terminal-Bench e CursorBench non sono lo stesso righello
Non fare la media tra il 66,4% di Anthropic e il 38,0% di xAI. Non sono la stessa cella di Terminal-Bench.
- Anthropic, Opus 5.5 a xhigh, Astra a high come l'ha riportato OpenAI: Terminal-Bench 4.0 è 66,4% per Opus 5.5 e 57,9% per Astra. Fable 5.1 è 55,8% su quella pagina. CursorBench 4.0 è 57,8% per Opus 5.5 e 51,8% per Fable. La cella CursorBench di Astra è vuota.
- Il tabellone di xAI: Terminal-Bench 4.0 è 38,0% per Grok 4.7 xhigh e 57,9% per Fable 5.1 Max. CursorBench è 46,3% per Grok e 51,8% per Fable. Astra non è su quel tabellone. La cella CursorBench di Fable, 51,8%, combacia con Anthropic. La cella Terminal-Bench di Fable no: 57,9% lì, 55,8% sulla pagina di Anthropic.
- Artificial Analysis, un terzo setup: Opus 5.5 al 59,6% su Terminal-Bench 4.0, pari ad Astra a xhigh. Sul run da agente di quel laboratorio Grok è passato dal 18% al 33%, non al 38,0%.
CursorBench puoi confrontarlo con se stesso: il 51,8% compare due volte. Opus 5.5 al 57,8% sta 6,0 punti sopra Fable, sulla cifra ad effort più alto di Anthropic. Grok al 46,3% sta 5,5 punti sotto quella cella di Fable. Astra non ha una cella. Metti il laboratorio accanto alla percentuale, altrimenti la classifica è un collage.
EEBench, Harvey e HealthBench sono righe xAI. Opus 5.5 e Astra non ci sono. Restano nel post su Grok. AutomationBench e Terminal-Bench-Science sono righe di Anthropic e di OpenAI. Grok non c'è. Restano nei post su Opus e su Astra.
Cosa tiene ancora ogni post già uscito
Questa pagina non sostituisce i tre pezzi a cui rimanda. Serve solo a mettere i tre modelli l'uno contro l'altro.
- Il post su Opus 5.5 tiene il taglio a $4/$20, il meter da $0.02719, il limite di cinque ore e il fallback cyber su Opus 4.8. La cover resta il grafico di Anthropic. Le colonne di Astra le leggi qui.
- Il post su Grok 4.7 tiene 4.7 contro 4.6: dodici chiamate, 12/12, e la soglia a $2/$6. La barra da 1.695 è loro. Opus 5.5 no.
- Il post su Astra tiene Astra contro Fable 5.1, compresi l'HTTP 400 del 4 settembre e lo split 99,9% contro 62,7%. La chiamabilità è cambiata il 22 settembre. La decisione su Fable no.
Quale dei tre fissare
Fissa Grok 4.7 quando il prodotto è la fattura di output e il lavoro sta dentro 500.000 token. Fissa Opus 5.5 quando il prodotto è la riga GDPval condivisa. Fissa Astra quando hai già misurato un lavoro di computer-use o di math che gli altri due post documentano, e puoi pagare $10/$50.
- Chiamate brevi senza cache, come queste sei: Grok è stato il più economico sul totale, $0.0038784 contro $0.005292 e $0.00709, ed è stato il più caro sulla fattura perché il reasoning è arrivato a 295 token. Se le tue chiamate brevi somigliano a
merge_intervals, copia la riga della funzione. Se somigliano a un numero su una sola riga, Opus ha speso 46 token e ha vinto quella riga. - Agenti carichi di cache, sotto i 200.000 token di prompt: Opus a $0.20 per milione di token in cache batte entrambi. Astra a $1.00 è 5× quella riga. La riga cache xAI di Grok è $0.50, 2,5× Opus.
- Prompt che superano i 200.000 token: Grok riprezza l'intera richiesta. Un prompt da 250.000 token sulla scheda xAI è $4 e $12, non $2 e $6. La soglia di Astra parte più tardi, a 272.000, e non riprezza i token sotto la linea, a differenza di quanto descrive la documentazione di Grok.
- Lavoro d'ufficio che affidi a GDPval: Opus a 1.846, poi Grok a 1.695, poi Astra a 1.542, con Fable a 1.735 in mezzo, tra Opus e Grok. Quell'ordine è l'ordine dei laboratori. Non è un punteggio uscito dalle sei chiamate.
- Lavoro da terminale: lascialo fuori da questa classifica. Scegli il laboratorio il cui runner deployi davvero, poi usa il numero di quel laboratorio. Mischiare 66,4% e 38,0% non ti dice quale binario chiamare.
Domande frequenti
Puoi chiamare GPT-6 Astra su OpenRouter adesso?
Sì, alle 22:34 UTC del 22 settembre 2026. L'id openai/gpt-6-astra ha restituito 1,96 sulla fattura e un merge_intervals che ha passato i test nascosti. Il 4 settembre lo stesso id ha restituito HTTP 400. Il post precedente registra quel 400. Questo registra la chiamata che ha funzionato. Sul listino il contesto era di 1.050.000 token.
xAI ha tagliato Grok 4.7 sotto $2 e $6?
No, non sulla scheda di lancio che questa pagina cita. La tabella xAI è ancora $2 e $6 sotto i 200.000 token di prompt, poi $4 e $12. Il catalogo OpenRouter durante questa esecuzione era $1.60 e $4.80, poi $3.20 e $9.60, cioè 0,8× quelle righe. La fattura delle sei chiamate usa la cifra OpenRouter. Se paghi xAI senza gateway, vale ancora la sua scheda, finché non la cambiano.
Perché Grok manca dal grafico benchmark di Anthropic?
Il grafico Anthropic del 22 settembre non ha una colonna Grok: confronta Opus 5.5 con Fable 5.1, Opus 5, GPT-6 Astra e GPT-5.6 Sol. Il grafico xAI confronta Grok 4.7 con Grok 4.6, Sol e Fable. Opus 5.5 non è una colonna. La sovrapposizione è GDPval, perché entrambe le pagine stampano Fable a 1.735 e Astra a 1.542.
Il meter da sei chiamate dice che Opus 5.5 è più intelligente?
No. Tutti e tre hanno passato entrambi i task. Il meter è una fattura e un conteggio di token. GDPval è il punteggio dei laboratori, e mette Opus 5.5 primo tra questi tre, a 1.846 contro 1.695 e 1.542. Una funzione di merge passata non conferma 1.846, e 1.846 non predice la fattura da $0.005292.
Quale modello ha la finestra di contesto più corta?
Grok 4.7, a 500.000 token sul listino OpenRouter. Opus 5.5 è a 1.000.000. Astra è a 1.050.000. Grok riprezza anche a 200.000 token di prompt, e la finestra a prezzo basso resta sotto i 500.000. La tariffa più alta di Astra parte a 272.000 e vale per i token oltre quella linea, più un moltiplicatore 1,5× sull'output.