Claude Sonnet 5.5: zelfde $2/$10, maar de 30% besparing zie je alleen bij lange taken
Anthropic bracht Claude Sonnet 5.5 op 28 september 2026 uit tegen precies de prijs van Sonnet 5: $2 per miljoen inputtokens, $10 per miljoen outputtokens. Een dag later stuurden we 19 beoordeelde calls via OpenRouter erdoorheen. Bij een lang HTML-bestand daalde de rekening met 11,1%. Bij een piepkleine factuursom steeg hij met 12,8%.
Zelfde prijs. Andere rekening.
Wat veranderde er toen Claude Sonnet 5.5 op 28 september uitkwam?
Wissel het model-id naar claude-sonnet-5-5 en je tarief per token blijft $2 input en $10 output.
Op Anthropics prijspagina staan Sonnet 5.5 en Sonnet 5 op identieke regels, inclusief cache en batch. Elk kostenverschil tussen de twee is dus een verschil in aantal tokens.
| Onderdeel | Sonnet 5.5 bij de lancering |
|---|---|
| API-model-id | claude-sonnet-5-5 |
| Input / output, per 1M tokens | $2 / $10 |
| Cache read / cache write | $0.20 / $2.50 (5 min), $4 (1 uur) |
| Batch input / output | $1 / $5 |
| Context / max. output | 1M / 128K tokens |
| Standaard-effort | Medium in Claude Code en de apps, High op de API |
| Beschikbaarheid | Zero data retention; AWS, Google Cloud, Microsoft Azure |
| GitHub Copilot | Pro, Pro+, Max, Business, Enterprise, tegen lijstprijs |
Bronnen: Anthropics modelpagina van Sonnet 5.5, de lanceerpost en de changelog van GitHub. Achtergrond: wat Sonnet 5 veranderde en tokenprijzen per aanbieder.
Hoe dicht komt Sonnet 5.5 bij Opus 5.5 op Anthropics tabel?
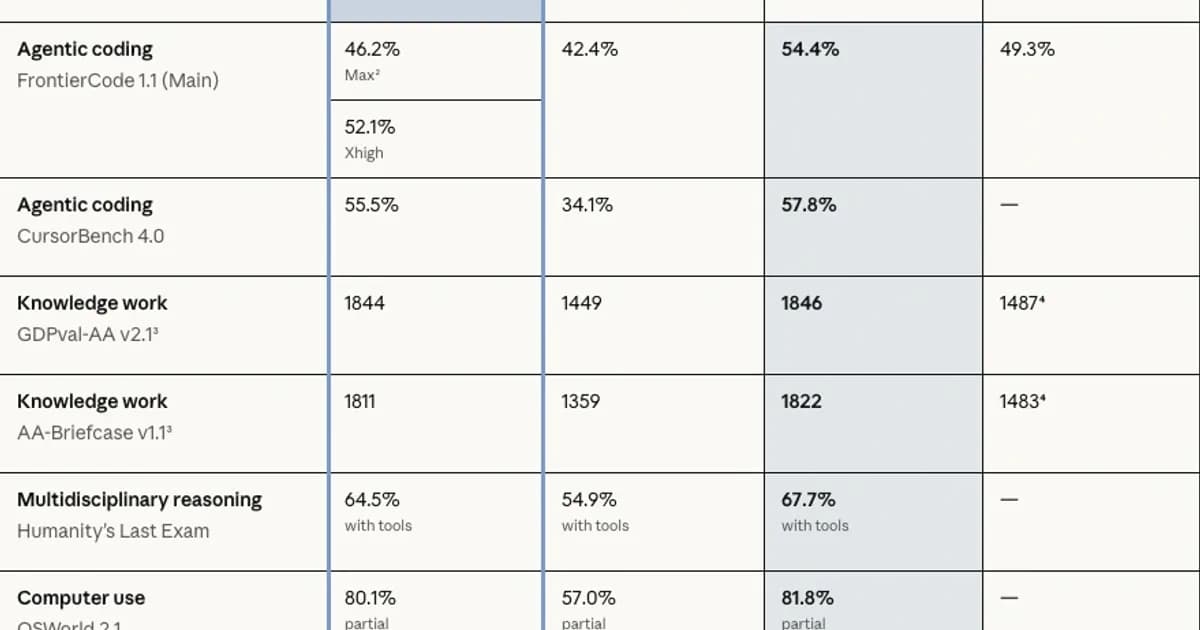
Sonnet 5.5 blijft op vier van de zes procentrijen minder dan drie punten achter op Opus 5.5, en zijn ene winst valt binnen de foutmarge.
Cellen overgetypt uit de heroafbeelding:
| Benchmark | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70,6% | 10,3% | 66,4%¹ | n.v.t. |
| FrontierCode 1.1 Main | 46,2% (Max)², 52,1% (Xhigh) | 42,4% | 54,4% | 49,3% |
| CursorBench 4.0 | 55,5% | 34,1% | 57,8% | n.v.t. |
| GDPval-AA v2.1³ | 1844 | 1449 | 1846 | 1487⁴ |
| AA-Briefcase v1.1³ | 1811 | 1359 | 1822 | 1483⁴ |
| HLE (met tools) | 64,5% | 54,9% | 67,7% | n.v.t. |
| OSWorld 2.1 (gedeeltelijk) | 80,1% | 57,0% | 81,8% | n.v.t. |
| Chartography (zonder tools) | 61,6% | 15,6% | 64,4% | 53,6%⁴ |
¹ Opus op Xhigh-effort. ² Max scoorde lager dan Xhigh: het draaide meer code-review-subagents, en Cognition zag in twee gevallen time-outs of edits buiten de opdracht. ³ Uitgevoerd door Artificial Analysis op een pre-release-deployment met een bug in structured output, inmiddels opgelost. ⁴ Een afbeeldingsbug bij GPT-6 Sol is mogelijk niet verwerkt. Anthropics grafieken voor Terminal-Bench en CursorBench tonen GPT-5.6 Sol.
FrontierCode (Xhigh) en CursorBench blijven 2,3 punten achter, OSWorld 1,7, Chartography 2,8. HLE is de uitzondering met 3,2. De Elo-rijen liggen 2 en 11 uit elkaar.
Die Terminal-Bench-rij voedt de r/ClaudeCode-thread "Sonnet 5.5 beats Opus 5.5 at coding and it's half the price??". De system card geeft standaardfouten van ±2,5 en ±2,6 punten, dus het verschil van 4,2 punten is ongeveer 1,2 gecombineerde standaardfouten, en Sonnet draaide op max terwijl Opus op xhigh draaide. Artificial Analysis mat Sonnet 5.5 op dezelfde test op 64%. De grootste voorsprong van Opus staat niet op de lanceerpagina: SWE-Bench Pro, 81,3 tegen 89,9.
GPT-6 Sol is gewoon de kolom die Anthropic afdrukte. Voor de vergelijking van GPT-6 Astra met Opus 5.5 zie je onze test met drie modellen.
Houdt Anthropics 30% besparing stand over 19 API-calls?
Alleen bij de lange taak: 11,1% goedkoper op een HTML-taak met gemiddeld 2.564 outputtokens, 10-13% duurder op twee piepkleine taken.
Op 29 september om 14:25 UTC stuurden we 19 beoordeelde calls via OpenRouter naar Sonnet 5.5 en Sonnet 5: 3 taken, 3 pogingen, 2 modellen, plus één extra call op hoge effort. Totale rekening: $0.183434. Alle 18 gematchte calls slaagden.
# sonnet55_bench.py, 29 Sep 2026, POST https://openrouter.ai/api/v1/chat/completions
body = {
    "model": model,        # anthropic/claude-sonnet-5.5 or anthropic/claude-sonnet-5
    "messages": messages,
    "max_tokens": max_tokens,         # 12000 on the HTML task
    "reasoning": {"effort": effort},  # low: invoice, merge_intervals; medium: HTML
}
Geen enkel LLM beoordeelde iets. De factuur (800k cache-read-, 200k input- en 50k outputtokens) moest exact 1.06 opleveren, merge_intervals draaide 6 uitgevoerde asserts, en de HTML moest een doctype, canvas en requestAnimationFrame bevatten en geen extern script. Kosten zijn usage.cost, opgeteld over 3 pogingen.
| Taak (effort) | Sonnet 5.5 | Sonnet 5 | Verschil | Gem. outputtokens | Gem. latency |
|---|---|---|---|---|---|
| Factuur (low) | $0.002754 | $0.002442 | +12,8% | 71 / 61 | 2,63 s / 4,49 s |
| merge_intervals (low) | $0.006054 | $0.005502 | +10,0% | 172 / 154 | 3,06 s / 3,68 s |
| HTML met 150 vogels (medium) | $0.077508 | $0.087156 | -11,1% | 2.564 / 2.886 | 15,54 s / 21,61 s |
| Gematcht totaal | $0.086316 | $0.0951 | -9,2% | n.v.t. | n.v.t. |
Anthropic belooft "up to 30% less per task than its predecessor". Matthias Bastian van The Decoder voegde het juiste voorbehoud toe: "Independent testing still needs to confirm these claims."
In onze meter van 19 calls op low en medium effort, met één lange taak, was de besparing -11,1% op de HTML en sloeg ze om naar +12,8% en +10,0% op de piepkleine taken. Bij dezelfde lijstprijs is elke besparing een aantal tokens, en op onze twee kleinste taken schreef Sonnet 5.5 méér tokens, niet minder.
De snelheid hield beter stand. De HTML-latency daalde met 28,1% en de doorvoer steeg van 133,5 naar 165,0 tokens per seconde (+23,6%): de goede kant op, iets onder de 30%. Sonnet 5 logde ook 54-63 reasoning-tokens per factuurcall; Sonnet 5.5 logde er 0 bij alle 10 calls.
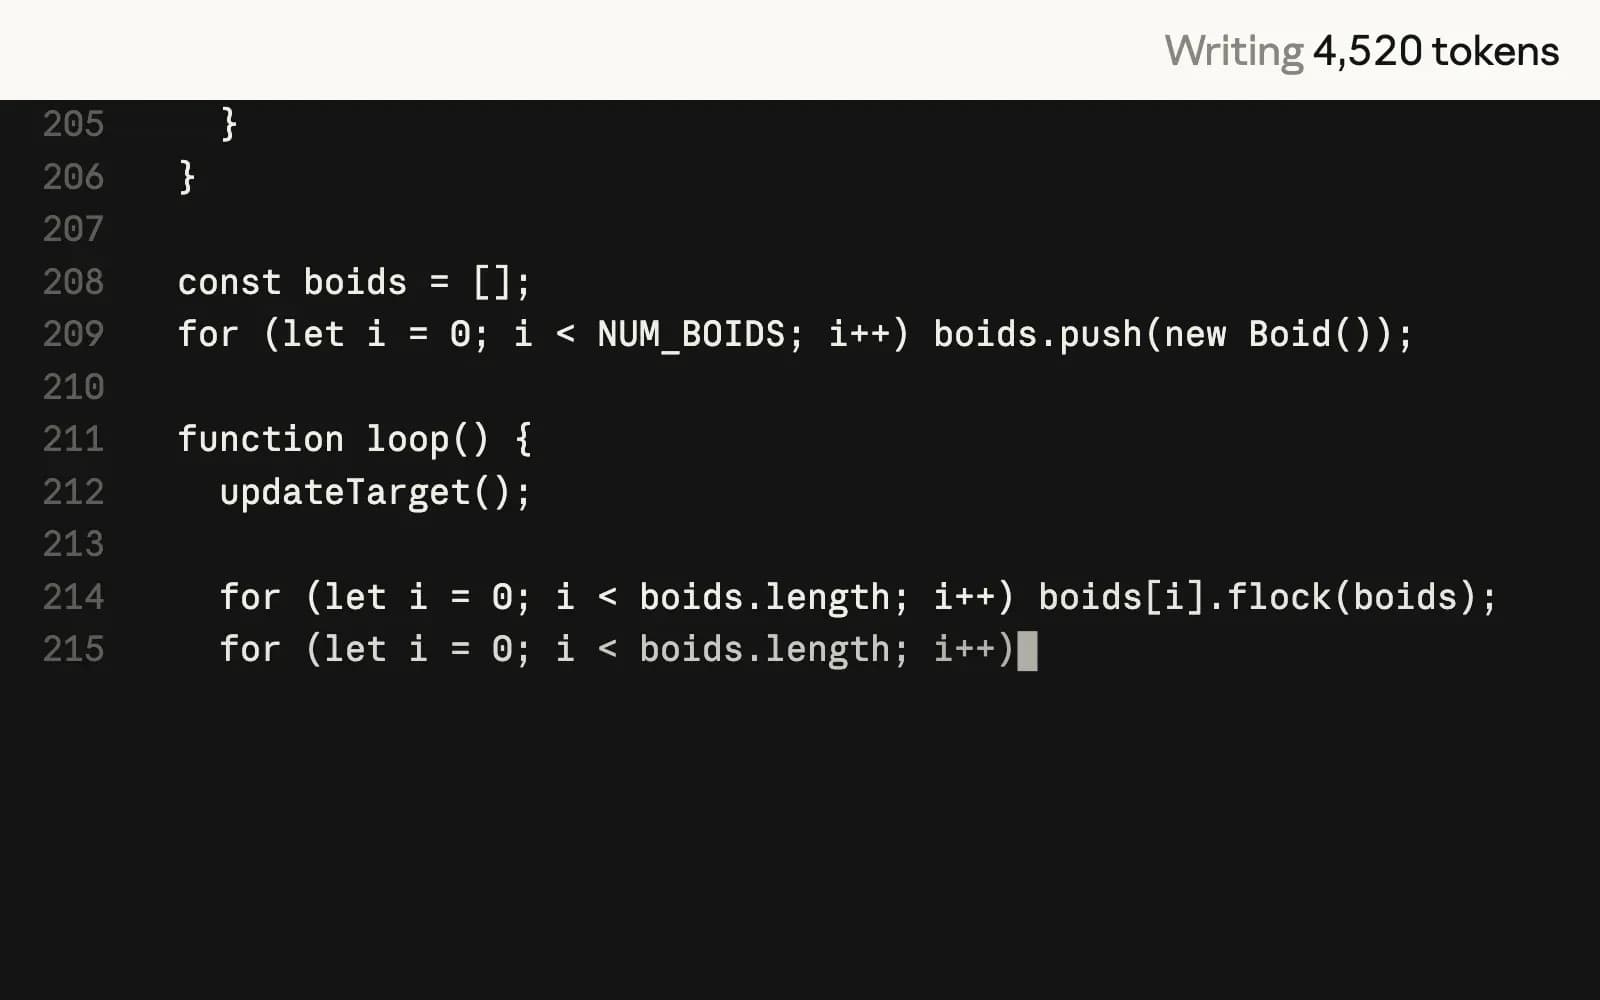
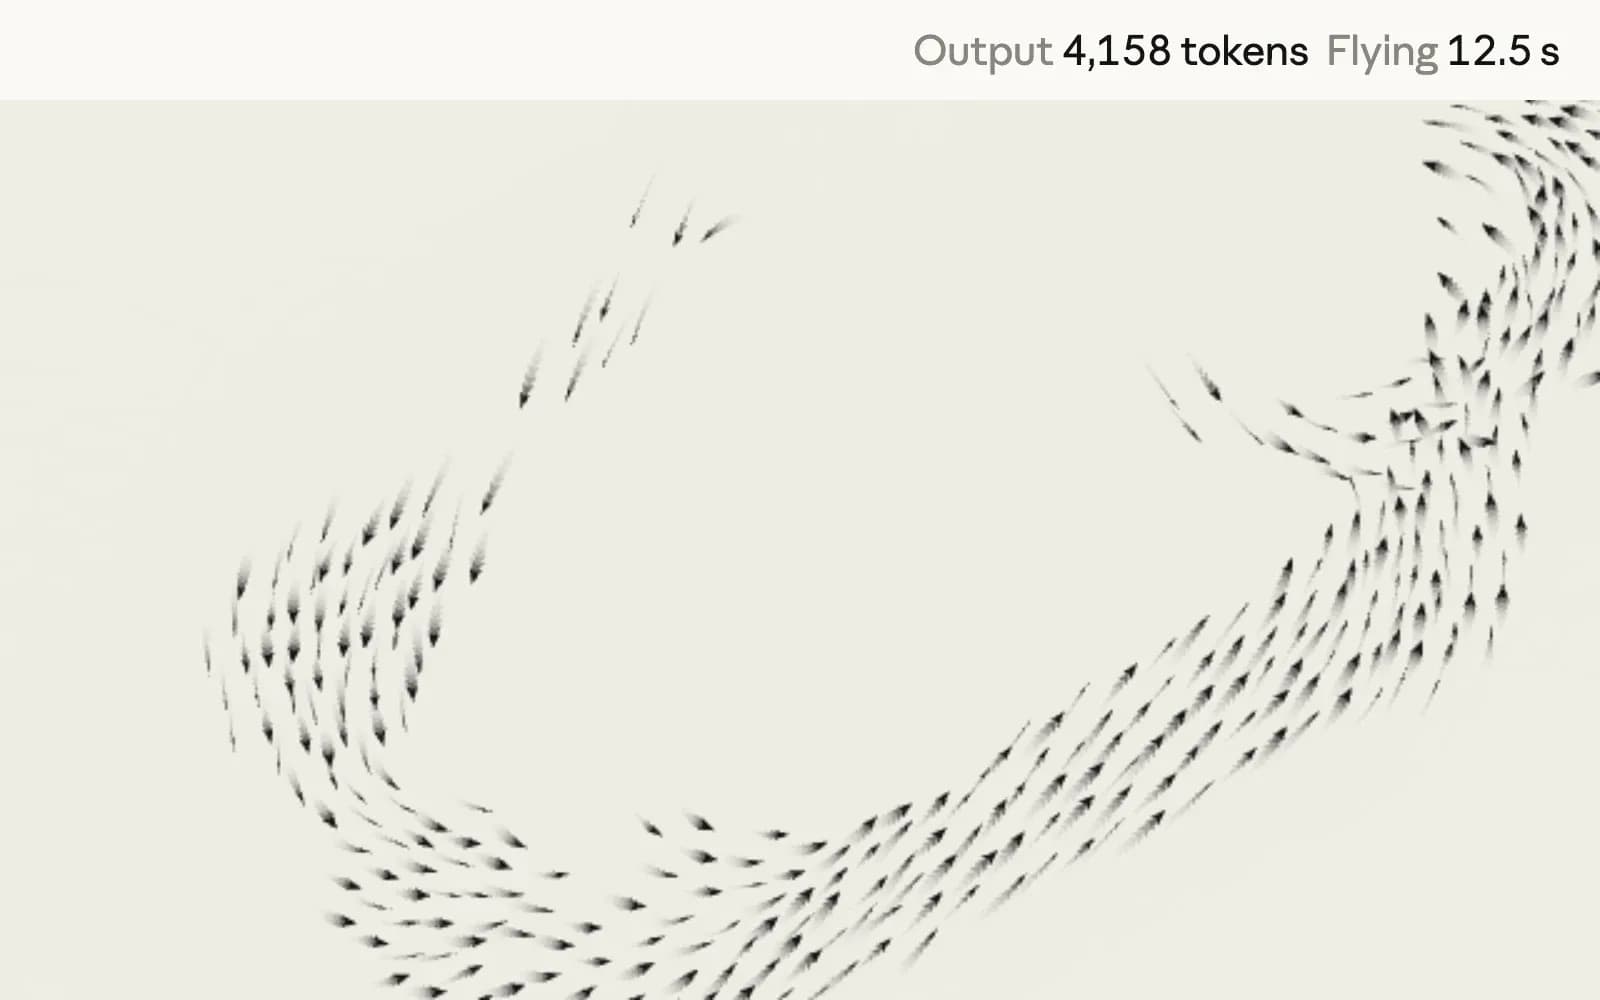
Die HTML-taak is een versie met 150 vogels van Anthropics demoprompt met 400 spreeuwen op de lanceerpagina. De beelden hieronder zijn Anthropics opname, niet onze run.
Wat Anthropics lanceringstesters meldden
"Without changing any of our prompts, Claude Sonnet 5.5 did better than Sonnet 5 on almost all of our offline Slackbot evals, in fewer steps and with about 14% fewer output tokens." Curtis Allen, Principal Engineer, Slack
"The new model managed tens of thousands of lines of code for gameplay system architecture, kept responses snappy, handled multi-hour tasks, and delivered with less prescriptive prompting." Daniel Vogel, Chief Operating Officer, Epic Games
Beide zijn door de leverancier verzameld en beide beschrijven lang, meerstaps werk. Onze piepkleine taken gingen de andere kant op.
Niet gemeten: agentic werk, de benchmarks hierboven, de cyber-fallback. Drie pogingen is een steekproef; wil je zelf meten, lees dan usage bij elke call uit.
Waarom verschuift de effort-stand de rekening meer dan het model?
Artificial Analysis mat $0.59 per taak op medium en $7.60 op max: een sprong van 13x voor 15 indexpunten.
Op max telde het "~193k Output Tokens per Intelligence Index Task. This is the highest token use we have measured".
| Effort | AA-kosten per taak | AA Intelligence Index | AA-rang, 29 sep |
|---|---|---|---|
| Low | $0.41 | 36 | 63 van 216 |
| Medium | $0.59 | 41 | 44 van 216 |
| High | $1.08 | 47 | 23 van 216 |
| Max | $7.60 | 56 | 3 van 216 |
De rijen komen van AA's modelpagina's per effort, opgehaald op 29 september. AA's lanceerartikel zette Sonnet 5.5 op de tweede plaats van de index; de modelpagina toonde die dag 56, rang 3 van 216. Max kostte ook "~50% higher than Sonnet 5's Cost per Task".
Onze eigen call op hoge effort negeerde de instelling: merge_intervals op effort=high kostte $0.002018 voor 172 outputtokens, identiek aan low. Effort bijt pas bij werk dat groot genoeg is om over na te denken, en daar begint je LLM-API-uitgaven verlagen.
Wat geeft een 400 nadat je het model-id hebt gewisseld?
Elk verzoek met uitgeschakelde thinking faalt; zet het op between_tools en houd effort op high of lager.
Anthropics migratiegids noemt de fout letterlijk:
# Before (Sonnet 5 habit): 400 invalid_request_error on claude-sonnet-5-5
thinking = {"type": "disabled"}
# '"thinking.type.disabled" is not supported for this model. Use
#  "thinking.type.between_tools" for the lowest thinking setting, ...'

# After: accepted at low / medium / high effort, 400 at xhigh / max
thinking = {"type": "between_tools"}
output_config = {"effort": "medium"} # fixed for the conversation under between_toolstool_choicemetanyoftoolgeeft 400. Gebruikautoplusstrict: true(maximaal 20 strict tools), of alleenautoop Amazon Bedrock.- Thinking-blokken van Opus 5, Opus 5.5, Fable of Mythos worden stilzwijgend weggelaten; accounts van 31 aug 2026 of later krijgen een 400 als je een blok terugspeelt nadat je de geschiedenis hebt aangepast. De werking komt overeen met de thinking-block-binding van Fable 5.1.
- Computer use vereist
computer_toolset_20260801op de Claude API en Google Cloud. - Weigeringen noemen een
stop_details-categorie, waarondercyber,frontier_llm("could assist the development of competing AI models") enreasoning_extraction. - Server-side fallback (
fallbacks: "default", bèta, alleen Claude API) probeertcyber- enfrontier_llm-weigeringen opnieuw op Sonnet 5; volgens de system card viel 1,2% van de Terminal-Bench-verzoeken terug. - De minimale cachebare prompt zakt naar 512 tokens van 1.024 (minimumgroottes bij prompt caching), en
/claude-api migratein Claude Code past deze wijzigingen toe.
Securityteams lopen als eerste tegen punt 4 aan. Een HN-reageerder, johnmlussier, zei dat ze ondanks deelname aan het Cyber Verification Program "can't use Opus 5.5 or Sonnet 5.5 for any authorized bounty work". Anthropic zegt dat het uitgebreide programma "Soon" komt.
Dezelfde checklist zegt "Re-run your effort sweep, and re-baseline cost". Doe dat voordat je de 30% gelooft.
Sonnet 5.5 of Opus 5.5: welke krijgt de standaardplek?
Kies Sonnet 5.5 als standaard voor afgebakende codeertaken en grote volumes; houd Opus 5.5 voor open oordeelsvorming en al het werk op max-effort.
Sonnet staat op de helft van Opus 5.5's $4/$20, maar Artificial Analysis mat Sonnet op max op $7.60 per taak tegen $5.98 voor Opus 5.5, zo'n 27% meer.
| Signaal | Sonnet 5.5 | Opus 5.5 | Voordeel |
|---|---|---|---|
| Input / output per 1M | $2 / $10 | $4 / $20 | Sonnet, half zo duur |
| Cache read / 5-min write | $0.20 / $2.50 | $0.20 / $5 | Gelijk bij reads |
| Cache-zware mix (hieronder) | $1.06 | $1.96 | Sonnet, 1,85x en geen 2x |
| AA-kosten per taak, max effort | $7.60 | $5.98 | Opus, 27% goedkoper |
| SWE-Bench Pro | 81,3% | 89,9% | Opus met 8,6 punten |
Mix: 800k cache-read + 200k input + 50k output tokens
Sonnet 5.5: 0.8 x $0.20 + 0.2 x $2 + 0.05 x $10 = $0.16 + $0.40 + $0.50 = $1.06
Opus 5.5:   0.8 x $0.20 + 0.2 x $4 + 0.05 x $20 = $0.16 + $0.80 + $1.00 = $1.96
Ratio: 1.96 / 1.06 = 1.85x
Aleksei Aleinikovs "approximately 1.65×" hangt af van een mix die hij niet noemt. Vul de jouwe in: hoe meer cache je gebruikt, hoe kleiner Sonnets voorsprong.
Anthropic zelf zegt "Opus 5.5 remains clearly stronger at complex, open-ended work requiring sustained judgment." Een HN-reageerder, datadrivenangel, zette er een schepje bovenop: "Opus 5.5 on Low seems smarter, cheaper, and faster than sonnet on medium". Door ons niet getest. Prijzen en limieten van Opus staan in onze uitleg over Opus 5.5.
Onze standaard sinds 29 september: claude-sonnet-5-5 op medium effort. Taken op max-effort gaan naar Opus 5.5, want op max is Sonnet niet langer het goedkope model.
Veelgestelde vragen
Wanneer is Claude Sonnet 5.5 uitgekomen?
Anthropic bracht Claude Sonnet 5.5 op 28 september 2026 uit als claude-sonnet-5-5, dezelfde dag op Amazon Web Services, Google Cloud, Microsoft Azure en GitHub Copilot. Volgens Anthropics documentatie wordt het niet vóór 28 september 2027 uitgefaseerd.
Is Claude Sonnet 5.5 goedkoper dan Sonnet 5?
Niet per token: beide staan op $2 input en $10 output. In onze meter kostte een lange HTML-taak 11,1% minder op Sonnet 5.5 en een piepkleine factuurtaak 12,8% meer; op max-effort mat Artificial Analysis ongeveer 50% meer per taak.
Kan ik Sonnet 5.5 gebruiken in Claude Code en GitHub Copilot?
Ja. Claude Code zet het standaard op Medium-effort; de API staat standaard op High. In GitHub Copilot, van Pro tot Enterprise, wordt het "billed at provider list pricing under usage-based billing". Wil je het vastzetten, lees dan hoe je van model wisselt in Claude Code.
Wat is het contextvenster en de knowledge cutoff van Sonnet 5.5?
Het verwerkt 1M tokens context en geeft tot 128K outputtokens terug, met een betrouwbare knowledge cutoff van juni 2026 volgens de system card.
Komt er een Haiku 5.5?
Op 29 september 2026 nog niet. Anthropic zei op 28 september dat Claude Haiku 5.5 "will join the Claude 5.5 family in the coming weeks."