GPT-6 Astra vs Claude Opus 5.5 vs Grok 4.7: rekening, GDPval en een meter van zes calls
GPT-6 Astra, Claude Opus 5.5 en Grok 4.7 waren om 22:34 UTC op 22 september 2026 allemaal aanroepbaar op OpenRouter. Zes beoordeelde calls, twee taken, van elk één proef: allemaal geslaagd. De gatewayrekening was $0.01626.
De grafieken van de lancering sluiten niet op elkaar aan.
Op het scorebord van Anthropic staat Astra, Grok niet. Op het scorebord van xAI staan Fable 5.1 en Sol, plus Astra op één Elo-grafiek. Deze pagina blijft bij de gedeelde ankers en stopt waar de meetlatten uit elkaar lopen.
De knip van Opus 5.5 tegen Opus 5 blijft in het stuk over Opus 5.5. De upgrade van 4.7 tegen 4.6 blijft in het stuk over Grok 4.7. Astra tegen Fable blijft in het stuk over GPT-6 Astra.
Drie kaarten en de promptlengte die ze herprijst
De token van Astra kost 2,5× die van Opus 5.5 op input en output, en 5× bij het lezen uit cache. De xAI-kaart van Grok kost de helft van de input en 0,3× de output, tot de prompt over 200.000 tokens gaat.
Opus 5.5 is de 1,0-lijn: $4, $20 en $0.20 per miljoen tokens.
De modelkaart van Astra is $10, $50 en $1.00. De kaart van Grok van 21 september is $2, $6 en $0.50 onder 200.000 prompttokens.
| Regel, per 1 miljoen tokens, onder de knik | Opus 5.5 | GPT-6 Astra | Grok 4.7, xAI-kaart |
|---|---|---|---|
| Input | $4 | $10 | $2 |
| Output | $20 | $50 | $6 |
| Cache-read | $0.20 | $1.00 | $0.50 |
| Context | 1.000.000 | 1.050.000 | 500.000 |
| Knik | geen op deze kaart | 272.000 prompttokens: input en cache 2×, output 1,5× | 200.000 prompttokens: de hele request gaat naar $4 / $12 / $1 |
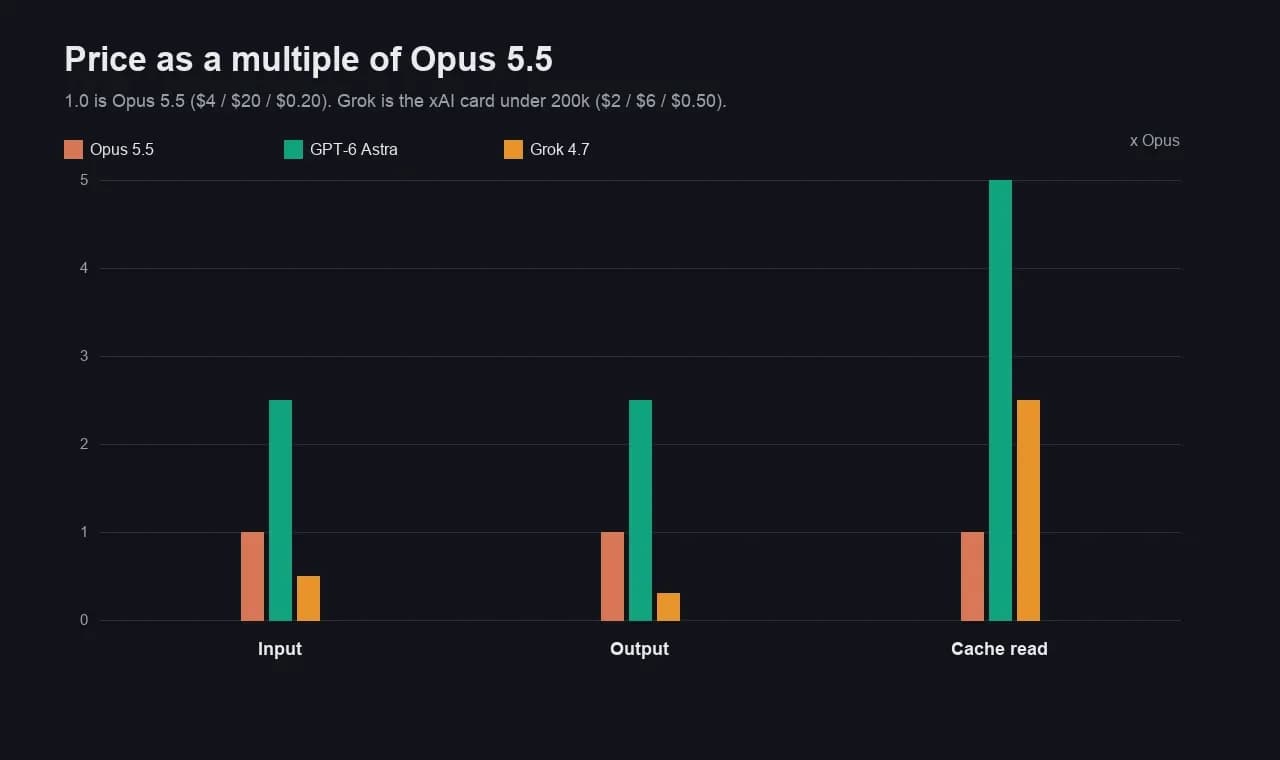
De prijs op OpenRouter om 22:34 UTC kwam overeen met Opus en Astra. Met Grok niet.
De listing van Grok was $1.60, $4.80 en $0.40, daarna $3.20, $9.60 en $0.80 bij 200.000 prompttokens. Dat is 0,8× de xAI-kaart. Onze usage.cost-cijfers gebruiken die catalogus. Het stuk over Grok 4.7 prijst de eigen kaart van xAI nog op $2 en $6.
Een herlezing uit cache van 500.000 tokens, alleen de rekensom: Opus $0.10, Astra $0.25 en de cache-regel van Grok bij xAI $0.25. Astra is de dure op cache, niet op output. Op output is de $6 van Grok tegen de $50 van Astra een gat van 8,3×, en tegen de $20 van Opus een gat van 3,3×.
Zes beoordeelde calls en de rekening die elk model echt stuurde
Alle zes slaagden. De twee calls van Grok kostten $0.0038784, Opus 5.5 kostte $0.005292 en Astra kostte $0.00709.
Het factuurantwoord moest 1.96 zijn. merge_intervals moest de verborgen tests halen, ook intervallen die elkaar raken.
Gecachte tokens stonden op 0 bij Opus en Astra. Grok meldde 1.152 gecachte tokens op beide calls, binnen prompttellingen van 1.310 en 1.336. 295 van de 298 factuurtokens waren reasoning.
# 22 Sep 2026, 22:34 UTC, OpenRouter, one trial, max_tokens 1800
MODELS = [
    "anthropic/claude-opus-5.5",
    "openai/gpt-6-astra",
    "x-ai/grok-4.7",
]| Taak | Opus 5.5 | GPT-6 Astra | Grok 4.7 |
|---|---|---|---|
| Factuur, moet 1.96 zijn | geslaagd, $0.001336, 46 output, 4,277s | geslaagd, $0.00263, 38 output, 2,116s | geslaagd, $0.002144, 298 output, 5,292s |
| merge_intervals | geslaagd, $0.003956, 168 output, 3,307s | geslaagd, $0.00446, 69 output, 2,588s | geslaagd, $0.0017344, 204 output, 4,217s |
| Totaal twee taken | $0.005292 | $0.00709 | $0.0038784 |
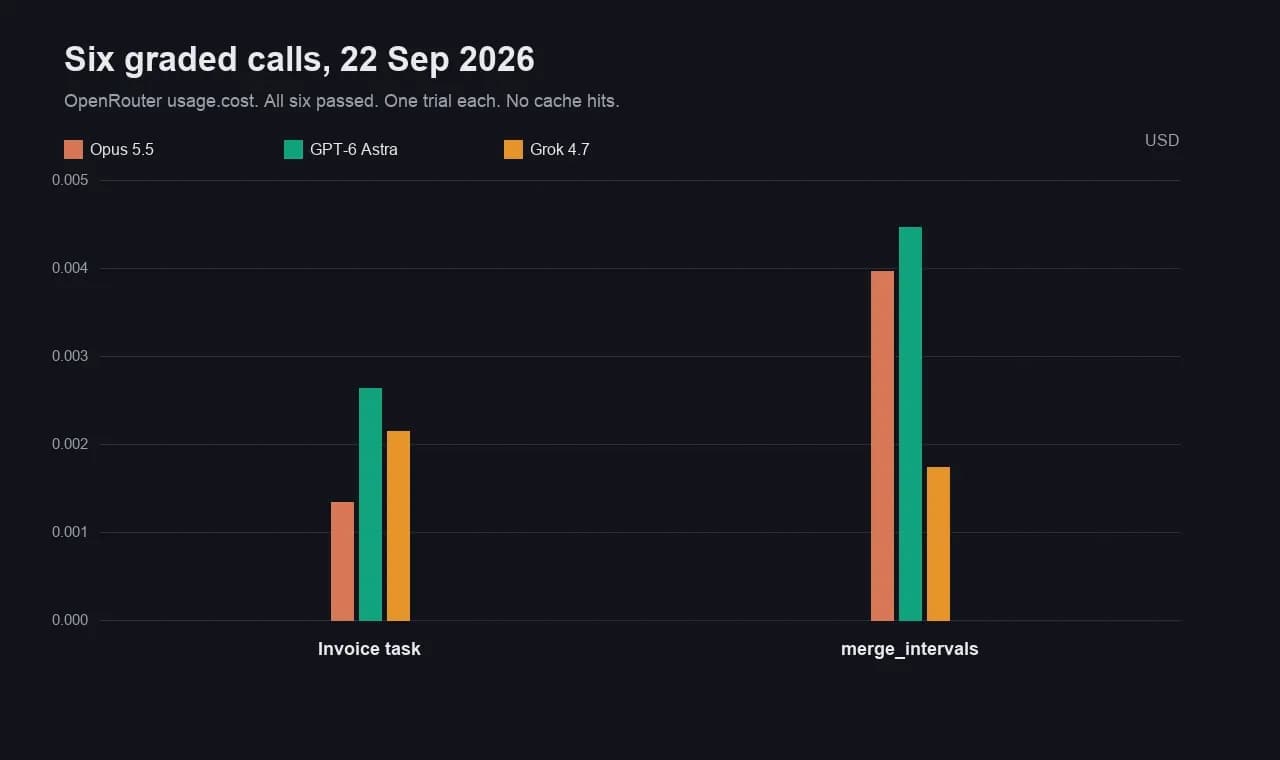
Astra schreef de minste tokens en stuurde de grootste rekening.
38 en 69 completion-tokens, tegen 46 en 168 bij Opus. De kaart van $10/$50 at de besparing op. Die twee usage.cost-cijfers kloppen exact met $10 en $50. Opus klopt met $4 en $20.
Grok verloor de factuur en won de functie. 204 tokens aan $4.80 kwamen uit op $0.0017344.
Astra was het snelst op beide taken, 2,116s en 2,588s. Eén proef is geen snelheidsranglijst.
Het Astrastuk van 4 september zei dat openai/gpt-6-astra HTTP 400 teruggaf. Dat klopte om 14:40 UTC die dag. Voor deze run klopt het niet. De id werd geaccepteerd, de call gaf 1.96 terug en de tests slaagden.
GDPval is de rij die beide labs echt delen
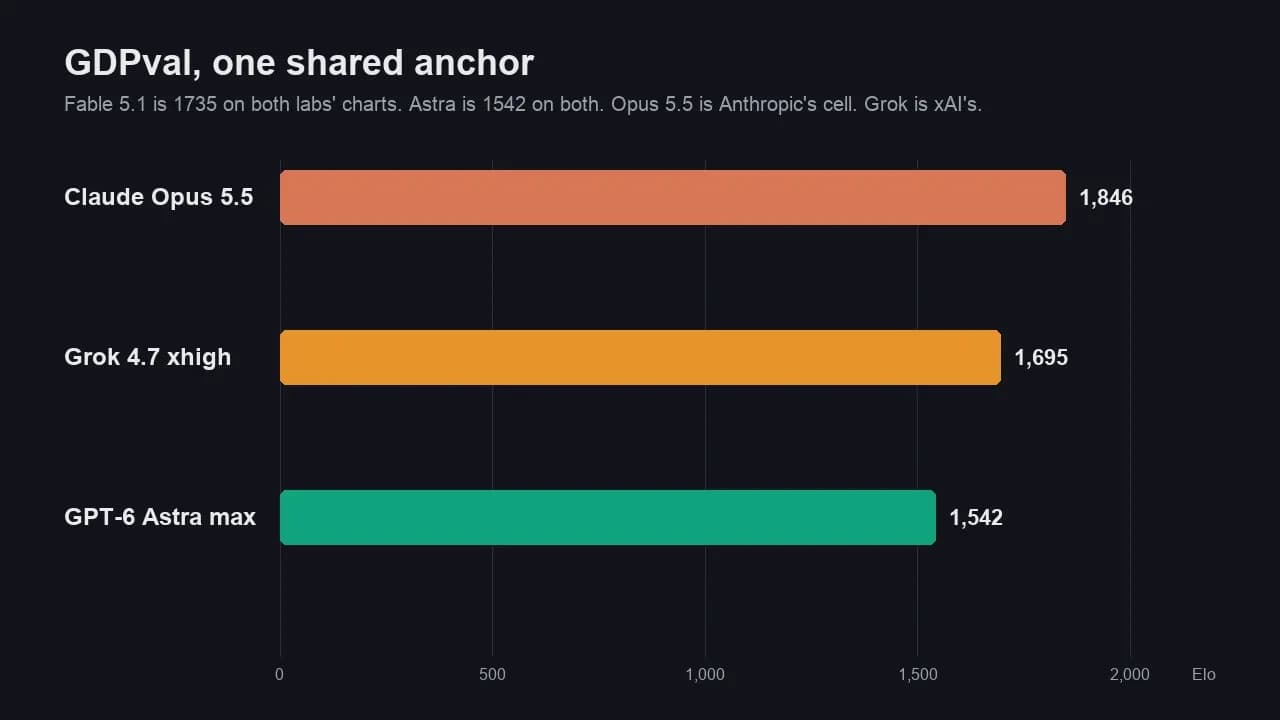
Opus 5.5 leidt die gedeelde rij met 1.846. Grok 4.7 xhigh is 1.695. Astra max is 1.542.
Fable 5.1 op 1.735 is het anker, geen vierde keuze.
Anthropic zet 1.735, Astra op 1.542 en Opus 5.5 op 1.846. xAI zet dezelfde 1.735 en 1.542, en Grok 4.7 xhigh op 1.695. Twee overgenomen getallen zijn de reden dat de balken één as delen.
| Cel | Score | Wie het publiceerde |
|---|---|---|
| Claude Opus 5.5 | 1.846 | Anthropic, 22 sep 2026 (GDPval-AA v2.1) |
| Grok 4.7 xhigh | 1.695 | Lanceergrafiek van xAI, 21 sep 2026 (GDPval) |
| GPT-6 Astra max | 1.542 | Beide grafieken |
| Fable 5.1 max, alleen anker | 1.735 | Beide grafieken |
Opus zit 151 Elo boven Grok en 304 boven Astra. Grok zit 153 boven Astra en 40 achter het Fable-anker. Niets daarvan is onze meting. Onze zes calls waren een factuur op twee decimalen en een merge-functie. Ze geven geen score voor kantoorwerk.
Artificial Analysis zette Opus 5.5 op 58 op de Intelligence Index bij max effort, en schreef dat de kosten per taak gelijk bleven met Opus 5 doordat de outputtokens ongeveer 1,6× stegen. De notitie over Grok 4.7 zette dat model op 46 op dezelfde index. Andere meetlat, dezelfde richting. Opus ligt voor op Grok, en dat is geen reden om de tokenrekening te negeren.
Terminal-Bench en CursorBench zijn niet één meetlat
Middel de 66,4% van Anthropic niet met de 38,0% van xAI. Het is niet dezelfde Terminal-Bench-cel.
- Anthropic, Opus 5.5 op xhigh, Astra op high zoals OpenAI het rapporteerde: Terminal-Bench 4.0 is 66,4% voor Opus 5.5 en 57,9% voor Astra. Fable 5.1 staat op 55,8% op die pagina. CursorBench 4.0 is 57,8% voor Opus 5.5 en 51,8% voor Fable. De CursorBench-cel van Astra is leeg.
- Het scorebord van xAI: Terminal-Bench 4.0 is 38,0% voor Grok 4.7 xhigh en 57,9% voor Fable 5.1 Max. CursorBench is 46,3% voor Grok en 51,8% voor Fable. Astra staat niet op dat bord. De CursorBench-cel van Fable, 51,8%, komt overeen met Anthropic. De Terminal-Bench-cel van Fable niet: daar 57,9%, op de pagina van Anthropic 55,8%.
- Artificial Analysis, een derde opzet: Opus 5.5 op 59,6% op Terminal-Bench 4.0, gelijk met Astra op xhigh. De stap van Grok op de agentrun van dat lab liep van 18% naar 33%, niet 38,0%.
CursorBench kun je naast zichzelf leggen, want 51,8% duikt twee keer op. Opus 5.5 op 57,8% leidt Fable met 6,0 punten op het cijfer met hogere effort van Anthropic. Grok op 46,3% loopt 5,5 punten achter op die Fable-cel. Astra heeft geen cel. Zet het lab naast het percentage, anders is de ranglijst een collage.
EEBench, Harvey en HealthBench zijn rijen van xAI. Opus 5.5 en Astra ontbreken. Die blijven in het Grok-stuk. AutomationBench en Terminal-Bench-Science zijn rijen van Anthropic en OpenAI. Grok ontbreekt. Die blijven in de stukken over Opus en Astra.
Wat elk bestaand stuk nog zelf houdt
Deze pagina vervangt de drie gelinkte stukken niet. Hier staan de drie modellen alleen tegen elkaar.
- Het stuk over Opus 5.5 houdt de knip van $4/$20, de meter van $0.02719, de limiet van vijf uur en de cyber-fallback naar Opus 4.8. De cover blijft de grafiek van Anthropic. De Astra-kolommen lees je hier.
- Het stuk over Grok 4.7 houdt 4.7 tegen 4.6: twaalf calls, 12/12 en de knik van $2/$6. De balk van 1.695 is van hen. Opus 5.5 niet.
- Het stuk over Astra houdt Astra tegen Fable 5.1, inclusief de HTTP 400 van 4 september en de splitsing 99,9% versus 62,7%. Of je hem kon aanroepen, veranderde op 22 september. De keuze voor Fable niet.
Welk van de drie je vastzet
Zet Grok 4.7 vast als de outputrekening het product is en de klus in 500.000 tokens past. Zet Opus 5.5 vast als de gedeelde GDPval-rij het product is. Zet Astra vast als je al een computer-use- of wiskundeklus hebt gemeten die de andere twee stukken documenteren, en je $10/$50 kunt betalen.
- Korte calls zonder cache, zoals deze zes: Grok was in totaal het goedkoopst, $0.0038784 tegen $0.005292 en $0.00709. Op de factuur was hij de dure, omdat reasoning tot 295 tokens liep. Als je korte calls op
merge_intervalslijken, is de functierij de rij om over te nemen. Als ze op een getal van één regel lijken, gaf Opus 46 tokens uit en won die rij. - Agents met veel cache, onder 200.000 prompttokens: Opus op $0.20 per miljoen gecachte tokens verslaat beide. Astra op $1.00 is 5× die regel. De cache-regel van Grok bij xAI is $0.50, dus 2,5× Opus.
- Prompts die over 200.000 tokens gaan: bij Grok beïnvloedt die lengte de prijs van de hele request. Een prompt van 250.000 tokens op de xAI-kaart is $4 en $12, niet $2 en $6. De knik van Astra begint later, bij 272.000, en tokens onder die lijn worden niet herprijsd zoals de documentatie van Grok dat beschrijft.
- Kantoorwerk dat je aan GDPval wilt toevertrouwen: Opus 1.846, dan Grok 1.695, dan Astra 1.542, met de 1.735 van Fable tussen Opus en Grok. Die volgorde is de volgorde van de labs. Het is geen score uit de zes calls.
- Terminalwerk: laat het buiten deze ranglijst. Kies het lab van de runner die je echt uitrolt, en gebruik dan het getal van dat lab. 66,4% en 38,0% door elkaar vertellen je niet welke binary je moet aanroepen.
Veelgestelde vragen
Kun je GPT-6 Astra nu op OpenRouter aanroepen?
Ja, per 22:34 UTC op 22 september 2026. De id openai/gpt-6-astra gaf 1.96 terug op de factuur en een merge_intervals die de verborgen tests haalde. Op 4 september gaf dezelfde id HTTP 400 terug. Het eerdere stuk legt die 400 vast. Dit stuk legt de call vast die werkte. Het contextvenster op de listing was 1.050.000 tokens.
Heeft xAI Grok 4.7 verlaagd van $2 en $6?
Nee, niet op de lanceerkaart die deze pagina citeert. De tabel van xAI is nog $2 en $6 onder 200.000 prompttokens, daarna $4 en $12. De catalogus van OpenRouter tijdens deze run was $1.60 en $4.80, daarna $3.20 en $9.60, dus 0,8× die regels. De rekening van zes calls gebruikt het OpenRouter-cijfer. Een rekening die je rechtstreeks aan xAI betaalt, volgt de kaart van xAI tot die wijzigt.
Waarom ontbreekt Grok op de benchmarkgrafiek van Anthropic?
De grafiek van Anthropic van 22 september vergelijkt Opus 5.5 met Fable 5.1, Opus 5, GPT-6 Astra en GPT-5.6 Sol. Grok is geen kolom. De grafiek van xAI vergelijkt Grok 4.7 met Grok 4.6, Sol en Fable. Opus 5.5 is geen kolom. GDPval is de overlap, want beide pagina's zetten Fable op 1.735 en Astra op 1.542.
Zegt de meter van zes calls dat Opus 5.5 slimmer is?
Nee. Alle drie slaagden voor beide taken. De meter is een rekening en een tokentelling. GDPval is de labscore, en die zet Opus 5.5 wel als eerste van deze drie, op 1.846 tegen 1.695 en 1.542. Een geslaagde merge-functie bevestigt 1.846 niet, en 1.846 voorspelt de factuur van $0.005292 niet.
Welk model heeft het kortste contextvenster?
Grok 4.7, met 500.000 tokens op de OpenRouter-listing. Opus 5.5 zit op 1.000.000. Astra zit op 1.050.000. Grok herprijst ook bij 200.000 prompttokens, dus het venster dat nog goedkoop is, is kleiner dan 500.000. Het hogere tarief van Astra begint bij 272.000 en geldt voor de tokens boven die lijn, plus een outputfactor van 1,5×.