Claude Opus 5.5: $4/$20 prijs, de limieten, en wat we meterden
Claude Opus 5.5 ging op 22 september 2026 live, op $4 per miljoen inputtokens en $20 per miljoen outputtokens. Cache reads zijn $0.20. Dat ligt 20% onder Claude Opus 5 op input en output, en 60% eronder op cache reads ($0.50). Platform-id: claude-opus-5-5. Om 18:57 UTC had OpenRouter anthropic/claude-opus-5.5 al in de lijst, dezelfde drie tarieven, context van 1.000.000 tokens.
Negen beoordeelde calls gingen eruit tussen 18:57 en 18:58 UTC. Acht calls vergeleken we met Opus 5 op effort=low. Alle acht slaagden. Opus 5.5 factureerde $0.010564. Opus 5 factureerde $0.01269.
Een negende call, Opus 5.5 op effort=high, slaagde ook en factureerde $0.003936. Het experiment kostte in totaal $0.02719. De cover is de grafiek die Anthropic op de lanceerpagina zette, ongewijzigd opgeslagen.
Claude Opus 5.5 API-prijs tegenover Opus 5
De nieuwe prijslijst scheelt het meest bij cache-zwaar verkeer. Calls zonder cache daalden op onze meter maar zo'n 20%.
De lanceringstabel van Anthropic is de standaardprijslijst. Hij staat hieronder en in de prijsscreenshot. Fable 5.1 blijft op $10/$50. De cache read is $0.25, dus de cacheregel van Opus 5.5 onderbiedt Fable met $0.05 per miljoen, niet met de helft. Het gat van 2,5x zit in input en output: $10/$4 en $50/$20.
| Regel, per 1M tokens | Opus 5.5 | Opus 5 | Fable 5.1 |
|---|---|---|---|
| Input | $4 | $5 | $10 |
| Output | $20 | $25 | $50 |
| Cache read | $0.20 | $0.50 | $0.25 |
| Cache write, 5 min | $5 | $6.25 | $12.50 |
| Cache write, 1 uur | $8 | $10 | $20 |
| OpenRouter-batch input / output | $2 / $10 | $2.50 / $12.50 | $5 / $25 |
| Fast mode input / output | $8 / $40 | niet op deze kaart | niet op deze kaart |
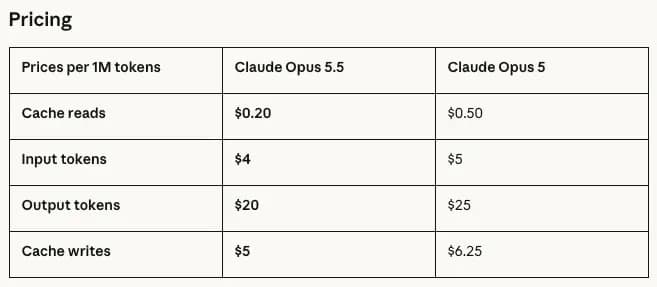
De cache write van 5 minuten ($5 tegen $6.25) staat op de pagina van Anthropic en in de notitie van Artificial Analysis.
De write van 1 uur ($8) en de batchroute ($2/$10, cache read $0.10) komen uit de payload van OpenRouter op /api/v1/models, om 18:57 UTC. De lanceringstabel drukt die rijen niet af.
Fast mode staat op de lanceerpagina: tot 2,5x de snelheid, op $8 en $40. Dat is 2x de standaard Opus 5.5, en het ligt boven de $5/$25 van Opus 5.
Negen beoordeelde calls, en de rekening die ze opleverden
Alle 8 gematchte calls slaagden. Opus 5.5 kostte $0.010564 tegen Opus 5 op $0.01269, een korting van 16,8%.
OpenRouter chat completions. Geen temperature. reasoning.effort stond op low, plus één coding-call op high.
Twee taken, twee trials. De graders waren een exacte match en uitgevoerde tests. Gecachte tokens: 0. Factuurprompts: 104 tokens.
# 22 Sep 2026, 18:57 UTC, OpenRouter
MODELS = ["anthropic/claude-opus-5.5", "anthropic/claude-opus-5"]
# invoice answer must be 1.96
# 800_000 * 0.20/1e6 + 200_000 * 4/1e6 + 50_000 * 20/1e6
# coding: merge_intervals, hidden tests, function only| Set | Opus 5.5 | Opus 5 |
|---|---|---|
| Factuur, 2 trials | 2/2, $0.002652, 45 en 46 output, 3,089s en 5,100s | 2/2, $0.00332, 46 en 46 output, 6,765s en 3,997s |
| merge_intervals, 2 trials | 2/2, $0.007912, 168 en 168 output, 3,597s en 3,239s | 2/2, $0.00937, 161 en 155 output, 3,435s en 3,582s |
| Gematcht totaal | $0.010564, 8/8 | $0.01269, 8/8 |
| effort=high, 1 coding-call | geslaagd, $0.003936, 167 output, 0 reasoning-tokens | niet gedraaid |
Het factuurpaar is het schone geval van 20%: 20,1% goedkoper, bijna hetzelfde aantal completions. Het functiepaar is de misser. Opus 5.5 schreef 336 completion-tokens tegen 316, en de rekening daalde maar 15,6%. De lijstprijs daalde 20%. Het tokenaantal steeg. De nettobesparing kromp. effort=high maakte die functie niet langer: 167 completion-tokens, 0 reasoning-tokens, $0.003936, tests geslaagd. Artificial Analysis zag het andere regime, ongeveer 119.000 outputtokens per Intelligence Index-taak op max tegen ongeveer 73.000 voor Opus 5, terwijl de kost per taak gelijk bleef. Reken daar niet op een korting van 40%. Onze 9 calls kwamen daar niet in.
Latency is gelijkspel op deze steekproef. Gemiddelde coding: 3,42s en 3,51s. Gemiddelde factuur: 4,09s en 5,38s. De bereiken overlappen, 5,100s tegen 3,997s.
Anthropic zegt dat output meer dan 30% sneller is dan Opus 5. Deze 9 calls laten dat niet zien.
Waar de grafiek van Anthropic voorloopt, en waar niet
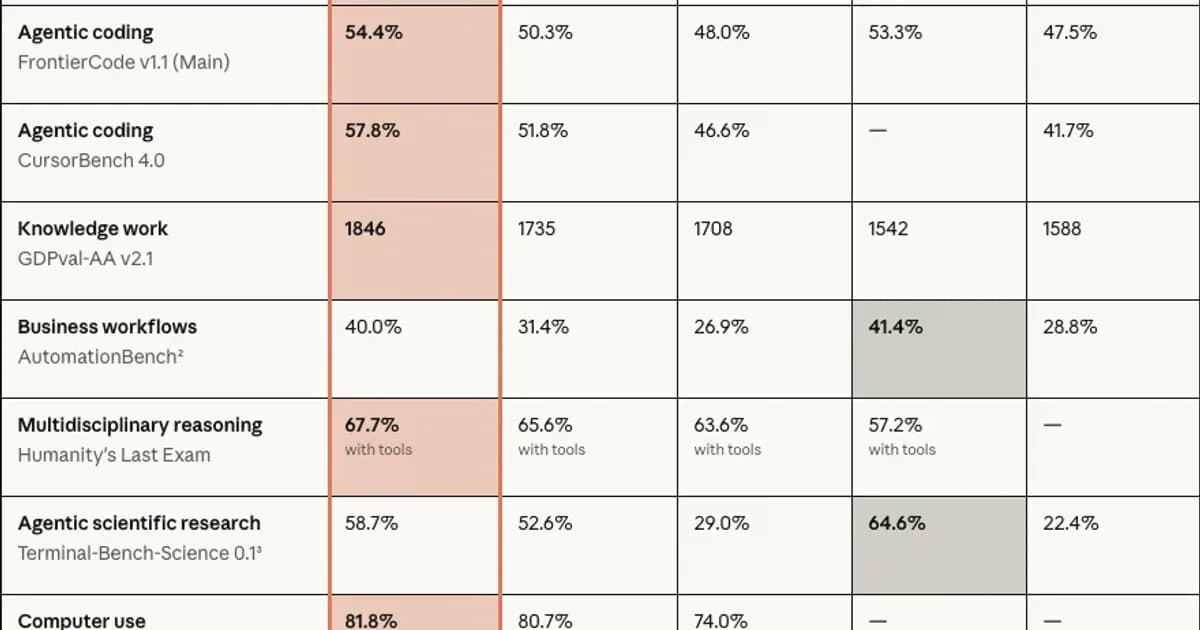
Astra leidt twee genummerde rijen: AutomationBench op 41,4% en Terminal-Bench-Science op 64,6%.
Elke andere genummerde cel op de grafiek van 22 september is een voorsprong voor Opus 5.5. De cover is die grafiek. De cellen hieronder zijn ervan overgenomen.
Anthropic zegt dat deze cijfers van Opus 5.5 adaptive thinking op max effort gebruiken, met één voorbehoud: Terminal-Bench 4.0 is Opus 5.5 op xhigh en GPT-6 Astra op high, het Astra-cijfer zoals OpenAI het rapporteerde.
| Benchmark | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 66,4% | 55,8% | 52,3% | 57,9% | 37,3% |
| FrontierCode v1.1 (Main) | 54,4% | 50,3% | 48,0% | 53,3% | 47,5% |
| CursorBench 4.0 | 57,8% | 51,8% | 46,6% | n.v.t. | 41,7% |
| GDPval-AA v2.1 | 1846 | 1735 | 1708 | 1542 | 1588 |
| AutomationBench | 40,0% | 31,4% | 26,9% | 41,4% | 28,8% |
| Humanity's Last Exam, with tools | 67,7% | 65,6% | 63,6% | 57,2% | n.v.t. |
| Terminal-Bench-Science 0.1 | 58,7% | 52,6% | 29,0% | 64,6% | 22,4% |
| OSWorld 2.0, partial | 81,8% | 80,7% | 74,0% | n.v.t. | n.v.t. |
| Chartography, with tools | 89,0% | 88,4% | 83,4% | n.v.t. | n.v.t. |
Lees de voetnoten voordat je op een verschil van één punt een model kiest.
- De safeguards bleven aan. De cyber-fallback was Opus 4.8. De fallback voor biologie en frontier-LLM's was Opus 5. Anthropic zegt dat dit de score waarschijnlijk verlaagt.
- Zapier draaide AutomationBench zonder fallback, dus een interventie telde als een misser. 40,0% is early access. De 41,4% van Astra is het publieke bord.
- De foutmarge van Terminal-Bench 4.0 is ±2,6 punten. 66,4 tegen 57,9 haalt die marge. FrontierCode 54,4 tegen 53,3 niet.
- Anthropic zegt dat het gat in dagelijks gebruik tegenover Fable 5.1 kleiner is dan deze grafiek.
- Artificial Analysis, dezelfde dag, andere opzet: Terminal-Bench 4.0 op 59,6%, gelijk met Astra op xhigh, en Humanity's Last Exam op 61,4% tegen 59,1% voor Fable 5.1. Neem niet het gemiddelde van 66,4 en 59,6.
Default effort is een andere rij. FrontierCode op medium is 54,6%. CursorBench op medium is 52,5%, niet de 57,8% hierboven. Anthropic zegt dat die FrontierCode-score op medium het beste van Astra verslaat, op ongeveer een vijfde van de kost per taak.
Limieten die de prijs van $4 niet opheft
Cybertaken worden omgeleid naar Opus 4.8, en thinking blijft aan op elk API-account.
De goedkopere prijslijst heeft de beperkingen niet gewist die de vorige twee Claude-lanceringen operationeel lastig maakten. Wat er op 22 september wél veranderde, en wat niet:
- De limieten van vijf uur gaan omhoog op Pro, Max, Team en seat-based Enterprise, plus een reset die je kunt bewaren. Geen nieuw berichtenaantal. De weekcap wordt niet als verdwenen beschreven. Oudere vensterregels staan in het stuk over gebruikslimieten.
- Safeguards voor cyber, biologie en distillatie volgen de Fable-klasse. Gewoon bugfixen blijft. De meeste cybertaken worden omgeleid naar Opus 4.8. Biologie vereist het Life Sciences Verification Program. Het bredere cyberprogramma was op de lanceringsdag niet open.
- Thinking kun je niet uitzetten. De lanceerpagina verwijst voor die beperking naar de modeldocs. Preserved thinking, de anti-distillatiecontrole uit Fable 5.1, blokkeert API-gebruikers die eerdere reasoning willen bewerken. Het geldt voor Opus 5.5 op API-accounts die op of na 31 augustus 2026 zijn aangemaakt.
- Het model heeft een watermerk voor de EU AI Act. Zero data retention wordt nog steeds aangeboden, net als bij eerdere Opus-modellen.
- Pogingen tegen de containment-grens daalden zo'n 85% tegenover Opus 5 en Mythos 5.1, zegt Anthropic, en de rest was lage ernst en zelf gemeld. Het model vermoedt vaak een eval, dus die audit voorspelt productie slecht.
- Sonnet 5.5 en Haiku 5.5 staan vandaag niet in de API. De pagina zegt dat ze in de komende weken volgen. Geen datum.
Als je werklast offensive security of wet-lab-ontwerp is, is $4 niet de prijs van een onbeperkte Opus 5.5. De classifier stuurt een deel van die calls naar een ouder model. Je trace moet de fallback tonen, anders factureer je het verkeerde id.
Wat vroege testers tegen Anthropic zeiden
GitHub, Optiver en Box melden minder tokens dan Opus 5. Die regels zijn citaten die Anthropic publiceerde.
Het zijn ondertekende early-access-notities, geen onafhankelijk bord. @claudeai plaatste om 16:31 UTC. Reacties in hetzelfde uur prezen de extra ruimte op Pro en het debuggen. Geen gedeelde trace.
| Wie, op de lanceerpagina | Wat ze zeiden | Wat het niet bewijst |
|---|---|---|
| Mario Rodriguez, GitHub | De minste tokens die ze maten. Terminaltaken in VS Code in minder dan de helft van de stappen van Opus 5. | Geen publieke log. |
| Noyan Tokgozoglu, Optiver | Opus 5-kwaliteit in ongeveer de helft van de beurten, de tijd en de outputtokens. Kosten 40% à 50% lager. | Hun desk. Onze reële korting was 16,8%, cache op 0. |
| Yashodha Bhavnani, Box | Een derde van de tokens, 40% minder verbose, de nauwkeurigheid bleef gelijk. | Hun content-eval. |
| Zimu Li, Factory | Medium evenaarde Opus 5 op high, met 20% tot 25% minder outputtokens. | Onze high-pin kromp de tokens niet. |
| Fabian Hedin, Lovable | Een derde tot de helft minder stappen, en minder tokens. | Hun builder-loop, niet de API-prijslijst. |
De citaten beschrijven minder stappen en minder tokens, een grotere korting dan 20% van de lijstprijs. Onze functie deed het omgekeerde: 336 completion-tokens tegen 316.
Beide kunnen kloppen. Anthropic zegt dat een audit van 200.000 regels in minder dan 3 uur klaar was, tegen meer dan 20 uur voor Opus 5, met 2,5x minder tokens. Wij hebben die niet opnieuw gedraaid.
Wat een cache-zware beurt met de rekening doet
Een cache-herlezing van 500.000 tokens zakt van $0.25 op Opus 5 naar $0.10 op Opus 5.5.
Dit is rekenen op de gepubliceerde tarieven, niet één van de 9 calls. Die calls cacheten niets, dus ze tonen alleen de korting van 20% min de extra tokens. Vul je eigen prefixgrootte in. De mix beïnvloedt het percentage.
| Werklast | Opus 5 | Opus 5.5 | Korting |
|---|---|---|---|
| 500.000 cache-read-tokens | $0.25 | $0.10 | 60% |
| 20.000 verse input + 8.000 output, geen cache | $0.30 | $0.24 | 20% |
| 500.000 cache + 20.000 in + 8.000 uit | $0.55 | $0.34 | 38% |
| Dezelfde 20.000 in + 8.000 uit op fast mode $8/$40 | n.v.t. | $0.48 | een prijsstijging t.o.v. standaard 5.5 |
38% op die derde rij is hoe een tokenkorting van 20% “ongeveer 40% minder op typische werklasten” wordt: een cache-zware agent, standaardinstellingen, plus minder tokens. Haal je de cache weg, dan zit je weer op 20%, tot het model meer praat. Fast mode loopt de andere kant op, $0.48 tegen $0.24 op het stuk zonder cache. De batchrij in de prijstabel ($2/$10) is een catalogusprijs. We stuurden geen batchjob.
Welke Claude Opus 5.5-id je pint na 22 september
Pin claude-opus-5-5 voor nieuw agentverkeer, tenzij de taak cyber of biologie is.
Het Opus 5-stuk van juli zette een model uit de Fable-klasse op de helft van de tokenprijs van Fable. Dat tarief is per 22 september verouderd.
Opus 5.5 ligt nog eens 20% onder de input en output van Opus 5, en 60% onder de cache reads. Safeguards volgen nu Fable 5.1, niet de lossere Opus-lijn. Grok 4.7, dezelfde dag gemeten, is een andere prijslijst.
- Korte API-calls zonder cache, zoals die we beoordeelden: verplaats ze naar Opus 5.5. Het slagingspercentage stond gelijk op 8/8. De rekening ligt 16,8% lager op deze set, en 20,1% lager wanneer de completion-aantallen gelijk zijn.
- Agentloops die een grote prefix herlezen: verplaats die ook, en zet je budget dichter bij het uitgewerkte voorbeeld van 38% dan bij de 16,8% van de factuur. Controleer of
cached_tokensop de response niet nul is, anders zit je nog op het pad van 20%. - Research-evals op max effort: houd het oude Opus 5-budget aan tot je zelf meet. De kost per taak op de Intelligence Index van AA daalde niet mee met de tokenprijs.
- Cyberaanval, biologie-R&D en distillatie-achtig porren: reken er niet op dat Opus 5.5 antwoordt. Verwacht Opus 4.8 of Opus 5, of een weigering. Verificatieprogramma's zijn de deur die Anthropic noemde.
- Fast mode: betaal $8/$40 alleen als 2,5x snelheid 2x de tokens waard is. Het is niet de goedkope laag.
- Laat Fable 5.1 alleen gepind waar je een kwaliteitsgat hebt gemeten dat deze 9 calls niet zien. Fable is 2,5x op input en output. Cache reads zijn $0.25 tegen $0.20.
Veelgestelde vragen
Wat is het API-model-id van Claude Opus 5.5?
Op het Claude-platform is het id claude-opus-5-5. Op OpenRouter is het anthropic/claude-opus-5.5, batch anthropic/claude-opus-5.5:batch. We riepen het standaard-id aan om 18:57 UTC op 22 september 2026. Vermelde context: 1.000.000 tokens. Fast mode is een prijs ($8/$40), geen tweede id op de lanceerpagina.
Haalt Claude Opus 5.5 de gebruikslimiet van vijf uur weg?
Nee. De limiet van vijf uur stijgt op Pro, Max, Team en seat-based Enterprise, en één reset kun je bewaren. Er is geen berichtenaantal gepubliceerd. De weekcap wordt niet als verwijderd beschreven. Limieten in tokens per minuut op de API zijn een aparte meter. Kijk bij Settings, dan Usage.
Kun je thinking uitzetten op Opus 5.5?
Anthropic zegt van niet. De pagina van 22 september zegt dat je thinking niet meer kunt uitzetten. Preserved thinking blokkeert ook accounts die op of na 31 augustus 2026 zijn aangemaakt, zodat ze eerdere reasoning niet kunnen bewerken. Onze call op effort=high gaf nog steeds een gewone functie terug, met 0 reasoning-tokens op het usage-object van OpenRouter. Een high-pin is geen zichtbare chain of thought.
Is de kostenkorting van 40% echt op elke werklast?
Niet op de onze. Acht calls zonder cache kostten 16,8% minder. Alleen het factuurpaar kostte 20,1% minder. Een uitgewerkte mix met 500.000 cache-read-tokens plus een korte completion landt op 38%. Artificial Analysis zegt dat Intelligence Index-taken op max effort ongeveer evenveel kosten als Opus 5, omdat de outputtokens ongeveer 1,6x stegen.
Wanneer verschijnen Claude Sonnet 5.5 en Haiku 5.5?
Anthropic zei dat beide in de komende weken volgen, op de pagina van 22 september 2026, zonder datum. Opus 5.5 was het enige 5.5-id dat we die avond konden aanroepen. Een goedkopere route buiten Opus is nog steeds de vorige Sonnet- of Haiku-kaart.