Claude Sonnet 5.5: السعر نفسه ($2/$10) لكن توفير 30% لا يظهر إلا في المهام الطويلة
أطلقت Anthropic نموذج Claude Sonnet 5.5 في 28 سبتمبر 2026 بسعر Sonnet 5 بالضبط: $2 لكل مليون رمز إدخال و$10 لكل مليون رمز إخراج (نحو 7.5 و37.5 ريال سعودي بسعر صرف 3.75). بعد يوم واحد مررنا 19 استدعاءً مصحَّحًا عبر OpenRouter. في ملف HTML طويل انخفضت الفاتورة 11.1%. وفي مجموع فاتورة صغيرة ارتفعت 12.8%.
السعر واحد، والفاتورة مختلفة.
ما الذي تغيّر عند إطلاق Claude Sonnet 5.5 في 28 سبتمبر؟
بدّل معرّف النموذج إلى claude-sonnet-5-5 وسيبقى سعرك $2 للإدخال و$10 للإخراج لكل مليون رمز.
تعرض صفحة الأسعار لدى Anthropic نموذجي Sonnet 5.5 وSonnet 5 في صفّين متطابقين، بما في ذلك التخزين المؤقت والدُفعات، لذا فأي فرق في التكلفة بينهما ناتج عن عدد الرموز وحده.
| البند | Sonnet 5.5 عند الإطلاق |
|---|---|
| معرّف النموذج في API | claude-sonnet-5-5 |
| الإدخال / الإخراج لكل مليون رمز | $2 / $10 |
| قراءة الكاش / كتابة الكاش | $0.20 / $2.50 (5 دقائق)، $4 (ساعة واحدة) |
| الدُفعات (Batch) إدخال / إخراج | $1 / $5 |
| السياق / أقصى إخراج | 1M / 128K رمز |
| الجهد الافتراضي | Medium في Claude Code والتطبيقات، High في API |
| التوفر | صفر احتفاظ بالبيانات؛ AWS وGoogle Cloud وMicrosoft Azure |
| GitHub Copilot | Pro وPro+ وMax وBusiness وEnterprise، بالسعر المعلن |
المصادر: صفحة نموذج Sonnet 5.5 ومنشور الإطلاق وسجل تغييرات GitHub. خلفية إضافية: ما الذي غيّره Sonnet 5 وأسعار الرموز عبر المزودين.
إلى أي حد يقترب Sonnet 5.5 من Opus 5.5 في جدول Anthropic؟
يتأخر Sonnet 5.5 عن Opus 5.5 بأقل من ثلاث نقاط في أربعة من ستة صفوف نسبية، وفوزه الوحيد يقع ضمن هامش الخطأ.
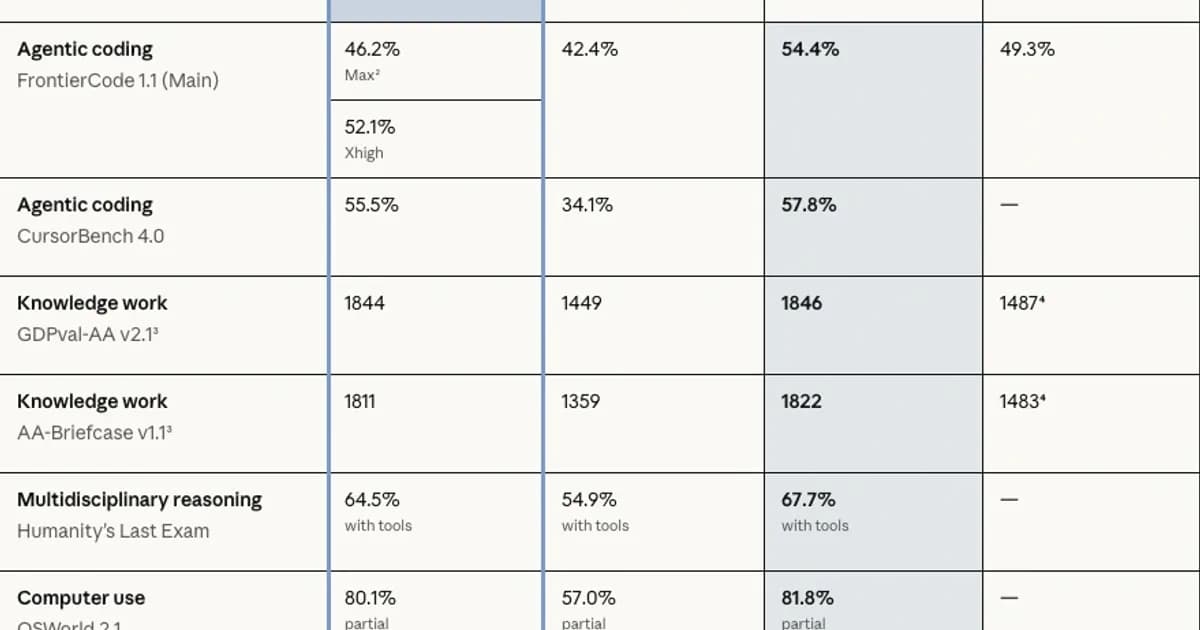
الخلايا أعدنا كتابتها من صورة الغلاف:
| الاختبار | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 10.3% | 66.4%¹ | غير متاح |
| FrontierCode 1.1 Main | 46.2% (Max)²، 52.1% (Xhigh) | 42.4% | 54.4% | 49.3% |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% | غير متاح |
| GDPval-AA v2.1³ | 1844 | 1449 | 1846 | 1487⁴ |
| AA-Briefcase v1.1³ | 1811 | 1359 | 1822 | 1483⁴ |
| HLE (مع الأدوات) | 64.5% | 54.9% | 67.7% | غير متاح |
| OSWorld 2.1 (جزئي) | 80.1% | 57.0% | 81.8% | غير متاح |
| Chartography (بلا أدوات) | 61.6% | 15.6% | 64.4% | 53.6%⁴ |
¹ Opus بجهد Xhigh. ² سجّل Max أقل من Xhigh: شغّل وكلاء فرعيين أكثر لمراجعة الكود، ووجدت Cognition أنهم تسببوا في مهلات زمنية أو تعديلات خارج النطاق في حالتين. ³ أجرتها Artificial Analysis على نسخة ما قبل الإصدار فيها خلل في المخرجات المهيكلة، أُصلح لاحقًا. ⁴ قد لا يعكس الرقم خللًا في صورة GPT-6 Sol. رسما Terminal-Bench وCursorBench لدى Anthropic يعرضان GPT-5.6 Sol.
يتأخر FrontierCode (Xhigh) وCursorBench بمقدار 2.3، وOSWorld بمقدار 1.7، وChartography بمقدار 2.8. أما HLE فهو الاستثناء بفارق 3.2. وصفّا Elo يفصل بينهما 2 و11.
صف Terminal-Bench هذا هو ما غذّى نقاش r/ClaudeCode بعنوان «Sonnet 5.5 beats Opus 5.5 at coding and it's half the price??». تضع بطاقة النظام الخطأ المعياري عند ±2.5 و±2.6 نقطة، فالفارق البالغ 4.2 نقطة يساوي نحو 1.2 خطأ معياريًا مجتمعًا، وشُغّل Sonnet بجهد max بينما شُغّل Opus بجهد xhigh. قاسته Artificial Analysis عند 64% في الاختبار نفسه. أما أوسع تقدم لـ Opus فخارج صفحة الإطلاق: SWE-Bench Pro، 81.3 مقابل 89.9.
GPT-6 Sol مجرد العمود الذي طبعته Anthropic. لمقارنة GPT-6 Astra مع Opus 5.5 راجع اختبارنا الثلاثي.
هل يصمد توفير 30% الذي تدّعيه Anthropic أمام 19 استدعاء API؟
في المهمة الطويلة فقط: أرخص بنسبة 11.1% في مهمة HTML بمتوسط 2,564 رمز إخراج، وأغلى بنسبة 10-13% في مهمتين صغيرتين.
في 29 سبتمبر الساعة 14:25 بالتوقيت العالمي أرسلنا 19 استدعاءً مصحَّحًا عبر OpenRouter إلى Sonnet 5.5 وSonnet 5: 3 مهام، و3 محاولات، ونموذجان، إضافة إلى استدعاء إضافي واحد بجهد مرتفع. إجمالي الفاتورة $0.183434. نجحت الاستدعاءات المتطابقة الثمانية عشر كلها.
# sonnet55_bench.py, 29 Sep 2026, POST https://openrouter.ai/api/v1/chat/completions
body = {
    "model": model,        # anthropic/claude-sonnet-5.5 or anthropic/claude-sonnet-5
    "messages": messages,
    "max_tokens": max_tokens,         # 12000 on the HTML task
    "reasoning": {"effort": effort},  # low: invoice, merge_intervals; medium: HTML
}
لم يصحّح أي نموذج لغوي شيئًا. كان على الفاتورة (800 ألف رمز قراءة كاش، و200 ألف إدخال، و50 ألف إخراج) أن تعيد 1.06 بالضبط، وشغّلت merge_intervals ستة اختبارات assert منفَّذة، وتطلّبت مهمة HTML وجود doctype وcanvas وrequestAnimationFrame وعدم وجود سكربت خارجي. التكاليف هي usage.cost مجموعة على 3 محاولات.
| المهمة (الجهد) | Sonnet 5.5 | Sonnet 5 | الفرق | متوسط رموز الإخراج | متوسط زمن الاستجابة |
|---|---|---|---|---|---|
| الفاتورة (low) | $0.002754 | $0.002442 | +12.8% | 71 / 61 | 2.63 s / 4.49 s |
| merge_intervals (low) | $0.006054 | $0.005502 | +10.0% | 172 / 154 | 3.06 s / 3.68 s |
| HTML بـ150 طائرًا (medium) | $0.077508 | $0.087156 | -11.1% | 2,564 / 2,886 | 15.54 s / 21.61 s |
| الإجمالي المتطابق | $0.086316 | $0.0951 | -9.2% | غير متاح | غير متاح |
تعد Anthropic بتكلفة «أقل بنسبة تصل إلى 30% لكل مهمة مقارنة بسلفه». أضاف ماتياس باستيان في The Decoder التحفظ المناسب: «الاختبارات المستقلة ما زالت مطلوبة لتأكيد هذه الادعاءات».
في عدّادنا ذي الاستدعاءات التسعة عشر بجهد low وmedium، ومع مهمة طويلة واحدة، كان التوفير -11.1% في HTML، وانقلب إلى +12.8% و+10.0% في المهمتين الصغيرتين. السعر المعلن نفسه يعني أن كل توفير هو عدد رموز، وفي أصغر مهمتينا كتب Sonnet 5.5 رموزًا أكثر لا أقل.
السرعة صمدت أفضل. انخفض زمن HTML بنسبة 28.1%، وارتفع الإنتاج من 133.5 إلى 165.0 رمزًا في الثانية (+23.6%): اتجاه صحيح لكنه أقل قليلًا من 30%. وسجّل Sonnet 5 أيضًا 54-63 رمز استدلال في كل استدعاء فاتورة، بينما سجّل Sonnet 5.5 صفرًا في الاستدعاءات العشرة كلها.
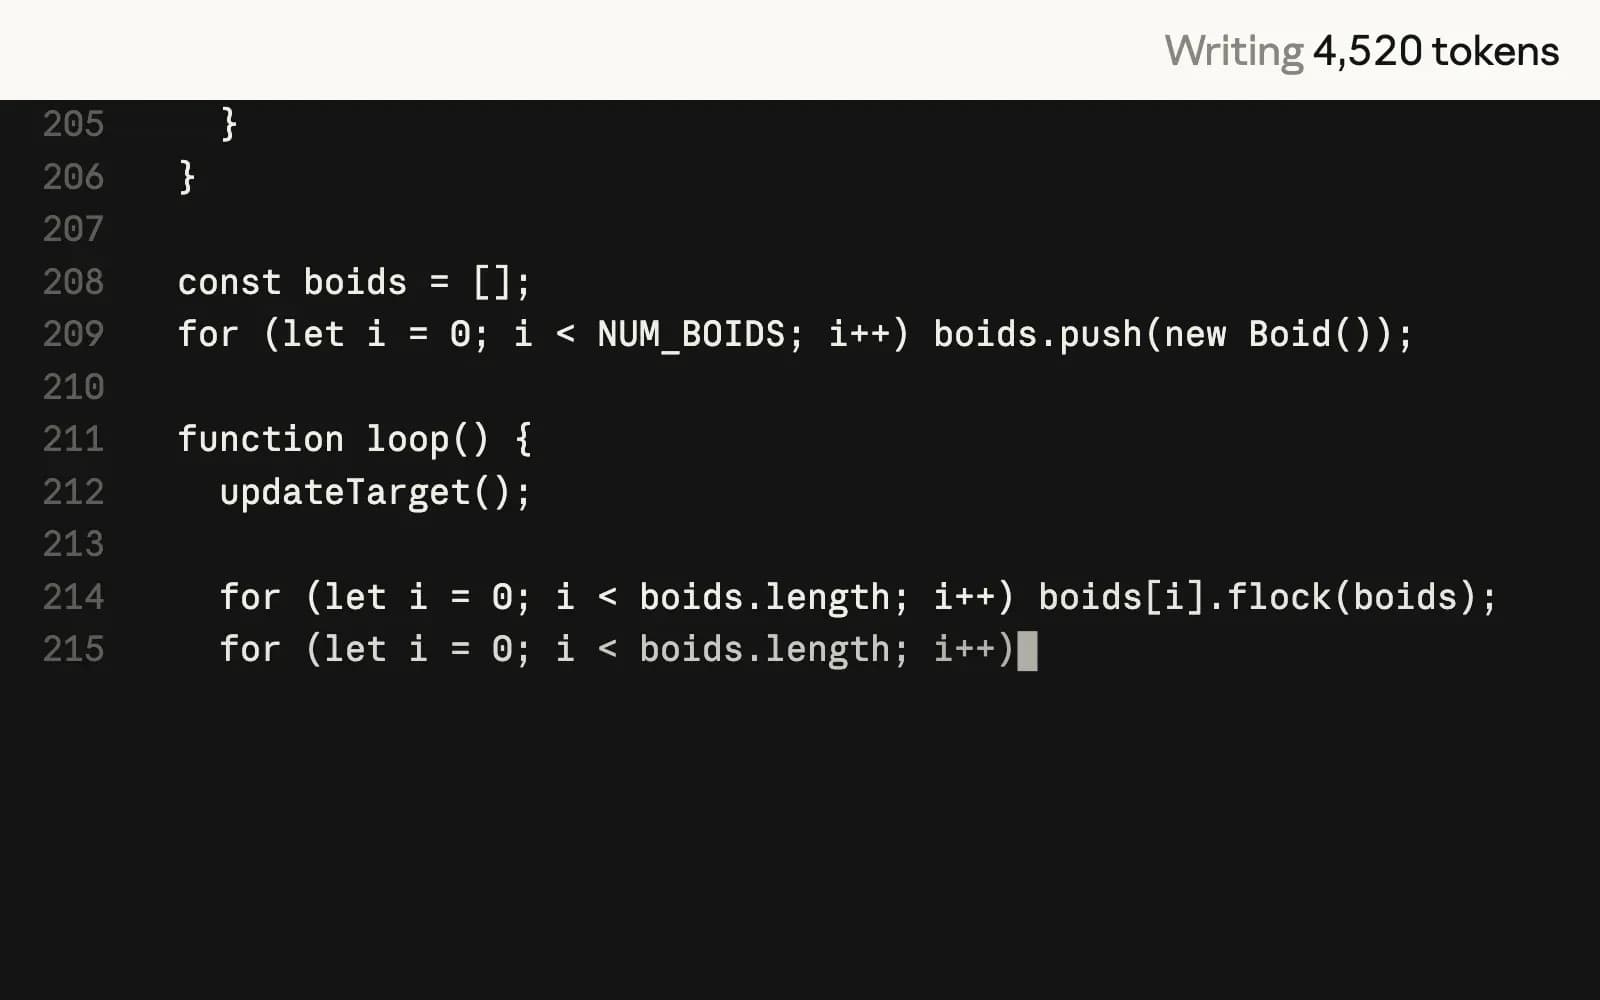
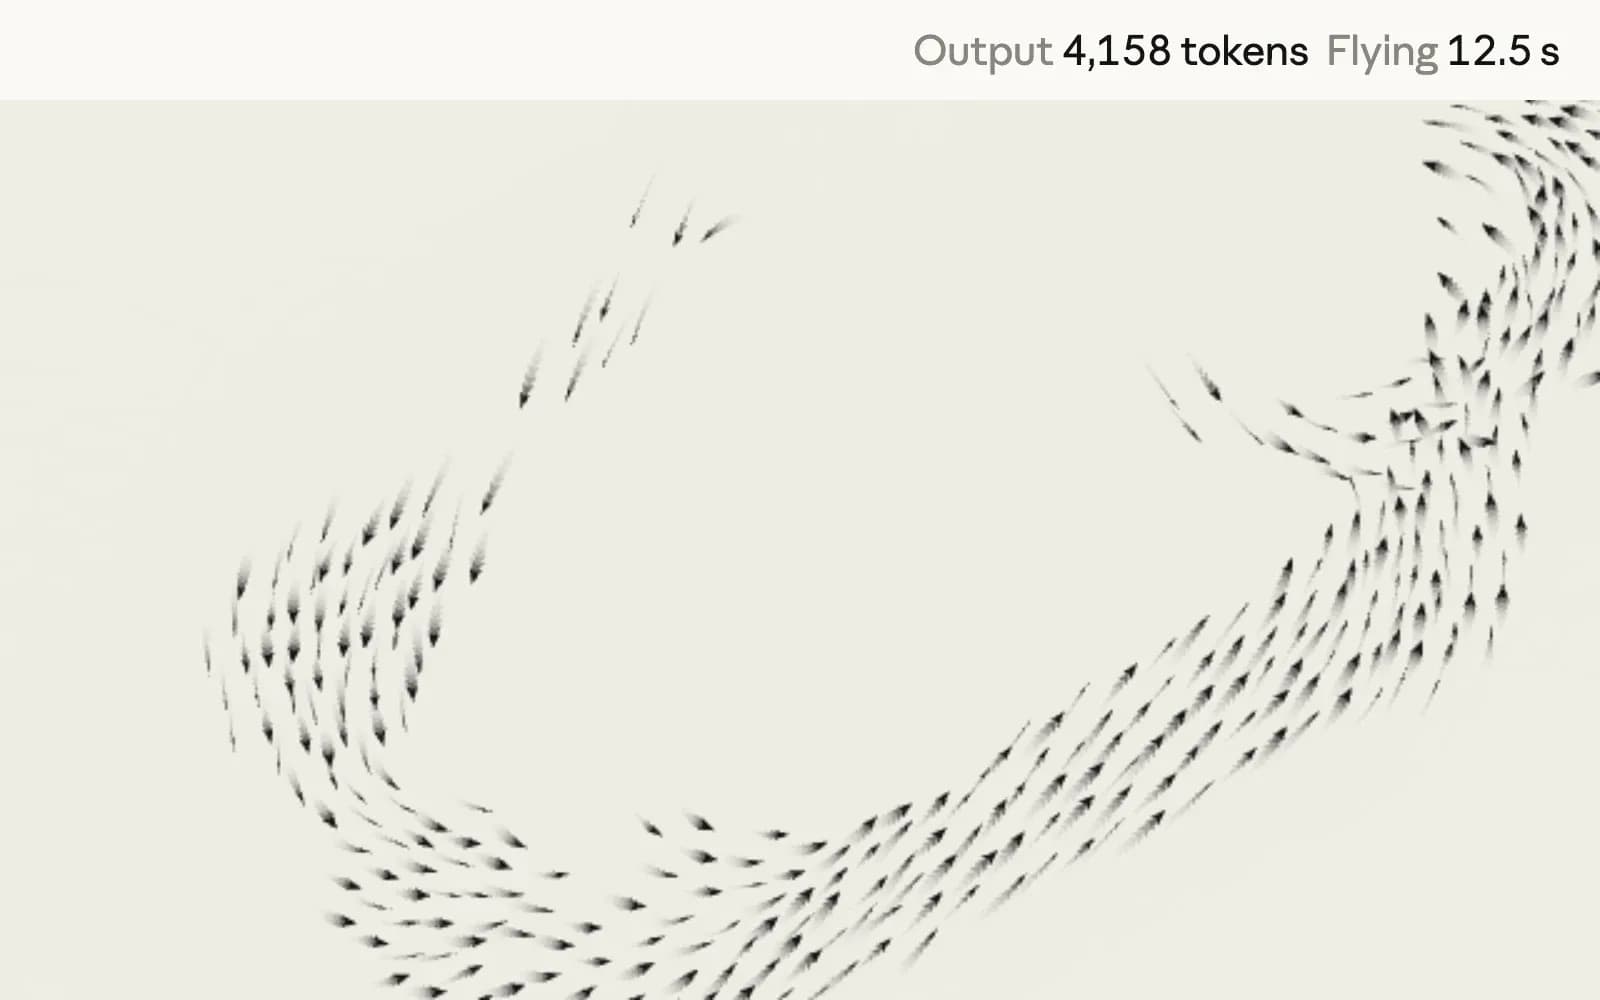
مهمة HTML هذه نسخة بـ150 طائرًا من موجِّه العرض التجريبي في صفحة إطلاق Anthropic، وفيه 400 زرزور. اللقطتان أدناه من تسجيل Anthropic، لا من تشغيلنا.
ماذا قال مختبرو Anthropic عند الإطلاق
«من دون تغيير أي من موجِّهاتنا، تفوّق Claude Sonnet 5.5 على Sonnet 5 في معظم اختبارات Slackbot غير المتصلة لدينا، بخطوات أقل وبنحو 14% رموز إخراج أقل.» كيرتس آلن، مهندس رئيسي، Slack
«أدار النموذج الجديد عشرات الآلاف من أسطر الكود لهندسة نظام اللعب، وحافظ على سرعة الاستجابة، وتعامل مع مهام تمتد ساعات، وسلّم النتيجة بموجِّهات أقل تفصيلًا.» دانيال فوغل، رئيس العمليات، Epic Games
الاقتباسان جمعتهما الجهة المصنِّعة، وكلاهما يصف عملًا طويلًا متعدد الخطوات. مهامنا الصغيرة سارت في الاتجاه المعاكس.
ما لم نقسه: العمل الوكيلي، والاختبارات المعيارية أعلاه، والرجوع الاحتياطي الخاص بالأمن السيبراني. ثلاث محاولات مجرد قياس سريع؛ ولتجري قياسك الخاص اقرأ usage في كل استدعاء.
لماذا يحرّك مستوى الجهد الفاتورة أكثر من النموذج نفسه؟
قاست Artificial Analysis $0.59 للمهمة عند medium و$7.60 عند max، أي قفزة 13 ضعفًا مقابل 15 نقطة في المؤشر.
عند max سجّلت «~193k رمز إخراج لكل مهمة في مؤشر الذكاء. هذا أعلى استهلاك للرموز قسناه».
| الجهد | تكلفة المهمة (AA) | مؤشر الذكاء (AA) | ترتيب AA في 29 سبتمبر |
|---|---|---|---|
| Low | $0.41 | 36 | 63 من 216 |
| Medium | $0.59 | 41 | 44 من 216 |
| High | $1.08 | 47 | 23 من 216 |
| Max | $7.60 | 56 | 3 من 216 |
الصفوف من صفحات النموذج لكل مستوى جهد لدى AA، بتاريخ 29 سبتمبر. قال مقال الإطلاق لدى AA إن Sonnet 5.5 احتل المركز الثاني في المؤشر؛ وعرضت صفحة النموذج في ذلك اليوم 56 والمرتبة 3 من 216. وكلّف max أيضًا «~50% أكثر من تكلفة المهمة في Sonnet 5».
استدعاؤنا الخاص بجهد مرتفع تجاهل الإعداد: كلّف merge_intervals عند effort=high مبلغ $0.002018 مقابل 172 رمز إخراج، مطابقًا لـ low. لا يؤثر الجهد إلا في عمل كبير بما يكفي ليستحق التفكير، وهنا تبدأ خطوات خفض إنفاق API.
ما الذي يُرجع خطأ 400 بعد تبديل معرّف النموذج؟
أي طلب يعطّل التفكير يفشل؛ غيّره إلى between_tools وأبقِ الجهد عند high أو أقل.
يذكر دليل الترحيل لدى Anthropic نص الخطأ صراحة:
# Before (Sonnet 5 habit): 400 invalid_request_error on claude-sonnet-5-5
thinking = {"type": "disabled"}
# '"thinking.type.disabled" is not supported for this model. Use
#  "thinking.type.between_tools" for the lowest thinking setting, ...'

# After: accepted at low / medium / high effort, 400 at xhigh / max
thinking = {"type": "between_tools"}
output_config = {"effort": "medium"} # fixed for the conversation under between_tools- أي
tool_choiceبقيمةanyأوtoolيُرجع 400. استخدمautoمعstrict: true(حد أقصى 20 أداة صارمة)، أوautoوحدها على Amazon Bedrock. - تُسقَط كتل التفكير القادمة من Opus 5 وOpus 5.5 وFable وMythos بصمت؛ والحسابات المنشأة في 31 أغسطس 2026 أو بعده تحصل على 400 عند إعادة إرسال كتلة بعد تعديل السجل. الآلية مطابقة لربط كتل التفكير في Fable 5.1.
- يتطلب استخدام الحاسوب
computer_toolset_20260801على Claude API وGoogle Cloud. - تسمّي حالات الرفض فئة
stop_details، ومنهاcyberوfrontier_llm(«قد يساعد في تطوير نماذج ذكاء اصطناعي منافسة») وreasoning_extraction. - يعيد الرجوع الاحتياطي من جهة الخادم (
fallbacks: "default"، تجريبي، على Claude API فقط) محاولة رفضcyberوfrontier_llmعلى Sonnet 5؛ وتقول بطاقة النظام إن 1.2% من طلبات Terminal-Bench لجأت إليه. - ينخفض الحد الأدنى للموجِّه القابل للتخزين المؤقت إلى 512 رمزًا من 1,024 (حدود التخزين المؤقت للموجِّهات)، ويطبّق
/claude-api migrateفي Claude Code هذه التغييرات.
فرق الأمن يصطدم بالبند 4 أولًا. قال أحد المعلّقين على HN، وهو johnmlussier، إنه رغم وجوده في برنامج التحقق السيبراني «لا يستطيع استخدام Opus 5.5 أو Sonnet 5.5 في أي عمل مكافآت مصرَّح به». تقول Anthropic إن البرنامج الموسّع سيأتي «قريبًا» (Soon).
وتقول قائمة الترحيل نفسها: «أعد تشغيل مسح الجهد، وأعد ضبط خط الأساس للتكلفة». افعل ذلك قبل أن تصدّق رقم 30%.
Sonnet 5.5 أم Opus 5.5: أيهما يأخذ الخانة الافتراضية؟
اجعل Sonnet 5.5 الافتراضي للبرمجة المحددة النطاق والاستدعاءات كثيفة الحجم، وأبقِ Opus 5.5 للأحكام المفتوحة وأي عمل بجهد max.
يُعلن Sonnet بنصف سعر Opus 5.5 البالغ $4/$20، لكن Artificial Analysis قاست Sonnet عند max بتكلفة $7.60 للمهمة مقابل $5.98 لـOpus 5.5، أي أعلى بنحو 27%.
| المؤشر | Sonnet 5.5 | Opus 5.5 | الأرجح |
|---|---|---|---|
| الإدخال / الإخراج لكل مليون | $2 / $10 | $4 / $20 | Sonnet، بنصف السعر |
| قراءة الكاش / كتابة 5 دقائق | $0.20 / $2.50 | $0.20 / $5 | تعادل في القراءة |
| مزيج كثيف الكاش (أدناه) | $1.06 | $1.96 | Sonnet، بنسبة 1.85x لا 2x |
| تكلفة المهمة (AA) عند max | $7.60 | $5.98 | Opus، أرخص بنسبة 27% |
| SWE-Bench Pro | 81.3% | 89.9% | Opus بفارق 8.6 نقطة |
Mix: 800k cache-read + 200k input + 50k output tokens
Sonnet 5.5: 0.8 x $0.20 + 0.2 x $2 + 0.05 x $10 = $0.16 + $0.40 + $0.50 = $1.06
Opus 5.5:   0.8 x $0.20 + 0.2 x $4 + 0.05 x $20 = $0.16 + $0.80 + $1.00 = $1.96
Ratio: 1.96 / 1.06 = 1.85x
رقم «نحو 1.65×» الذي ذكره أليكسي ألينيكوف يعتمد على مزيج لم يوضحه. ضع مزيجك أنت: كلما زادت حصة الكاش، صغرت أفضلية Sonnet.
تقول Anthropic نفسها: «يظل Opus 5.5 أقوى بوضوح في الأعمال المعقدة المفتوحة التي تتطلب حكمًا متواصلًا». وذهب أحد المعلّقين على HN، وهو datadrivenangel، أبعد: «يبدو Opus 5.5 عند Low أذكى وأرخص وأسرع من sonnet عند medium». لم نختبره نحن. تجد أسعار Opus وحدوده في تفصيلنا لـ Opus 5.5.
خيارنا الافتراضي منذ 29 سبتمبر: claude-sonnet-5-5 بجهد medium. المهام بجهد max تذهب إلى Opus 5.5، لأن Sonnet عند max يكف عن كونه النموذج الرخيص.
الأسئلة الشائعة
متى صدر Claude Sonnet 5.5؟
أصدرت Anthropic نموذج Claude Sonnet 5.5 في 28 سبتمبر 2026 بمعرّف claude-sonnet-5-5، في اليوم نفسه على Amazon Web Services وGoogle Cloud وMicrosoft Azure وGitHub Copilot. وتقول وثائق Anthropic إنه لن يُسحب قبل 28 سبتمبر 2027.
هل Claude Sonnet 5.5 أرخص من Sonnet 5؟
ليس لكل رمز: كلاهما بسعر $2 للإدخال و$10 للإخراج. في عدّادنا كلّفت مهمة HTML طويلة أقل بنسبة 11.1% على Sonnet 5.5، ومهمة فاتورة صغيرة أكثر بنسبة 12.8%؛ وعند جهد max قاست Artificial Analysis نحو 50% زيادة لكل مهمة.
هل أستطيع استخدام Sonnet 5.5 في Claude Code وGitHub Copilot؟
نعم. يضبطه Claude Code افتراضيًا على جهد Medium، وAPI على High. وفي GitHub Copilot، من Pro إلى Enterprise، يُحاسَب «بسعر المزوّد المعلن ضمن الفوترة القائمة على الاستخدام». وللتثبيت عليه راجع كيفية تبديل النماذج في Claude Code.
ما نافذة سياق Sonnet 5.5 وتاريخ معرفته؟
يستوعب 1M رمز من السياق ويعيد حتى 128K رمز إخراج، وتاريخ معرفته الموثوق يونيو 2026 بحسب بطاقة النظام.
هل هناك Haiku 5.5؟
ليس حتى 29 سبتمبر 2026. قالت Anthropic في 28 سبتمبر إن Claude Haiku 5.5 «سينضم إلى عائلة Claude 5.5 في الأسابيع المقبلة».