Claude Sonnet 5.5 im Test: gleicher Preis von $2/$10, aber die 30 % Ersparnis gibt es nur bei langen Jobs
Anthropic hat Claude Sonnet 5.5 am 28. September 2026 exakt zum Preis von Sonnet 5 vorgestellt: $2 je Million Input-Token, $10 je Million Output-Token. Einen Tag später haben wir 19 bewertete Calls über OpenRouter geschickt. Bei einer langen HTML-Datei sank die Rechnung um 11,1 %. Bei einer winzigen Rechnungssumme stieg sie um 12,8 %.
Gleicher Preis, andere Rechnung.
Was hat sich mit dem Start von Claude Sonnet 5.5 am 28. September geändert?
Tausch die Modell-ID gegen claude-sonnet-5-5 aus, und dein Preis pro Token bleibt bei $2 für Input und $10 für Output.
Auf Anthropics Preisseite stehen Sonnet 5.5 und Sonnet 5 in identischen Zeilen, Cache und Batch eingeschlossen. Jeder Kostenunterschied zwischen beiden ist also eine Frage der Token-Menge.
| Punkt | Sonnet 5.5 zum Start |
|---|---|
| API-Modell-ID | claude-sonnet-5-5 |
| Input / Output je 1 Mio. Token | $2 / $10 |
| Cache-Read / Cache-Write | $0.20 / $2.50 (5 Min.), $4 (1 Stunde) |
| Batch Input / Output | $1 / $5 |
| Kontext / max. Output | 1M / 128K Token |
| Standard-Effort | Medium in Claude Code und den Apps, High in der API |
| Verfügbarkeit | Zero Data Retention; AWS, Google Cloud, Microsoft Azure |
| GitHub Copilot | Pro, Pro+, Max, Business, Enterprise, zum Listenpreis |
Quellen: Anthropics Modellseite zu Sonnet 5.5, der Launch-Beitrag und das Changelog von GitHub. Hintergrund: was Sonnet 5 verändert hat und Token-Preise verschiedener Anbieter im Vergleich.
Wie nah kommt Sonnet 5.5 auf Anthropics Tabelle an Opus 5.5 heran?
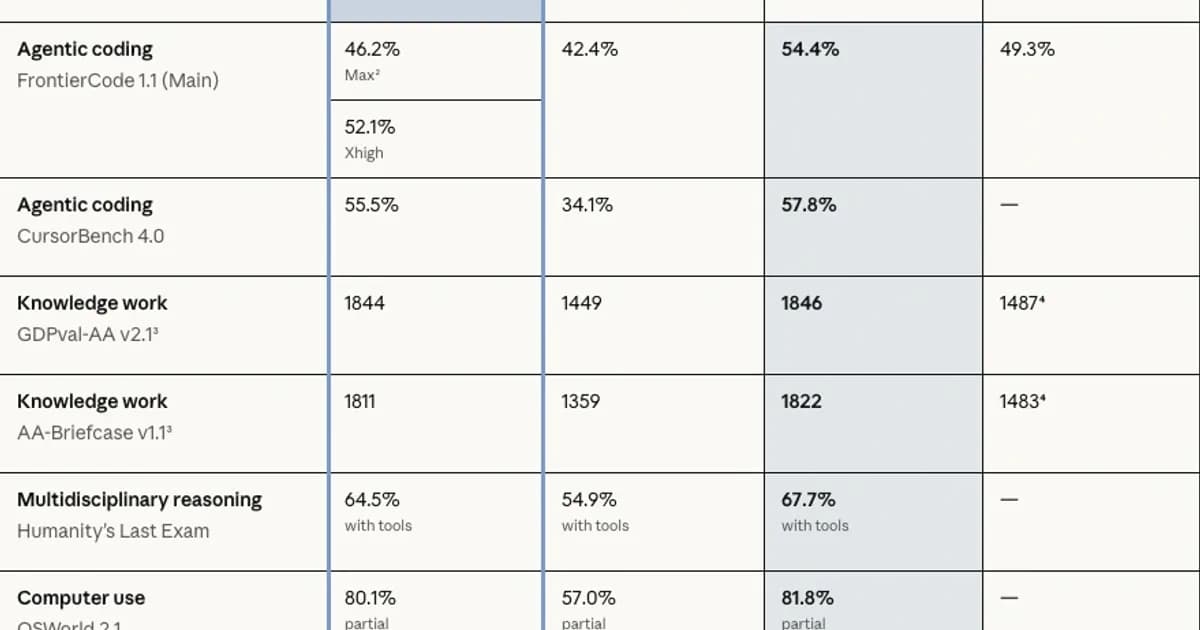
Sonnet 5.5 liegt bei vier von sechs Prozentzeilen weniger als drei Punkte hinter Opus 5.5, und sein einziger Sieg liegt innerhalb der Fehlerbalken.
Die Zellen sind aus dem Hero-Bild abgetippt:
| Benchmark | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70,6 % | 10,3 % | 66,4 %¹ | n/a |
| FrontierCode 1.1 Main | 46,2 % (Max)², 52,1 % (Xhigh) | 42,4 % | 54,4 % | 49,3 % |
| CursorBench 4.0 | 55,5 % | 34,1 % | 57,8 % | n/a |
| GDPval-AA v2.1³ | 1844 | 1449 | 1846 | 1487⁴ |
| AA-Briefcase v1.1³ | 1811 | 1359 | 1822 | 1483⁴ |
| HLE (mit Tools) | 64,5 % | 54,9 % | 67,7 % | n/a |
| OSWorld 2.1 (partiell) | 80,1 % | 57,0 % | 81,8 % | n/a |
| Chartography (ohne Tools) | 61,6 % | 15,6 % | 64,4 % | 53,6 %⁴ |
¹ Opus mit Xhigh-Effort. ² Max lag unter Xhigh: Es startete mehr Code-Review-Subagenten, die laut Cognition in zwei Fällen Timeouts oder Änderungen außerhalb des Auftrags verursacht haben. ³ Von Artificial Analysis auf einem Pre-Release-Deployment mit einem Fehler bei strukturierter Ausgabe gemessen, inzwischen behoben. ⁴ Ein Bildfehler bei GPT-6 Sol ist womöglich nicht berücksichtigt. Anthropics Charts zu Terminal-Bench und CursorBench zeigen GPT-5.6 Sol.
FrontierCode (Xhigh) und CursorBench liegen 2,3 Punkte zurück, OSWorld 1,7, Chartography 2,8. HLE ist mit 3,2 die Ausnahme. Die Elo-Zeilen liegen 2 und 11 Punkte auseinander.
Die Terminal-Bench-Zeile speist den r/ClaudeCode-Thread „Sonnet 5.5 beats Opus 5.5 at coding and it's half the price??“. Die System Card nennt Standardfehler von ±2,5 und ±2,6 Punkten. Die Lücke von 4,2 Punkten entspricht also rund 1,2 kombinierten Standardfehlern, und Sonnet lief auf Max, Opus auf Xhigh. Artificial Analysis hat Sonnet 5.5 im selben Test bei 64 % gemessen. Der größte Vorsprung von Opus steht nicht auf der Launch-Seite: SWE-Bench Pro, 81,3 gegen 89,9.
GPT-6 Sol ist einfach die Spalte, die Anthropic abgedruckt hat. Wie GPT-6 Astra gegen Opus 5.5 abschneidet, steht in unserem Dreier-Test.
Überlebt Anthropics 30-%-Ersparnis 19 API-Calls?
Nur bei der langen Aufgabe: 11,1 % günstiger bei einer HTML-Aufgabe mit durchschnittlich 2.564 Output-Token, 10–13 % teurer bei zwei winzigen Aufgaben.
Am 29. September um 14:25 UTC haben wir 19 bewertete Calls über OpenRouter an Sonnet 5.5 und Sonnet 5 geschickt: 3 Aufgaben, 3 Durchläufe, 2 Modelle, dazu ein zusätzlicher Call mit hohem Effort. Gesamtrechnung: $0.183434. Alle 18 vergleichbaren Calls haben bestanden.
# sonnet55_bench.py, 29 Sep 2026, POST https://openrouter.ai/api/v1/chat/completions
body = {
    "model": model,        # anthropic/claude-sonnet-5.5 or anthropic/claude-sonnet-5
    "messages": messages,
    "max_tokens": max_tokens,         # 12000 on the HTML task
    "reasoning": {"effort": effort},  # low: invoice, merge_intervals; medium: HTML
}
Kein LLM hat etwas bewertet. Die Rechnung (800k Cache-Read-, 200k Input-, 50k Output-Token) musste exakt 1.06 liefern, merge_intervals lief mit 6 ausgeführten Asserts, und das HTML brauchte Doctype, Canvas, requestAnimationFrame und kein externes Skript. Die Kosten sind usage.cost, summiert über 3 Durchläufe.
| Aufgabe (Effort) | Sonnet 5.5 | Sonnet 5 | Delta | Ø Output-Token | Ø Latenz |
|---|---|---|---|---|---|
| Rechnung (low) | $0.002754 | $0.002442 | +12,8 % | 71 / 61 | 2,63 s / 4,49 s |
| merge_intervals (low) | $0.006054 | $0.005502 | +10,0 % | 172 / 154 | 3,06 s / 3,68 s |
| 150-Vögel-HTML (medium) | $0.077508 | $0.087156 | -11,1 % | 2.564 / 2.886 | 15,54 s / 21,61 s |
| Summe vergleichbar | $0.086316 | $0.0951 | -9,2 % | n/a | n/a |
Anthropic verspricht „up to 30% less per task than its predecessor“. Matthias Bastian von The Decoder hat die passende Einschränkung ergänzt: „Independent testing still needs to confirm these claims.“
In unserem 19-Call-Messlauf bei niedrigem und mittlerem Effort mit einer einzigen langen Aufgabe lag die Ersparnis bei -11,1 % auf dem HTML und kippte bei den winzigen Aufgaben auf +12,8 % und +10,0 %. Gleicher Listenpreis heißt: Jede Ersparnis ist eine Token-Menge, und bei unseren zwei kleinsten Aufgaben hat Sonnet 5.5 mehr Token geschrieben, nicht weniger.
Beim Tempo sah es besser aus. Die HTML-Latenz sank um 28,1 %, der Durchsatz stieg von 133,5 auf 165,0 Token pro Sekunde (+23,6 %): richtige Richtung, etwas unter 30 %. Sonnet 5 hat außerdem 54–63 Reasoning-Token pro Rechnungs-Call protokolliert. Sonnet 5.5 hat bei allen 10 Calls 0 protokolliert.
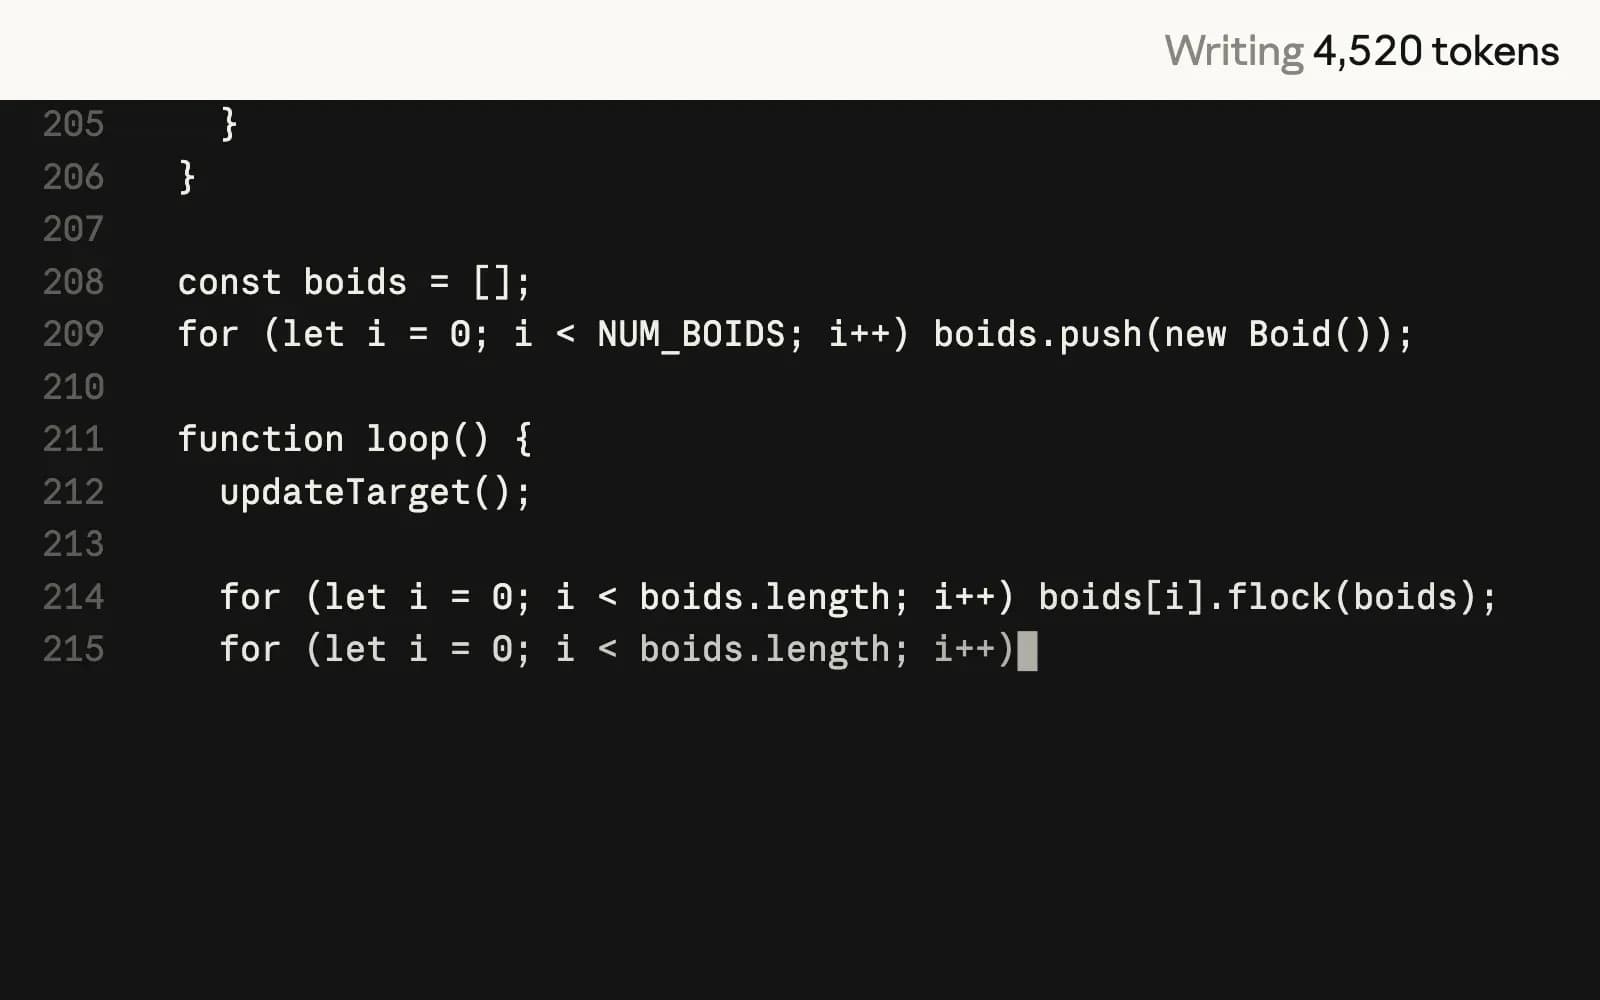
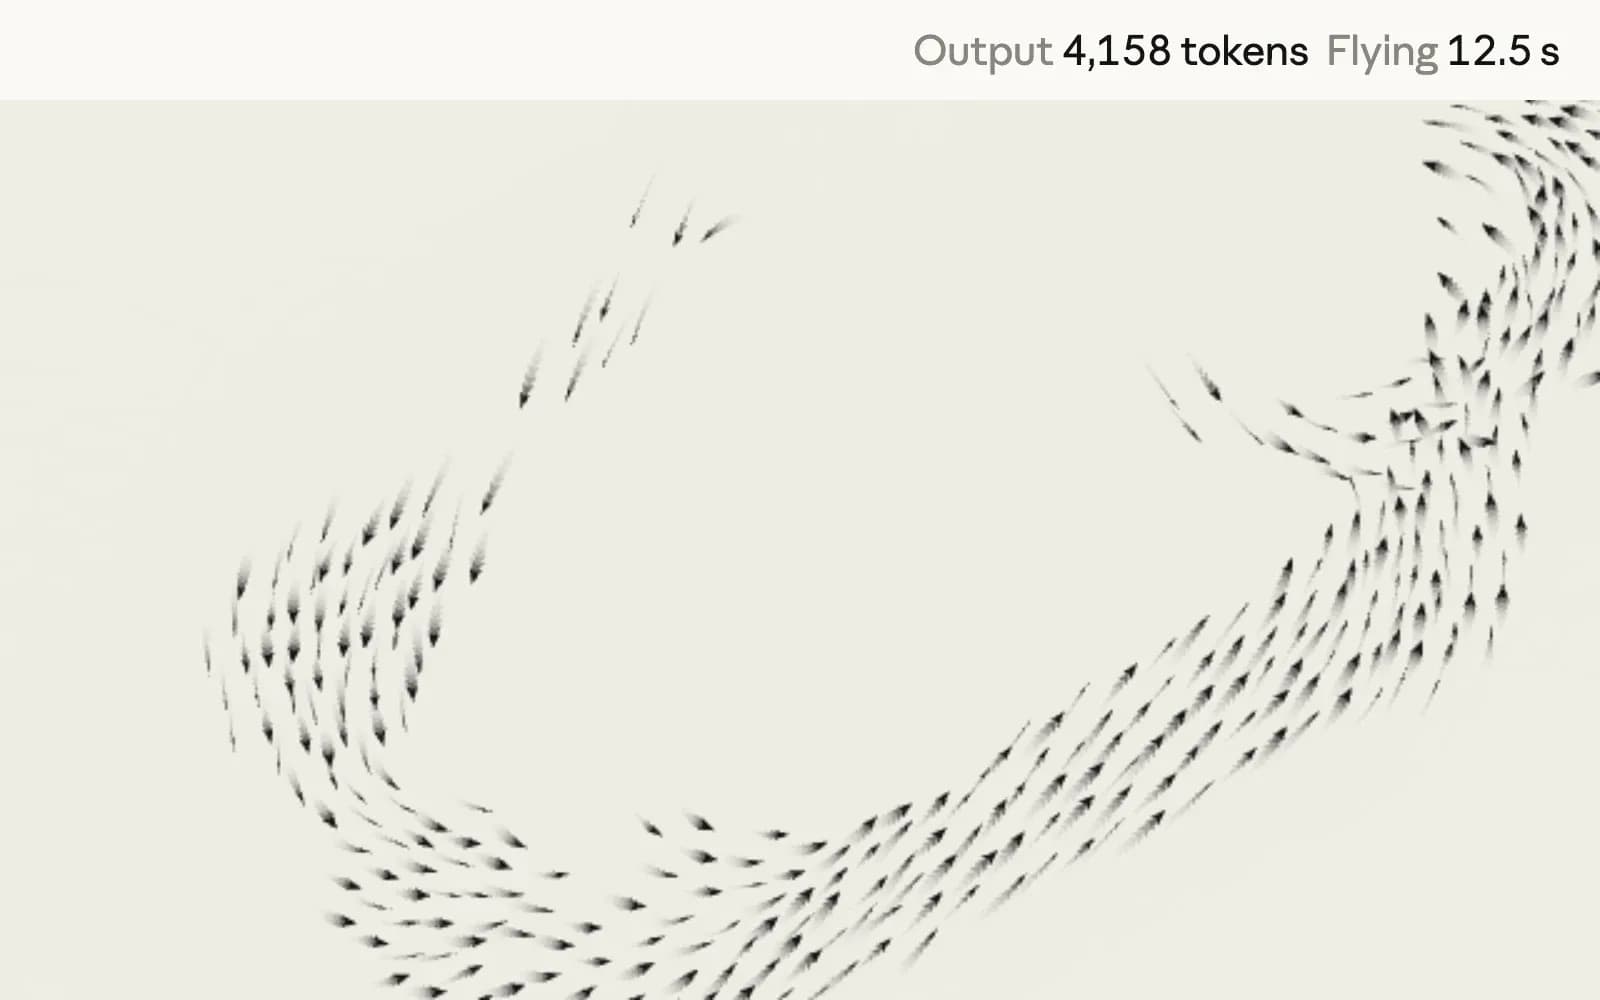
Die HTML-Aufgabe ist eine 150-Vögel-Version von Anthropics Demo-Prompt mit 400 Staren auf der Launch-Seite. Die Frames unten stammen aus Anthropics Aufnahme, nicht aus unserem Lauf.
Was Anthropics Launch-Tester berichten
„Without changing any of our prompts, Claude Sonnet 5.5 did better than Sonnet 5 on almost all of our offline Slackbot evals, in fewer steps and with about 14% fewer output tokens.“ Curtis Allen, Principal Engineer, Slack
„The new model managed tens of thousands of lines of code for gameplay system architecture, kept responses snappy, handled multi-hour tasks, and delivered with less prescriptive prompting.“ Daniel Vogel, Chief Operating Officer, Epic Games
Beide Zitate wurden vom Hersteller eingesammelt, und beide beschreiben lange Aufgaben mit vielen Schritten. Unsere winzigen Aufgaben gingen in die andere Richtung.
Nicht gemessen haben wir: Agenten-Arbeit, die Benchmarks oben, den Cyber-Fallback. Drei Durchläufe sind eine Stichprobe, kein Beweis. Willst du selbst messen, lies bei jedem Call usage aus.
Warum bewegt der Effort die Rechnung stärker als das Modell?
Artificial Analysis hat $0.59 pro Aufgabe bei Medium und $7.60 bei Max gemessen, ein Sprung um das 13-Fache für 15 Index-Punkte.
Bei Max zählte AA „~193k Output Tokens per Intelligence Index Task. This is the highest token use we have measured“.
| Effort | AA-Kosten pro Aufgabe | AA Intelligence Index | AA-Rang, 29. Sep. |
|---|---|---|---|
| Low | $0.41 | 36 | 63 von 216 |
| Medium | $0.59 | 41 | 44 von 216 |
| High | $1.08 | 47 | 23 von 216 |
| Max | $7.60 | 56 | 3 von 216 |
Die Zeilen stammen von AAs Modellseiten je Effort, abgerufen am 29. September. AAs Launch-Artikel nannte Sonnet 5.5 auf Platz zwei des Index. Die Modellseite zeigte an diesem Tag 56 und Rang 3 von 216. Max kostete außerdem „~50% higher than Sonnet 5's Cost per Task“.
Unser eigener Call mit hohem Effort ignorierte die Einstellung: merge_intervals mit effort=high kostete $0.002018 für 172 Output-Token, identisch mit low. Effort greift erst bei Arbeit, die groß genug zum Nachdenken ist. Genau da fängt es an, LLM-API-Kosten zu senken.
Was liefert nach dem Tausch der Modell-ID einen 400er?
Jeder Request mit deaktiviertem Thinking schlägt fehl; stell ihn auf between_tools um und halte den Effort bei High oder darunter.
Anthropics Migrationsanleitung nennt den Fehler wörtlich:
# Before (Sonnet 5 habit): 400 invalid_request_error on claude-sonnet-5-5
thinking = {"type": "disabled"}
# '"thinking.type.disabled" is not supported for this model. Use
#  "thinking.type.between_tools" for the lowest thinking setting, ...'

# After: accepted at low / medium / high effort, 400 at xhigh / max
thinking = {"type": "between_tools"}
output_config = {"effort": "medium"} # fixed for the conversation under between_toolstool_choicemitanyodertoolliefert 400. Nimmautoplusstrict: true(maximal 20 strikte Tools) oder auf Amazon Bedrock nurauto.- Thinking-Blöcke von Opus 5, Opus 5.5, Fable oder Mythos werden stillschweigend verworfen. Konten, die am oder nach dem 31. August 2026 angelegt wurden, bekommen einen 400, wenn sie einen Block nach einer Änderung am Verlauf erneut senden. Die Mechanik entspricht der Thinking-Block-Bindung bei Fable 5.1.
- Computer Use braucht
computer_toolset_20260801in der Claude API und auf Google Cloud. - Ablehnungen nennen eine
stop_details-Kategorie, daruntercyber,frontier_llm(„could assist the development of competing AI models“) undreasoning_extraction. - Der serverseitige Fallback (
fallbacks: "default", Beta, nur Claude API) wiederholt Ablehnungen der Kategoriencyberundfrontier_llmmit Sonnet 5. Laut System Card sind 1,2 % der Terminal-Bench-Requests auf den Fallback gefallen. - Der minimale cachebare Prompt sinkt von 1.024 auf 512 Token (Mindestgrößen beim Prompt Caching), und
/claude-api migratein Claude Code übernimmt diese Änderungen.
Security-Teams stoßen zuerst auf Punkt 4. Ein HN-Kommentator, johnmlussier, schrieb, sie könnten trotz Teilnahme am Cyber Verification Program „can't use Opus 5.5 or Sonnet 5.5 for any authorized bounty work“. Anthropic sagt, das erweiterte Programm komme „Soon“.
Dieselbe Checkliste sagt: „Re-run your effort sweep, and re-baseline cost“. Mach das, bevor du den 30 % traust.
Sonnet 5.5 oder Opus 5.5: welches Modell bekommt den Standardplatz?
Nimm Sonnet 5.5 als Standard für klar umrissenes Coding und Calls mit hohem Volumen; behalte Opus 5.5 für offene Abwägungen und jede Arbeit mit Max-Effort.
Sonnet kostet laut Liste die Hälfte von Opus 5.5 mit $4/$20. Artificial Analysis hat Sonnet bei Max aber mit $7.60 pro Aufgabe gemessen, gegen $5.98 bei Opus 5.5: rund 27 % mehr.
| Signal | Sonnet 5.5 | Opus 5.5 | Tendenz |
|---|---|---|---|
| Input / Output je 1 Mio. | $2 / $10 | $4 / $20 | Sonnet, halber Preis |
| Cache-Read / 5-Min-Write | $0.20 / $2.50 | $0.20 / $5 | Gleichstand beim Lesen |
| Cache-lastiger Mix (unten) | $1.06 | $1.96 | Sonnet, 1,85x statt 2x |
| AA-Kosten pro Aufgabe, Max-Effort | $7.60 | $5.98 | Opus, 27 % günstiger |
| SWE-Bench Pro | 81,3 % | 89,9 % | Opus um 8,6 Punkte |
Mix: 800k cache-read + 200k input + 50k output tokens
Sonnet 5.5: 0.8 x $0.20 + 0.2 x $2 + 0.05 x $10 = $0.16 + $0.40 + $0.50 = $1.06
Opus 5.5:   0.8 x $0.20 + 0.2 x $4 + 0.05 x $20 = $0.16 + $0.80 + $1.00 = $1.96
Ratio: 1.96 / 1.06 = 1.85x
Aleksei Aleinikovs „approximately 1.65ד hängt von einem Mix ab, den er nicht nennt. Setz deinen eigenen ein: Je größer dein Cache-Anteil, desto kleiner Sonnets Vorsprung.
Anthropic selbst sagt: „Opus 5.5 remains clearly stronger at complex, open-ended work requiring sustained judgment.“ Ein HN-Kommentator, datadrivenangel, ging weiter: „Opus 5.5 on Low seems smarter, cheaper, and faster than sonnet on medium“. Von uns ungetestet. Preise und Limits von Opus findest du in unserer Analyse zu Opus 5.5.
Unser Standard seit dem 29. September: claude-sonnet-5-5 mit mittlerem Effort. Jobs mit Max-Effort gehen an Opus 5.5, denn bei Max ist Sonnet nicht mehr das günstige Modell.
Frequently Asked Questions
Wann ist Claude Sonnet 5.5 erschienen?
Anthropic hat Claude Sonnet 5.5 am 28. September 2026 als claude-sonnet-5-5 veröffentlicht, am selben Tag bei Amazon Web Services, Google Cloud, Microsoft Azure und GitHub Copilot. Laut Anthropics Doku wird es nicht vor dem 28. September 2027 abgeschaltet.
Ist Claude Sonnet 5.5 günstiger als Sonnet 5?
Nicht pro Token: Beide kosten laut Liste $2 für Input und $10 für Output. In unserem Messlauf kostete eine lange HTML-Aufgabe mit Sonnet 5.5 11,1 % weniger und eine winzige Rechnungsaufgabe 12,8 % mehr; bei Max-Effort hat Artificial Analysis rund 50 % mehr pro Aufgabe gemessen.
Kann ich Sonnet 5.5 in Claude Code und GitHub Copilot nutzen?
Ja. Claude Code setzt es standardmäßig auf Medium-Effort, die API auf High. In GitHub Copilot, von Pro bis Enterprise, wird es „billed at provider list pricing under usage-based billing“. Wie du es festlegst, steht unter Modelle in Claude Code wechseln.
Wie groß sind Kontextfenster und Knowledge Cutoff von Sonnet 5.5?
Es nimmt 1M Token Kontext auf und liefert bis zu 128K Output-Token, mit einem verlässlichen Knowledge Cutoff von Juni 2026 laut System Card.
Gibt es ein Haiku 5.5?
Stand 29. September 2026 nicht. Anthropic hat am 28. September gesagt, Claude Haiku 5.5 „will join the Claude 5.5 family in the coming weeks.“