GPT-6 Astra vs Claude Opus 5.5 vs Grok 4.7: Rechnung, GDPval und ein Sechs-Call-Meter
GPT-6 Astra, Claude Opus 5.5 und Grok 4.7 waren am 22. September 2026 um 22:34 UTC alle auf OpenRouter aufrufbar. Sechs benotete Calls, zwei Aufgaben, je ein Durchgang, alle bestanden. Die Gateway-Rechnung lag bei $0.01626.
Die Launch-Charts decken sich nicht.
Auf dem Board von Anthropic steht Astra und kein Grok. Auf dem Board von xAI stehen Fable 5.1 und Sol, dazu Astra auf einem Elo-Chart. Diese Seite behält die gemeinsamen Anker und hört auf, wo die Maßstäbe auseinandergehen.
Der Vergleich Opus gegen Opus 5 bleibt im Beitrag zu Opus 5.5. Das Upgrade 4.7 gegen 4.6 bleibt im Beitrag zu Grok 4.7. Astra gegen Fable bleibt im Beitrag zu GPT-6 Astra.
Drei Karten, und die Prompt-Länge, die den Preis neu setzt
Astra verlangt das 2,5-Fache des Token-Preises von Opus 5.5 bei Input und bei Output und das 5-Fache beim Cache-Read. Grok kostet auf der xAI-Karte die Hälfte des Input-Preises von Opus 5.5 und das 0,3-Fache beim Output, bis der Prompt 200.000 Token überschreitet.
Opus 5.5 ist die Bezugszeile mit Faktor 1,0: $4, $20 und $0.20 je Million.
Die Modellkarte von Astra nennt $10, $50 und $1.00. Die Karte von Grok vom 21. September nennt $2, $6 und $0.50 unter 200.000 Prompt-Token.
| Zeile, je 1 Mio. Token, unter der Kante | Opus 5.5 | GPT-6 Astra | Grok 4.7, xAI-Karte |
|---|---|---|---|
| Input | $4 | $10 | $2 |
| Output | $20 | $50 | $6 |
| Cache-Read | $0.20 | $1.00 | $0.50 |
| Kontext | 1.000.000 | 1.050.000 | 500.000 |
| Kante | keine auf dieser Karte | 272.000 Prompt-Token: Input und Cache 2×, Output 1,5× | 200.000 Prompt-Token: die ganze Anfrage geht auf $4 / $12 / $1 |
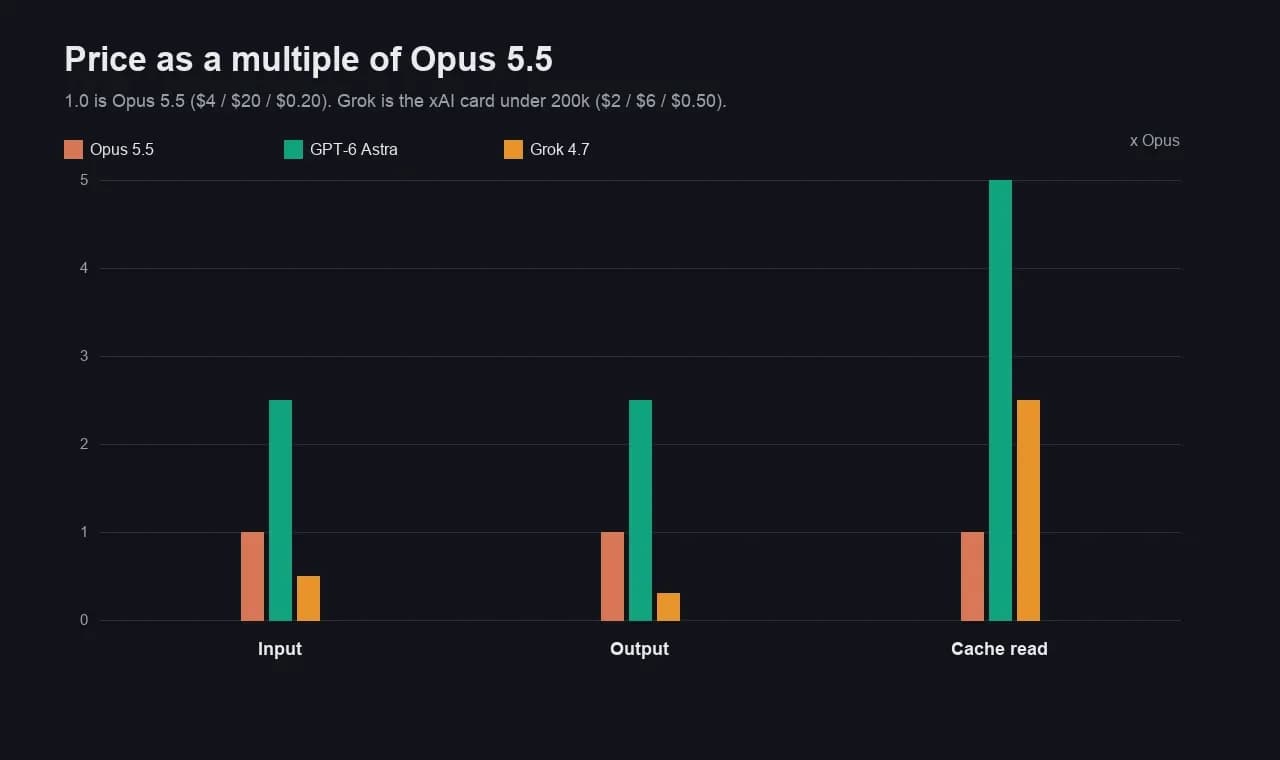
OpenRouter stimmte um 22:34 UTC mit den Preisen von Opus und Astra überein. Bei Grok nicht.
Im Katalog standen $1.60, $4.80 und $0.40, ab 200.000 Prompt-Token dann $3.20, $9.60 und $0.80. Das ist das 0,8-Fache der xAI-Karte. Unsere Zahlen in usage.cost nutzen diesen Katalog. Der Text zu Grok 4.7 rechnet die eigene Karte von xAI weiter mit $2 und $6.
Ein Cache-Read über 500.000 Token, nur gerechnet: Opus $0.10, Astra $0.25, die Cache-Zeile von Grok auf der xAI-Karte $0.25. Teuer ist Astra beim Cache, nicht beim Output. Beim Output liegt zwischen den $6 von Grok und den $50 von Astra der Faktor 8,3, zwischen Grok und den $20 von Opus der Faktor 3,3.
Sechs benotete Calls, und die Rechnung, die jedes Modell wirklich schickte
Alle sechs haben bestanden. Die zwei Calls von Grok kosteten $0.0038784, Opus 5.5 kostete $0.005292, Astra kostete $0.00709.
Die Antwort auf der Rechnung musste 1,96 sein. merge_intervals musste versteckte Tests bestehen, darunter aneinanderstoßende Intervalle.
Bei Opus und Astra standen die gecachten Token auf 0. Grok meldete auf beiden Calls 1.152 gecachte Token, enthalten in Prompt-Zählern von 1.310 und 1.336. 295 seiner 298 Token auf der Rechnung waren Reasoning.
# 22 Sep 2026, 22:34 UTC, OpenRouter, one trial, max_tokens 1800
MODELS = [
    "anthropic/claude-opus-5.5",
    "openai/gpt-6-astra",
    "x-ai/grok-4.7",
]| Aufgabe | Opus 5.5 | GPT-6 Astra | Grok 4.7 |
|---|---|---|---|
| Rechnung, muss 1,96 sein | bestanden, $0.001336, 46 Output, 4,277 s | bestanden, $0.00263, 38 Output, 2,116 s | bestanden, $0.002144, 298 Output, 5,292 s |
| merge_intervals | bestanden, $0.003956, 168 Output, 3,307 s | bestanden, $0.00446, 69 Output, 2,588 s | bestanden, $0.0017344, 204 Output, 4,217 s |
| Summe beider Aufgaben | $0.005292 | $0.00709 | $0.0038784 |
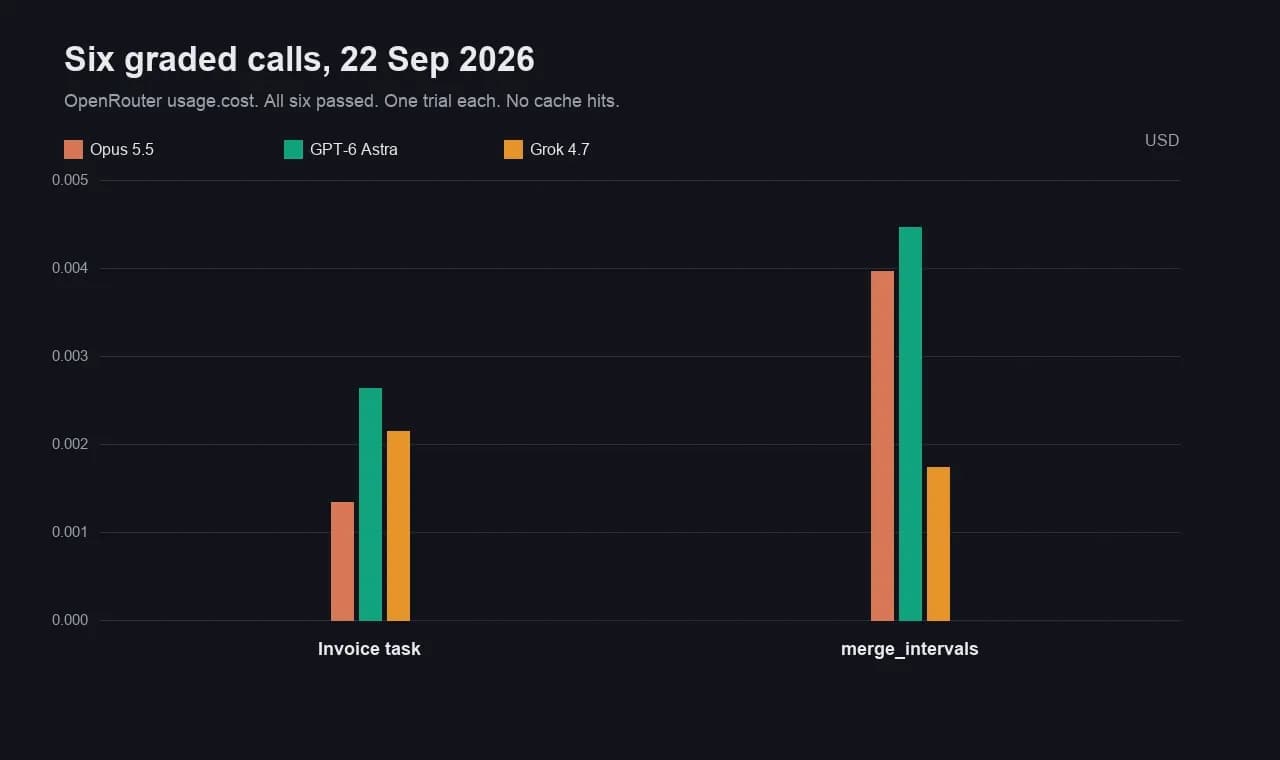
Astra hat die wenigsten Token geschrieben und die höchste Rechnung geschickt.
38 und 69 Completion-Token, gegen 46 und 168 bei Opus. Die Karte mit $10/$50 hat die Ersparnis aufgefressen. Die beiden Zahlen in usage.cost treffen $10 und $50 exakt. Opus trifft $4 und $20.
Grok lag bei der Rechnung hinten und bei der Funktion vorn. 204 Token zu $4.80 landeten bei $0.0017344.
Astra war auf beiden Aufgaben am schnellsten, 2,116 s und 2,588 s. Ein Durchgang ist kein Geschwindigkeitsranking.
Im Text zu Astra vom 4. September stand, openai/gpt-6-astra habe HTTP 400 geliefert. Das galt um 14:40 UTC an dem Tag. Für diesen Lauf gilt es nicht. Die ID hat gegriffen, der Call gab 1,96 zurück, und die Tests sind bestanden.
GDPval ist die Zeile, die beide Labs wirklich teilen
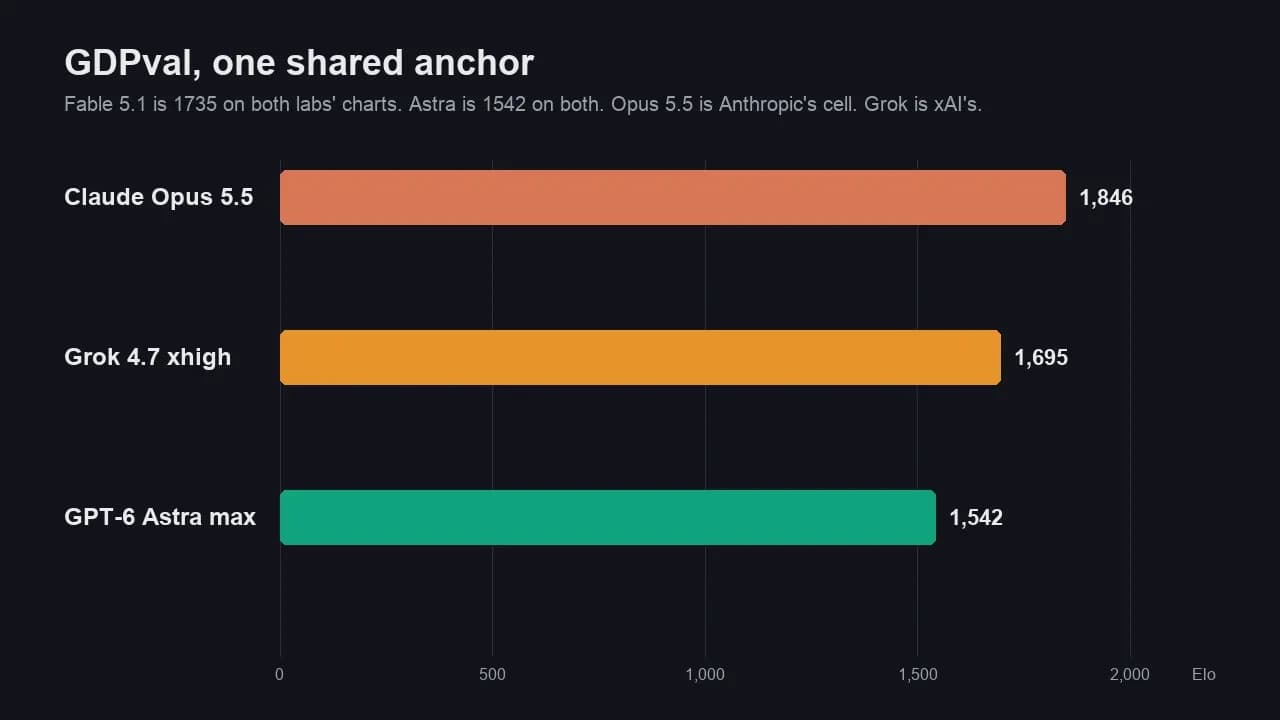
Opus 5.5 führt diese gemeinsame Zeile mit 1.846 an. Grok 4.7 xhigh liegt bei 1.695. Astra max liegt bei 1.542.
Fable 5.1 mit 1.735 ist der Anker, keine vierte Wahl.
Anthropic nennt 1.735, Astra bei 1.542 und Opus 5.5 bei 1.846. xAI nennt dieselben 1.735 und 1.542, dazu Grok 4.7 xhigh bei 1.695. Zwei kopierte Zahlen halten die Balken auf einer Achse.
| Zelle | Score | Wer sie nennt |
|---|---|---|
| Claude Opus 5.5 | 1.846 | Anthropic, 22. Sep. 2026, GDPval-AA v2.1 |
| Grok 4.7 xhigh | 1.695 | Launch-Chart von xAI, 21. Sep. 2026, GDPval |
| GPT-6 Astra max | 1.542 | Beide Charts |
| Fable 5.1 max, nur Anker | 1.735 | Beide Charts |
Opus liegt 151 Elo über Grok und 304 über Astra. Grok liegt 153 über Astra und 40 hinter dem Anker von Fable. Gemessen haben wir das nicht. Unsere sechs Calls waren eine Rechnung auf zwei Nachkommastellen und eine Merge-Funktion. Büroarbeit bewerten sie nicht.
Artificial Analysis hat Opus 5.5 bei max Effort auf 58 im Intelligence Index gesetzt und geschrieben, die Kosten je Aufgabe seien auf dem Niveau von Opus 5 geblieben, weil die Output-Token um etwa das 1,6-Fache gestiegen seien. Die Notiz zu Grok 4.7 setzt dieses Modell auf 46 im selben Index. Anderer Maßstab, dieselbe Richtung: Opus vor Grok. Die Token-Rechnung lässt du deshalb nicht weg.
Terminal-Bench und CursorBench sind nicht derselbe Maßstab
Mittel die 66,4 % von Anthropic nicht mit den 38,0 % von xAI. Das ist nicht dieselbe Zelle auf Terminal-Bench.
- Anthropic, Opus 5.5 auf xhigh, Astra auf high, so wie OpenAI es gemeldet hat: Terminal-Bench 4.0 liegt bei 66,4 % für Opus 5.5 und bei 57,9 % für Astra. Fable 5.1 steht auf dieser Seite bei 55,8 %. CursorBench 4.0 liegt bei 57,8 % für Opus 5.5 und bei 51,8 % für Fable. Die CursorBench-Zelle von Astra ist leer.
- Das Scoreboard von xAI: Terminal-Bench 4.0 liegt bei 38,0 % für Grok 4.7 xhigh und bei 57,9 % für Fable 5.1 Max. CursorBench liegt bei 46,3 % für Grok und bei 51,8 % für Fable. Astra steht auf diesem Board nicht. Die CursorBench-Zelle von Fable, 51,8 %, trifft den Wert von Anthropic. Die Terminal-Bench-Zelle von Fable nicht: dort 57,9 %, auf der Seite von Anthropic 55,8 %.
- Artificial Analysis, ein drittes Setup: Opus 5.5 bei 59,6 % auf Terminal-Bench 4.0, gleichauf mit Astra auf xhigh. Der Sprung von Grok auf dem Agent-Lauf dieses Labs ging von 18 % auf 33 %, nicht auf 38,0 %.
CursorBench lässt sich nebeneinanderlegen, weil 51,8 % zweimal auftaucht. Opus 5.5 mit 57,8 % führt Fable um 6,0 Punkte an, auf der Zahl mit höherem Effort bei Anthropic. Grok mit 46,3 % liegt 5,5 Punkte hinter dieser Fable-Zelle. Astra hat keine Zelle. Nenn das Lab neben dem Prozentwert, sonst ist das Ranking eine Collage.
EEBench, Harvey und HealthBench sind Zeilen von xAI. Opus 5.5 und Astra fehlen. Die bleiben im Beitrag zu Grok. AutomationBench und Terminal-Bench-Science sind Zeilen von Anthropic und OpenAI. Grok fehlt. Die bleiben in den Beiträgen zu Opus und Astra.
Was jeder bestehende Beitrag weiter selbst behält
Diese Seite ersetzt die drei Texte nicht, auf die sie verweist. Hier stehen nur die drei Modelle gegeneinander.
- Der Beitrag zu Opus 5.5 behält den Preis von $4/$20, das Meter mit $0.02719, das Fünf-Stunden-Limit und den Cyber-Fallback auf Opus 4.8. Das Cover bleibt das Chart von Anthropic. Die Spalten zu Astra liest du hier.
- Der Beitrag zu Grok 4.7 behält 4.7 gegen 4.6: zwölf Calls, 12/12, und die Kante bei $2/$6. Der Balken bei 1.695 gehört dorthin. Opus 5.5 nicht.
- Der Beitrag zu Astra behält Astra gegen Fable 5.1, einschließlich der HTTP 400 vom 4. September und des Splits von 99,9 % gegen 62,7 %. Seit dem 22. September lässt sich die ID aufrufen. Die Entscheidung für Fable nicht.
Welches der drei du pinnst
Pinne Grok 4.7, wenn die Output-Rechnung das Produkt ist und der Job in 500.000 Token passt. Pinne Opus 5.5, wenn die gemeinsame GDPval-Zeile das Produkt ist. Pinne Astra, wenn du einen Computer-Use- oder Mathe-Job schon gemessen hast, den die beiden anderen Beiträge dokumentieren, und du $10/$50 zahlen kannst.
- Kurze Calls ohne Cache, wie diese sechs: Grok war in der Summe am günstigsten, $0.0038784 gegen $0.005292 und $0.00709, und auf der Rechnung das teure Modell, weil das Reasoning auf 295 Token lief. Sehen deine kurzen Calls aus wie
merge_intervals, kopiere die Funktionszeile. Sehen sie aus wie eine einzelne Zahl, hat Opus 46 Token ausgegeben und diese Zeile gewonnen. - Agenten mit viel Cache unter 200.000 Prompt-Token: Opus schlägt mit $0.20 je Million gecachter Token beide anderen. Astra liegt mit $1.00 beim 5-Fachen dieser Zeile. Die Cache-Zeile von Grok auf der xAI-Karte liegt bei $0.50, dem 2,5-Fachen von Opus.
- Prompts, die 200.000 Token überschreiten: Grok setzt den Preis der ganzen Anfrage neu an. Ein Prompt mit 250.000 Token kostet auf der xAI-Karte $4 und $12, nicht $2 und $6. Die Kante von Astra beginnt später, bei 272.000, und Token unter der Linie behalten ihren Satz. Die Docs von Grok beschreiben den anderen Fall: die ganze Anfrage springt.
- Büroarbeit, die du GDPval anvertraust: Opus 1.846, dann Grok 1.695, dann Astra 1.542, mit den 1.735 von Fable zwischen Opus und Grok. Diese Reihenfolge ist die der Labs. Ein Score aus den sechs Calls ist das nicht.
- Terminal-Arbeit: lass sie aus diesem Ranking raus. Nimm das Lab, dessen Runner du wirklich auslieferst, und nimm dann die Zahl dieses Labs. 66,4 % und 38,0 % zu mischen sagt dir nicht, welches Binary du aufrufst.
Häufig gestellte Fragen
Kannst du GPT-6 Astra jetzt auf OpenRouter aufrufen?
Ja, Stand 22:34 UTC am 22. September 2026. Die ID openai/gpt-6-astra lieferte auf der Rechnung 1,96 und ein merge_intervals, das die versteckten Tests bestand. Am 4. September lieferte dieselbe ID HTTP 400. Der frühere Beitrag hält diese 400 fest. Dieser hier hält den Call fest, der funktioniert hat. Auf der Listung lag der Kontext bei 1.050.000 Token.
Hat xAI Grok 4.7 von $2 und $6 gesenkt?
Nicht auf der Launch-Karte, die diese Seite zitiert. Die Tabelle von xAI steht weiter bei $2 und $6 unter 200.000 Prompt-Token, danach bei $4 und $12. Der Katalog von OpenRouter lag in diesem Lauf bei $1.60 und $4.80, danach bei $3.20 und $9.60, das 0,8-Fache dieser Zeilen. Die Rechnung über die sechs Calls nutzt die Zahl von OpenRouter. Was du direkt bei xAI bezahlst, folgt weiter der Karte von xAI, bis xAI sie ändert.
Warum fehlt Grok auf dem Benchmark-Chart von Anthropic?
Grok ist dort keine Spalte. Das Chart von Anthropic vom 22. September stellt Opus 5.5 neben Fable 5.1, Opus 5, GPT-6 Astra und GPT-5.6 Sol. Das Chart von xAI stellt Grok 4.7 neben Grok 4.6, Sol und Fable. Opus 5.5 ist dort keine Spalte. Die Überlappung ist GDPval, weil beide Seiten Fable mit 1.735 und Astra mit 1.542 nennen.
Sagt das Sechs-Call-Meter, dass Opus 5.5 klüger ist?
Nein. Alle drei haben beide Aufgaben bestanden. Das Meter ist eine Rechnung und eine Token-Zahl. GDPval ist der Score der Labs, und der setzt Opus 5.5 unter diesen dreien nach vorn, auf 1.846 gegen 1.695 und 1.542. Eine bestandene Merge-Funktion bestätigt 1.846 nicht, und 1.846 sagt die Rechnung von $0.005292 nicht voraus.
Welches Modell hat das kürzere Kontextfenster?
Grok 4.7, mit 500.000 Token auf der OpenRouter-Listung. Opus 5.5 liegt bei 1.000.000. Astra liegt bei 1.050.000. Grok setzt den Preis ab 200.000 Prompt-Token für die ganze Anfrage neu an, das günstige Fenster ist also kleiner als 500.000. Der höhere Satz von Astra beginnt bei 272.000 und gilt für die Token über dieser Linie, plus ein Output-Multiplikator von 1,5×.