Claude Opus 5.5: Preise von $4/$20, die Limits und was wir gemessen haben
Claude Opus 5.5 ist am 22. September 2026 live gegangen, zu $4 je Million Input-Token und $20 je Million Output-Token. Cache-Reads kosten $0.20. Das sind 20 % weniger als bei Claude Opus 5 beim Input und beim Output, und 60 % weniger bei den Cache-Reads ($0.50). Die ID auf der Plattform lautet claude-opus-5-5. OpenRouter listete anthropic/claude-opus-5.5 um 18:57 UTC schon, dieselben drei Preise, Kontext 1.000.000 Token.
Neun bewertete Calls gingen zwischen 18:57 und 18:58 UTC raus. Acht davon liefen gegen Opus 5, auf effort=low. Alle acht bestanden. Opus 5.5 hat $0.010564 abgerechnet. Opus 5 hat $0.01269 abgerechnet.
Ein neunter Call, Opus 5.5 auf effort=high, bestand ebenfalls und kostete $0.003936. Summe des Laufs: $0.02719. Das Cover ist Anthropics Chart von der Launch-Seite, unverändert gespeichert.
API-Preis von Claude Opus 5.5 gegen Opus 5
Bei Traffic mit viel Cache ändert die neue Preiskarte die Rechnung. Ungecachte Calls fielen in unserer Messung nur um etwa 20 %.
Die Launch-Tabelle von Anthropic, unten wiedergegeben und im Preis-Screenshot, ist die Standardkarte. Fable 5.1 bleibt bei $10/$50. Der Cache-Read liegt bei $0.25, Opus 5.5 unterbietet Fable dort also um $0.05 je Million, nicht um die Hälfte. Der Faktor 2,5 gilt für Input und Output: $10 gegen $4 und $50 gegen $20.
| Zeile, je 1 Mio. Token | Opus 5.5 | Opus 5 | Fable 5.1 |
|---|---|---|---|
| Input | $4 | $5 | $10 |
| Output | $20 | $25 | $50 |
| Cache-Read | $0.20 | $0.50 | $0.25 |
| Cache-Write, 5 Min. | $5 | $6.25 | $12.50 |
| Cache-Write, 1 Stunde | $8 | $10 | $20 |
| OpenRouter-Batch, Input / Output | $2 / $10 | $2.50 / $12.50 | $5 / $25 |
| Fast-Modus, Input / Output | $8 / $40 | nicht auf dieser Karte | nicht auf dieser Karte |
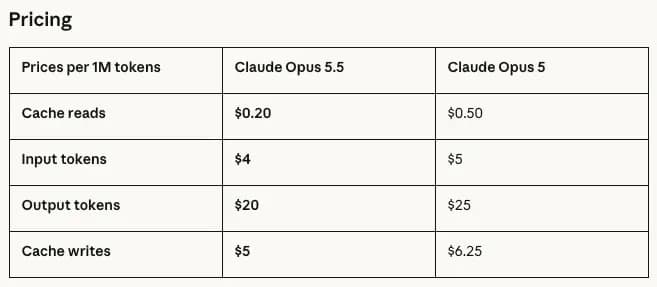
Der Cache-Write über 5 Minuten ($5 gegen $6.25) steht auf der Seite von Anthropic und in der Notiz von Artificial Analysis.
Der Cache-Write über 1 Stunde ($8) und die Batch-Route ($2/$10, Cache-Read $0.10) kommen aus dem Payload von OpenRouter unter /api/v1/models, Stand 18:57 UTC. Die Launch-Tabelle druckt diese Zeilen nicht.
Der Fast-Modus steht auf der Launch-Seite: bis zur 2,5-fachen Geschwindigkeit, zu $8 und $40. Das ist das Doppelte des Standardpreises von Opus 5.5 und liegt über den $5/$25 von Opus 5.
Neun bewertete Calls und die Rechnung dazu
Alle 8 gematchten Calls bestanden. Opus 5.5 kostete $0.010564 und Opus 5 $0.01269. Der Abschlag liegt bei 16,8 %.
Chat Completions bei OpenRouter. Keine Temperature. reasoning.effort stand auf low, dazu ein Coding-Call auf high.
Zwei Aufgaben, zwei Durchgänge. Geprüft haben Exact Match und ausgeführte Tests. Gecachte Token: 0. Prompts für die Rechnung: 104 Token.
# 22 Sep 2026, 18:57 UTC, OpenRouter
MODELS = ["anthropic/claude-opus-5.5", "anthropic/claude-opus-5"]
# invoice answer must be 1.96
# 800_000 * 0.20/1e6 + 200_000 * 4/1e6 + 50_000 * 20/1e6
# coding: merge_intervals, hidden tests, function only| Set | Opus 5.5 | Opus 5 |
|---|---|---|
| Rechnung, 2 Durchgänge | 2/2, $0.002652, 45 und 46 Output, 3,089 s und 5,100 s | 2/2, $0.00332, 46 und 46 Output, 6,765 s und 3,997 s |
| merge_intervals, 2 Durchgänge | 2/2, $0.007912, 168 und 168 Output, 3,597 s und 3,239 s | 2/2, $0.00937, 161 und 155 Output, 3,435 s und 3,582 s |
| Gematchte Summe | $0.010564, 8/8 | $0.01269, 8/8 |
| effort=high, 1 Coding-Call | bestanden, $0.003936, 167 Output, 0 Reasoning-Token | nicht gelaufen |
Das Rechnungspaar ist der saubere Fall nahe an 20 %: 20,1 % günstiger, die Completion-Zahl fast gleich. Das Funktionspaar verfehlt die 20 %: Opus 5.5 hat 336 Completion-Token geschrieben, Opus 5 dagegen 316, und die Rechnung sank nur um 15,6 %. Der Listenpreis fiel um 20 %. Die Tokenzahl stieg. Die Nettoersparnis schrumpfte. effort=high hat diese Funktion nicht verlängert: 167 Completion-Token, 0 Reasoning-Token, $0.003936, Tests bestanden. Artificial Analysis sah das andere Regime, etwa 119.000 Output-Token je Aufgabe im Intelligence Index auf max gegen etwa 73.000 bei Opus 5, bei Kosten je Aufgabe, die trotzdem gleich blieben. Buch dort keinen Rabatt von 40 % ein. Unsere 9 Calls haben dieses Regime nicht erreicht.
Die Latenz ist auf dieser Stichprobe unentschieden. Mittel beim Coding: 3,42 s und 3,51 s. Mittel bei der Rechnung: 4,09 s und 5,38 s. Die Spannen überlappen: 5,100 s gegen 3,997 s.
Anthropic sagt, der Output sei mehr als 30 % schneller als bei Opus 5. Diese 9 Calls zeigen das nicht.
Wo Anthropics Chart führt und wo nicht
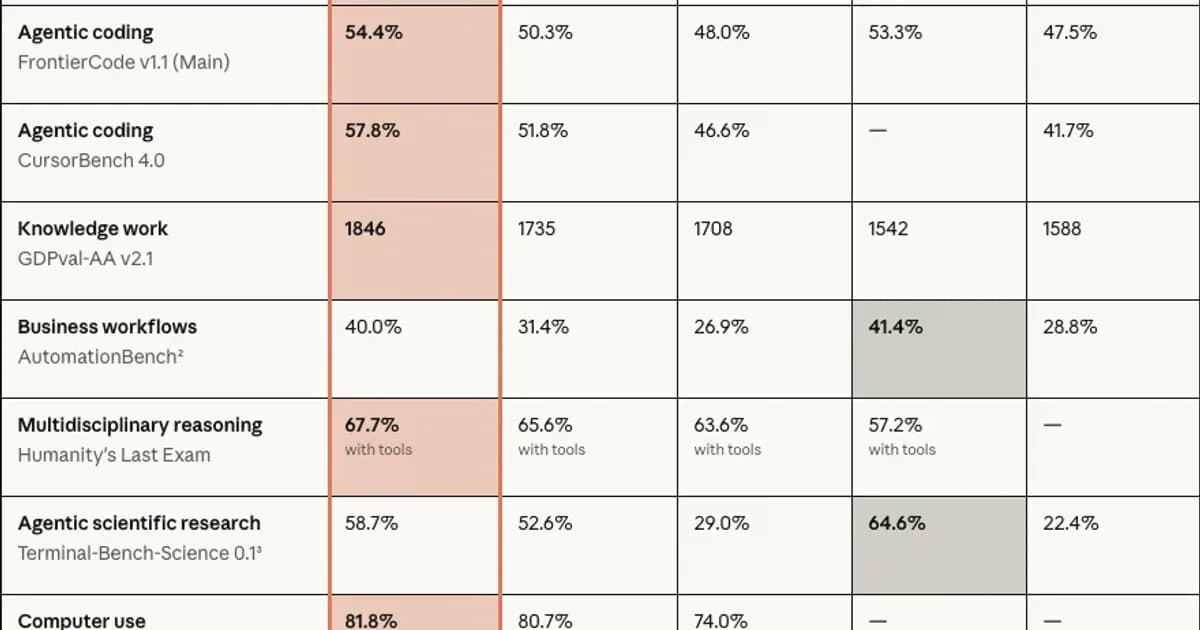
Astra führt zwei nummerierte Zeilen an: AutomationBench mit 41,4 % und Terminal-Bench-Science mit 64,6 %.
Jede andere nummerierte Zelle auf dem Chart vom 22. September geht an Opus 5.5. Das Titelbild ist dieses Chart. Die Zellen darunter sind davon abgeschrieben.
Anthropic sagt, diese Zahlen für Opus 5.5 nutzen adaptives Thinking auf max Effort, mit einem Vermerk: Terminal-Bench 4.0 ist Opus 5.5 auf xhigh und GPT-6 Astra auf high, der Wert von Astra so, wie OpenAI ihn gemeldet hat.
| Benchmark | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 66,4 % | 55,8 % | 52,3 % | 57,9 % | 37,3 % |
| FrontierCode v1.1 (Main) | 54,4 % | 50,3 % | 48,0 % | 53,3 % | 47,5 % |
| CursorBench 4.0 | 57,8 % | 51,8 % | 46,6 % | n/a | 41,7 % |
| GDPval-AA v2.1 | 1846 | 1735 | 1708 | 1542 | 1588 |
| AutomationBench | 40,0 % | 31,4 % | 26,9 % | 41,4 % | 28,8 % |
| Humanity's Last Exam, mit Tools | 67,7 % | 65,6 % | 63,6 % | 57,2 % | n/a |
| Terminal-Bench-Science 0.1 | 58,7 % | 52,6 % | 29,0 % | 64,6 % | 22,4 % |
| OSWorld 2.0, teilweise | 81,8 % | 80,7 % | 74,0 % | n/a | n/a |
| Chartography, mit Tools | 89,0 % | 88,4 % | 83,4 % | n/a | n/a |
Lies die Fußnoten, bevor du wegen eines einzelnen Punkts das Routing änderst.
- Die Safeguards blieben an. Der Cyber-Fallback war Opus 4.8. Der Fallback für Biologie und Frontier-LLMs war Opus 5. Anthropic sagt, das senke den Score wahrscheinlich.
- Zapier hat AutomationBench ohne Fallback gefahren, ein Eingriff zählte also als Fehlversuch. 40,0 % ist Early Access. Die 41,4 % von Astra sind das öffentliche Board.
- Die Fehlerangabe bei Terminal-Bench 4.0 beträgt ±2,6 Punkte. 66,4 gegen 57,9 liegt außerhalb davon. FrontierCode mit 54,4 gegen 53,3 nicht.
- Anthropic sagt, der Abstand im Alltag zu Fable 5.1 sei enger als auf diesem Chart.
- Artificial Analysis, derselbe Tag, anderes Setup: Terminal-Bench 4.0 bei 59,6 %, gleichauf mit Astra auf xhigh, und Humanity's Last Exam bei 61,4 % gegen 59,1 % für Fable 5.1. Zieh aus 66,4 und 59,6 keinen Mittelwert.
Der Default-Effort ist eine andere Zeile. FrontierCode auf medium liegt bei 54,6 %. CursorBench auf medium liegt bei 52,5 %, nicht bei den 57,8 % oben. Anthropic sagt, dieser FrontierCode-Wert auf medium schlage den besten Wert von Astra bei etwa einem Fünftel der Kosten je Aufgabe.
Limits, die der Preis von $4 nicht aufhebt
Cyber-Aufgaben werden auf Opus 4.8 umgeleitet, und Thinking bleibt auf jedem API-Konto an.
Die günstigere Karte hat die Einschränkungen nicht gelöscht, die die letzten beiden Claude-Launches im Betrieb sperrig gemacht haben. Was sich am 22. September geändert hat und was nicht:
- Die Fünf-Stunden-Limits steigen auf Pro, Max, Team und sitzbasiertes Enterprise, dazu ein Reset, den du speichern kannst. Eine neue Nachrichtenzahl gibt es nicht. Das Wochenlimit wird nicht als gestrichen beschrieben. Die älteren Fensterregeln stehen im Beitrag zu den Nutzungslimits.
- Safeguards für Cyber, Biologie und Distillation entsprechen der Fable-Klasse. Alltägliches Bugfixing bleibt. Die meisten Cyber-Aufgaben laufen auf Opus 4.8 um. Biologie braucht das Life Sciences Verification Program. Das breitere Cyber-Programm war am Launch-Tag nicht offen.
- Thinking lässt sich nicht abschalten. Die Launch-Seite verweist für diese Sperre auf die Modell-Docs. Preserved Thinking, die Kontrolle gegen Distillation aus Fable 5.1, hindert API-Nutzer daran, früheres Reasoning zu bearbeiten. Das gilt für Opus 5.5 auf API-Konten, die am 31. August 2026 oder später angelegt wurden.
- Das Modell trägt ein Wasserzeichen für den EU AI Act. Zero Data Retention bleibt im Angebot, wie bei den früheren Opus-Modellen.
- Versuche, die Containment-Grenze zu überschreiten, gingen laut Anthropic um etwa 85 % gegenüber Opus 5 und Mythos 5.1 zurück. Der Rest war von niedriger Schwere und selbst gemeldet. Das Modell vermutet oft eine Eval, diese Prüfung sagt die Produktion also schlecht voraus.
- Sonnet 5.5 und Haiku 5.5 sind heute nicht in der API. Auf der Seite steht, sie kommen in den nächsten Wochen. Ein Datum fehlt.
Wenn du Offensive Security oder Wet-Lab-Design fährst, ist der Preis von $4 nicht der Preis für ein Opus 5.5 ohne diese Sperren. Der Classifier legt einen Teil dieser Calls auf ein älteres Modell. In deinem Trace muss der Fallback stehen, sonst rechnest du die falsche ID ab.
Was frühe Tester Anthropic gesagt haben
GitHub, Optiver und Box melden weniger Token als Opus 5. Diese Zeilen sind Zitate, die Anthropic veröffentlicht hat.
Das sind signierte Notizen aus dem Early Access, kein unabhängiges Board. @claudeai hat um 16:31 UTC gepostet. Antworten aus derselben Stunde lobten den Puffer auf Pro und das Debugging. Einen gemeinsamen Trace hat niemand geteilt.
| Wer, auf der Launch-Seite | Was gesagt wurde | Was es nicht belegt |
|---|---|---|
| Mario Rodriguez, GitHub | Die wenigsten Token aus der eigenen Messung. Terminalaufgaben in VS Code in weniger als der Hälfte der Schritte von Opus 5. | Kein öffentliches Log. |
| Noyan Tokgozoglu, Optiver | Qualität von Opus 5 in etwa der Hälfte der Turns, der Zeit und der Output-Token. Kosten um 40 % bis 50 % niedriger. | Der Desk von Optiver. Unser Abschlag lag bei 16,8 %, Cache bei 0. |
| Yashodha Bhavnani, Box | Ein Drittel der Token, 40 % weniger wortreich, die Genauigkeit blieb. | Die Eval von Box. |
| Zimu Li, Factory | Medium entsprach Opus 5 auf high, mit 20 % bis 25 % weniger Output-Token. | Unser Pin auf high hat die Token nicht gesenkt. |
| Fabian Hedin, Lovable | Ein Drittel bis die Hälfte weniger Schritte, und weniger Token. | Die Schleife von Lovable, nicht die API-Karte. |
Die Zitate beschreiben weniger Schritte und weniger Token, einen größeren Abschlag als 20 % unter dem Listenpreis. Unsere Funktion lief andersherum: 336 Completion-Token gegen 316.
Beides kann stimmen. Anthropic sagt, ein Audit über 200.000 Zeilen sei in unter 3 Stunden fertig gewesen, gegen über 20 Stunden bei Opus 5, mit 2,5-mal weniger Token. Wir haben den Lauf nicht wiederholt.
Was ein erneutes Cache-Lesen mit der Rechnung macht
Ein erneutes Lesen von 500.000 Cache-Token fällt von $0.25 bei Opus 5 auf $0.10 bei Opus 5.5.
Gerechnet mit den veröffentlichten Preisen, nicht mit einem der 9 Calls. Diese Calls haben nichts gecacht und zeigen deshalb nur den Abschlag von 20 %, abzüglich der zusätzlichen Token. Setz deine eigene Präfixgröße ein. Der Mix verschiebt den Prozentwert.
| Last | Opus 5 | Opus 5.5 | Änderung |
|---|---|---|---|
| 500.000 Cache-Read-Token | $0.25 | $0.10 | 60 % |
| 20.000 frischer Input + 8.000 Output, ohne Cache | $0.30 | $0.24 | 20 % |
| 500.000 Cache + 20.000 In + 8.000 Out | $0.55 | $0.34 | 38 % |
| Dieselben 20.000 In + 8.000 Out im Fast-Modus zu $8/$40 | n/a | $0.48 | Preisanstieg gegenüber Standard-5.5 |
Die 38 % in der dritten Zeile sind der Weg, wie aus 20 % weniger Token „etwa 40 % weniger bei typischen Lasten“ wird: ein Agent mit viel Cache, Default-Einstellungen, dazu weniger Token. Ohne den Cache bist du wieder bei 20 %, bis das Modell mehr ausgibt. Der Fast-Modus läuft in die andere Richtung, $0.48 gegen $0.24 auf dem Anteil ohne Cache. Die Batch-Zeile in der Preistabelle ($2/$10) ist ein Katalogpreis. Einen Batch-Job haben wir nicht geschickt.
Welche ID du nach dem 22. September pinnst
Pinne claude-opus-5-5 für neuen Agenten-Traffic, außer bei Cyber oder Biologie.
Der Opus-5-Text vom Juli hat ein Modell der Fable-Klasse auf die Hälfte der Token-Preise von Fable gesetzt. Dieser Satz ist seit dem 22. September veraltet.
Opus 5.5 liegt noch einmal 20 % unter den Input- und Output-Preisen von Opus 5 und 60 % unter den Cache-Reads. Die Safeguards folgen jetzt Fable 5.1, nicht der lockereren Opus-Linie. Grok 4.7, am selben Tag gemessen, ist eine andere Preiskarte.
- Ungecachte, kurze API-Calls wie die, die wir bewertet haben: schieb sie auf Opus 5.5. Die Bestehensquote lag gleichauf bei 8/8. Die Rechnung sank auf diesem Set um 16,8 %, und um 20,1 %, wenn die Completion-Zahlen übereinstimmen.
- Agenten-Schleifen, die ein großes Präfix erneut lesen: schieb sie auch um, und kalkuliere näher an den gerechneten 38 % als an den 16,8 % aus der Rechnung. Prüfe, dass
cached_tokensin der Response nicht 0 ist. Sonst bleibst du auf dem Pfad von 20 %. - Research-Evals auf max Effort: behalt das alte Budget von Opus 5, bis du selbst misst. Die Kosten je Aufgabe im Intelligence Index von AA sind mit dem Tokenpreis nicht gesunken.
- Cyber-Offense, Biologie-Forschung, Austesten im Stil von Distillation: rechne nicht damit, dass Opus 5.5 antwortet. Erwartbar sind Opus 4.8 oder Opus 5, oder eine Ablehnung. Die Verification Programs sind die Tür, die Anthropic genannt hat.
- Fast-Modus: zahl $8/$40 nur, wenn die 2,5-fache Geschwindigkeit den doppelten Tokenpreis wert ist. Das ist nicht die günstige Stufe.
- Lass Fable 5.1 nur dort gepinnt, wo du eine Qualitätslücke gemessen hast, die diese 9 Calls nicht sehen. Fable kostet das 2,5-Fache bei Input und Output. Die Cache-Reads liegen bei $0.25 gegen $0.20.
Häufig gestellte Fragen
Wie lautet die API-Modell-ID von Claude Opus 5.5?
Auf der Claude Platform lautet die ID claude-opus-5-5. Auf OpenRouter lautet sie anthropic/claude-opus-5.5, der Batch anthropic/claude-opus-5.5:batch. Wir haben die Standard-ID am 22. September 2026 um 18:57 UTC aufgerufen. Gelisteter Kontext: 1.000.000 Token. Der Fast-Modus ist ein Preis ($8/$40), keine zweite ID auf der Launch-Seite.
Hebt Claude Opus 5.5 das Fünf-Stunden-Limit auf?
Nein. Das Fünf-Stunden-Limit steigt auf Pro, Max, Team und sitzbasiertes Enterprise, und ein Reset lässt sich speichern. Eine Nachrichtenzahl wurde nicht veröffentlicht. Das Wochenlimit gilt nicht als entfernt. Die API-Limits in Token je Minute sind ein eigener Zähler. Schau unter Settings, dann unter Usage.
Lässt sich Thinking bei Opus 5.5 abschalten?
Anthropic sagt nein. Die Seite vom 22. September sagt, Thinking lasse sich nicht mehr abschalten. Preserved Thinking sperrt zusätzlich Konten, die am 31. August 2026 oder später angelegt wurden, gegen das Bearbeiten von früherem Reasoning. Unser Call auf effort=high lieferte trotzdem eine normale Funktion, mit 0 Reasoning-Token im Usage-Objekt von OpenRouter. Ein Pin auf high ist keine sichtbare Gedankenkette.
Gilt der Abschlag von 40 % für jede Last?
Bei uns nicht. Acht ungecachte Calls kosteten 16,8 % weniger. Das Rechnungspaar allein kostete 20,1 % weniger. Ein gerechneter Mix aus 500.000 Cache-Read-Token plus einer kurzen Completion landet bei 38 %. Artificial Analysis sagt, Aufgaben im Intelligence Index auf max Effort kosten etwa so viel wie bei Opus 5, weil die Output-Token auf etwa das 1,6-Fache gestiegen sind.
Wann erscheinen Claude Sonnet 5.5 und Haiku 5.5?
Anthropic hat auf der Seite vom 22. September 2026 gesagt, beide folgen in den kommenden Wochen, ohne Datum. Opus 5.5 war an dem Abend die einzige 5.5-ID, die wir aufrufen konnten. Günstiger außerhalb von Opus bleibt die bisherige Karte von Sonnet oder Haiku.